作者:黃俊凱 Gask Hung|發布:2026-08-06|最後更新:2026-09-16
企業要在自己的機器上跑 Qwen,2026 年下半年只剩兩個選擇:單張 24GB 顯卡跑 Qwen3.8-27B,或是準備 96GB 以上顯存跑 Qwen3.8-Flash-Next。中間沒有折衷方案。27B 是目前消費級硬體跑得動的最強模型,量化之後 16GB 顯卡也能動;再往上就直接跳到 1,250 億參數,硬體預算差好幾倍。Qwen3.8-Max 不開源,只能走 API。這篇整理版本差異、顯存門檻、量化取捨與社群實測,幫你決定要不要自己養這台機器。
📋 本文重點摘要
- Qwen3.8-27B 與前一代 Qwen3.6-27B 架構完全相同,進步來自訓練方法,不是換了新設計。
- 顯存門檻:Q4 量化約 17GB,24GB 顯卡最穩;壓到 IQ3_XXS 約 11GB,16GB 顯卡實測每秒約 50 token。
- 27B 之後直接跳到 Flash-Next(1,250 億參數),Q4 量化需要約 96GB,中間沒有適合的尺寸。
- 評測分數高不等於划算:同一份數學評測,27B 分數最高,花費卻是 DeepSeek-V4-Flash 的 36 倍。
- 27B 的已知缺點是話多、思考久,指令要寫得比大模型更明確。
👤 適合閱讀對象
- IT 主管:老闆要求資料不能出公司,想知道自己養一台機器要花多少、跑得動什麼。
- 工程與採購:已經決定要買卡,在 24GB 消費卡與專業卡之間猶豫。
- 已在用雲端 API 的團隊:想比較地端 Qwen 與雲端模型的實際差距與成本。
不確定你的環境該選哪個 Qwen 尺寸?加 LINE 傳使用人數、用途與現有設備,我們先幫你初步評估 → 加 LINE 諮詢
本文的數字來自三類來源:知乎上的顯存實測與評測文章、Reddit r/LocalLLaMA 的部署討論與量化發布、X 上模型作者與社群的公開說法。單一使用者的宣稱會標註出處,方便你自行判斷可信度。
一、Qwen3.8 有哪幾個版本?企業只有兩條路可走
能地端部署的只有 Qwen3.8-27B 與 Qwen3.8-Flash-Next,Qwen3.8-Max 不提供權重。27B 是 Dense 模型,所有參數每次都要算;Flash-Next 是混合專家架構,總參數大但每個 token 只啟用一小部分。
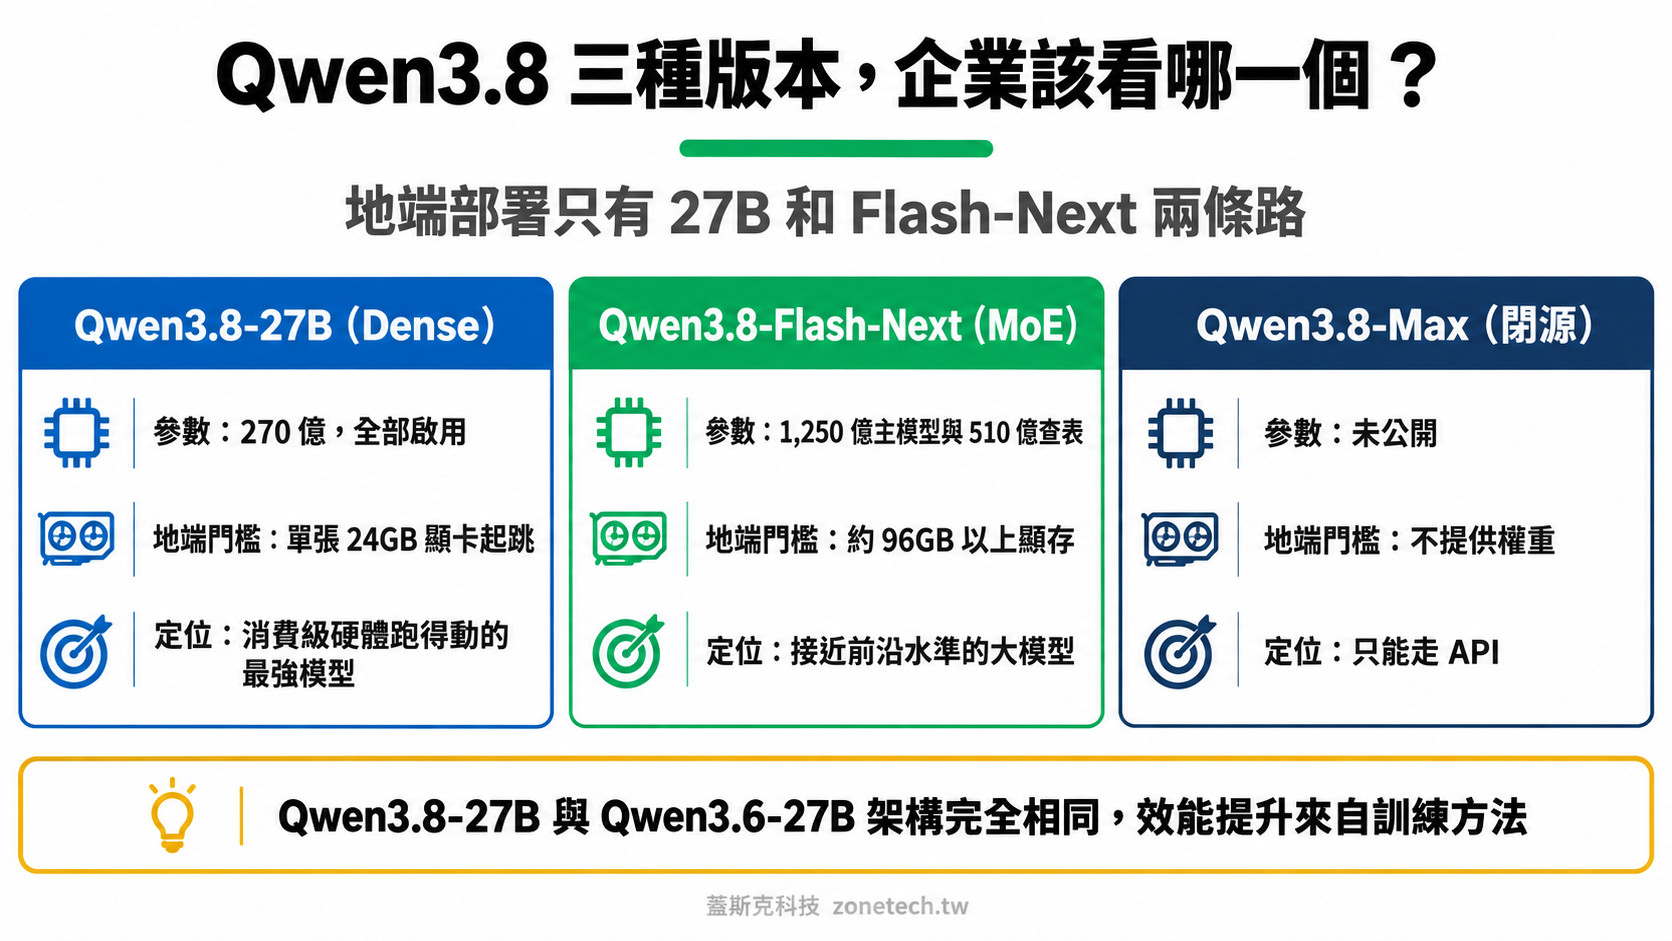
| 版本 | 參數規模 | 地端門檻 | 適合誰 |
|---|---|---|---|
| Qwen3.8-27B | 270 億,Dense 全啟用 | Q4 量化約 17GB,24GB 顯卡最穩 | 想用單張顯卡就開始的中小企業 |
| Qwen3.8-Flash-Next | 1,250 億主模型+510 億查表,每 token 啟用約 60 億 | Q4 量化約 96GB 起 | 已有專業卡或叢集的團隊 |
| Qwen3.8-Max | 未公開 | 不開源,只能走 API | 不在意資料出境的團隊 |
如果你是從前幾代一路看過來的,版本關係可以這樣記:Qwen3.5 與 Qwen3.6 全系列採用 Apache 2.0 授權、可自由商用,是很多企業第一次地端部署時用的版本;2026 年 5 月的 Qwen3.7-Max 只提供 API,不開源;到了 Qwen3.8,開源的是 27B 與 Flash-Next,Max 依舊只走 API。評估時最容易搞混的就是 Max 這條線,看到「Qwen 最新最強」的報導,要先確認講的是不是能下載權重的版本。
有一件事值得先知道:Reddit r/LocalLLaMA 一篇高互動貼文(1,141 讚)比對後發現,Qwen3.8-27B 與 Qwen3.6-27B 的架構檔案完全相同,沒有任何差異,效能提升全部來自訓練方法的改進。留言區的解釋是,小版本更新沿用同一個預訓練基礎,只重做後訓練,成本差很多。對企業的意義是:如果你已經在跑 3.6-27B,換 3.8 不需要重新評估硬體,換權重就好。
二、顯存要準備多少?從 8GB 到 128GB 的對照
要跑 Qwen3.8-27B 的 Q4 量化版,24GB 顯存是實務上的起跳點;16GB 也能跑,但要接受更激進的壓縮。下面這張對照表整理自知乎的顯存速查文章,可以先對照自己手上的卡。
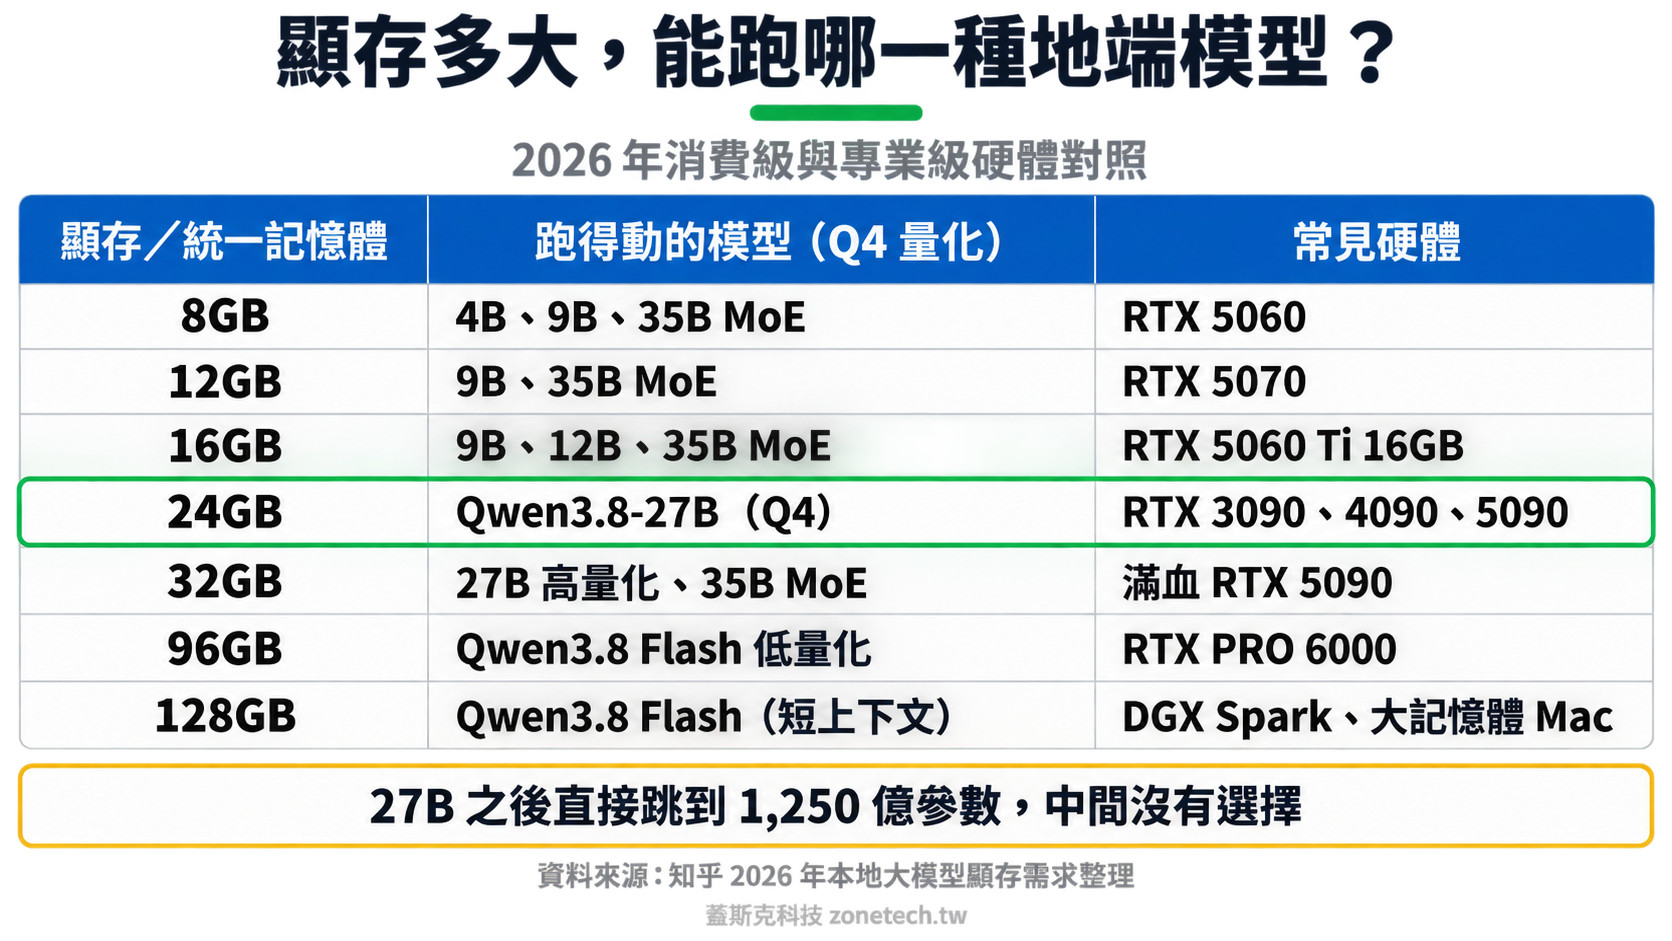
這張表的重點在 27B 之後的斷層。知乎作者的說法是:24GB 以上才跑得動 Q4 量化的 27B,這是消費級硬體能跑的最強本地模型;再往上沒有合適的中間尺寸,下一階直接是 1,250 億參數的 Flash-Next,而它的 Q4 量化需要約 96GB 顯存,門檻高好幾倍。
用買車來比喻會比較好懂:27B 像性能不錯的房車,一般車位停得下、油錢負擔得起;Flash-Next 像遊覽車,載客量完全不同,但你得先有停車場和司機。中間沒有休旅車可以選,這是目前開源模型尺寸分布的現實。
三、量化怎麼選?壓得越狠越省顯存,品質也掉得越多
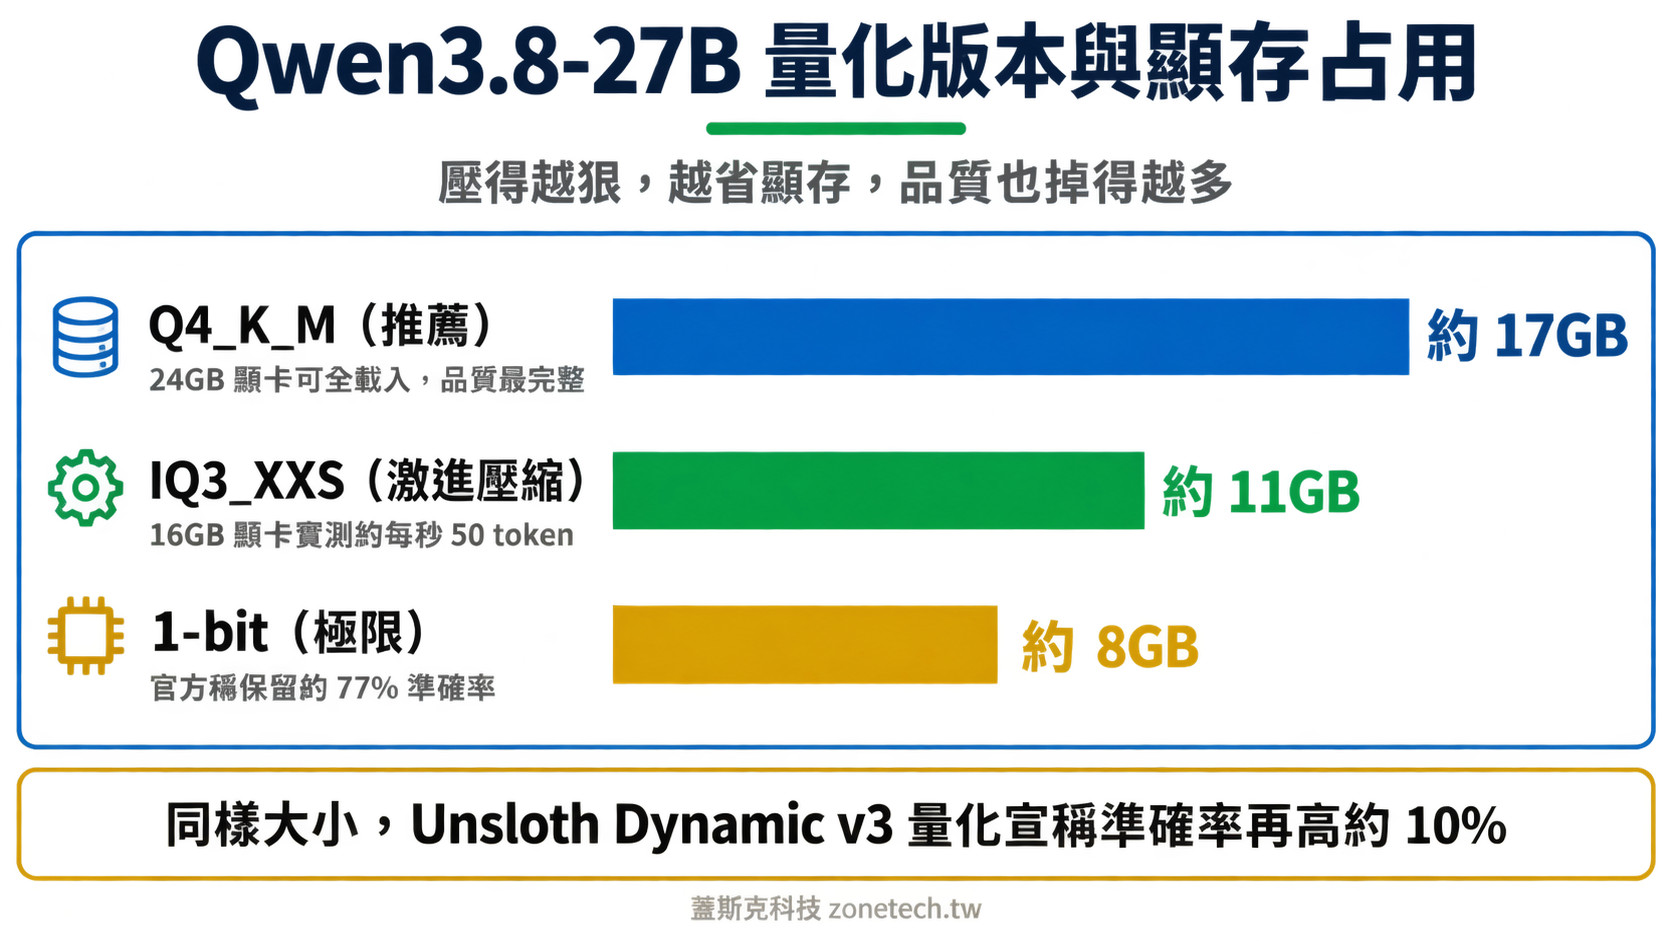
同一個 27B 模型,依量化程度不同,檔案大小可以從約 17GB 壓到 8GB,代價是輸出品質下降。Unsloth 的 Daniel Han 在 Reddit 上證實 Qwen3.8-27B 只需要 17GB 顯存(1,785 讚)就能跑起來。
| 量化版本 | 約略大小 | 適合的卡 | 取捨 |
|---|---|---|---|
| Q4_K_M | 約 17GB | 24GB 顯卡 | 品質最完整,多數團隊的預設選擇 |
| Q3_K_XL | 約 13GB | 16GB 顯卡(搭配量化 KV 快取) | 可換到較長上下文,品質略降 |
| IQ3_XXS | 約 11GB | 16GB 顯卡 | 知乎實測每秒約 50 token,留約 2GB 給執行環境 |
| 1-bit | 約 8GB | 8GB 記憶體也能動 | 官方稱保留約 77% 準確率,只適合測試 |
顯存怎麼算,知乎那篇 16GB 實測寫得很清楚,值得照著算一次。以 16GB 顯卡為例:輔助的草稿模型約 1.1GB,100K 上下文的 KV 快取用 q4_0 量化後約 1.9GB,兩項扣掉之後剩約 13GB。但這 13GB 不能全部拿來放模型,CUDA 本身、運算緩衝與推論程式都要佔一些,所以實際上會把主模型控制在 11GB 左右,留約 2GB 的運行空間。這也是為什麼 16GB 顯卡要選 IQ3_XXS,而不是看起來剛好塞得下的 Q3 版本。
同一篇文章也說明了為什麼不繼續往 12GB、8GB 下探:27B 即使做到 3-bit 量化,常見版本的體積仍在 13GB 左右,再加上草稿模型與 KV 快取就塞不進去了。要用更小的顯卡,實務上得換成參數量更小的模型,而不是硬壓 27B。
量化不是只有壓縮率的差別。Unsloth 在 2026 年 8 月釋出的 Dynamic v3 版本(1,681 讚)宣稱在相同檔案大小下,準確率比其他量化方式高出約 10%,同時釋出保留約 77% 準確率的 1-bit 版本。作者特別說明沒有用校準資料集訓練,也沒有用量化感知訓練。
16GB 顯卡的實際配置可以參考 Reddit 一篇實戰分享(1,035 讚):作者用 Intel N100 搭配 RTX 5060 Ti 16GB,選 Q3_K_XL 量化、KV 快取壓到 q4_1,撐出 73K 上下文,跑完超過 100 萬 token 的程式開發工作。他強調自己的機器 CPU 很弱、PCIe 只有 3.0 x4,所以完全靠顯存內運算。
四、Qwen3.8-27B 真的比得上大模型嗎?
在評測分數上確實接近,但代價是話很多、token 燒得很兇。Reddit r/LocalLLaMA 一篇討論串(1,145 讚)引用 Artificial Analysis 的評測,指出 Qwen3.8-27B 的分數與 DeepSeek V4 和 GPT-5.6 Luna Max 相當接近。
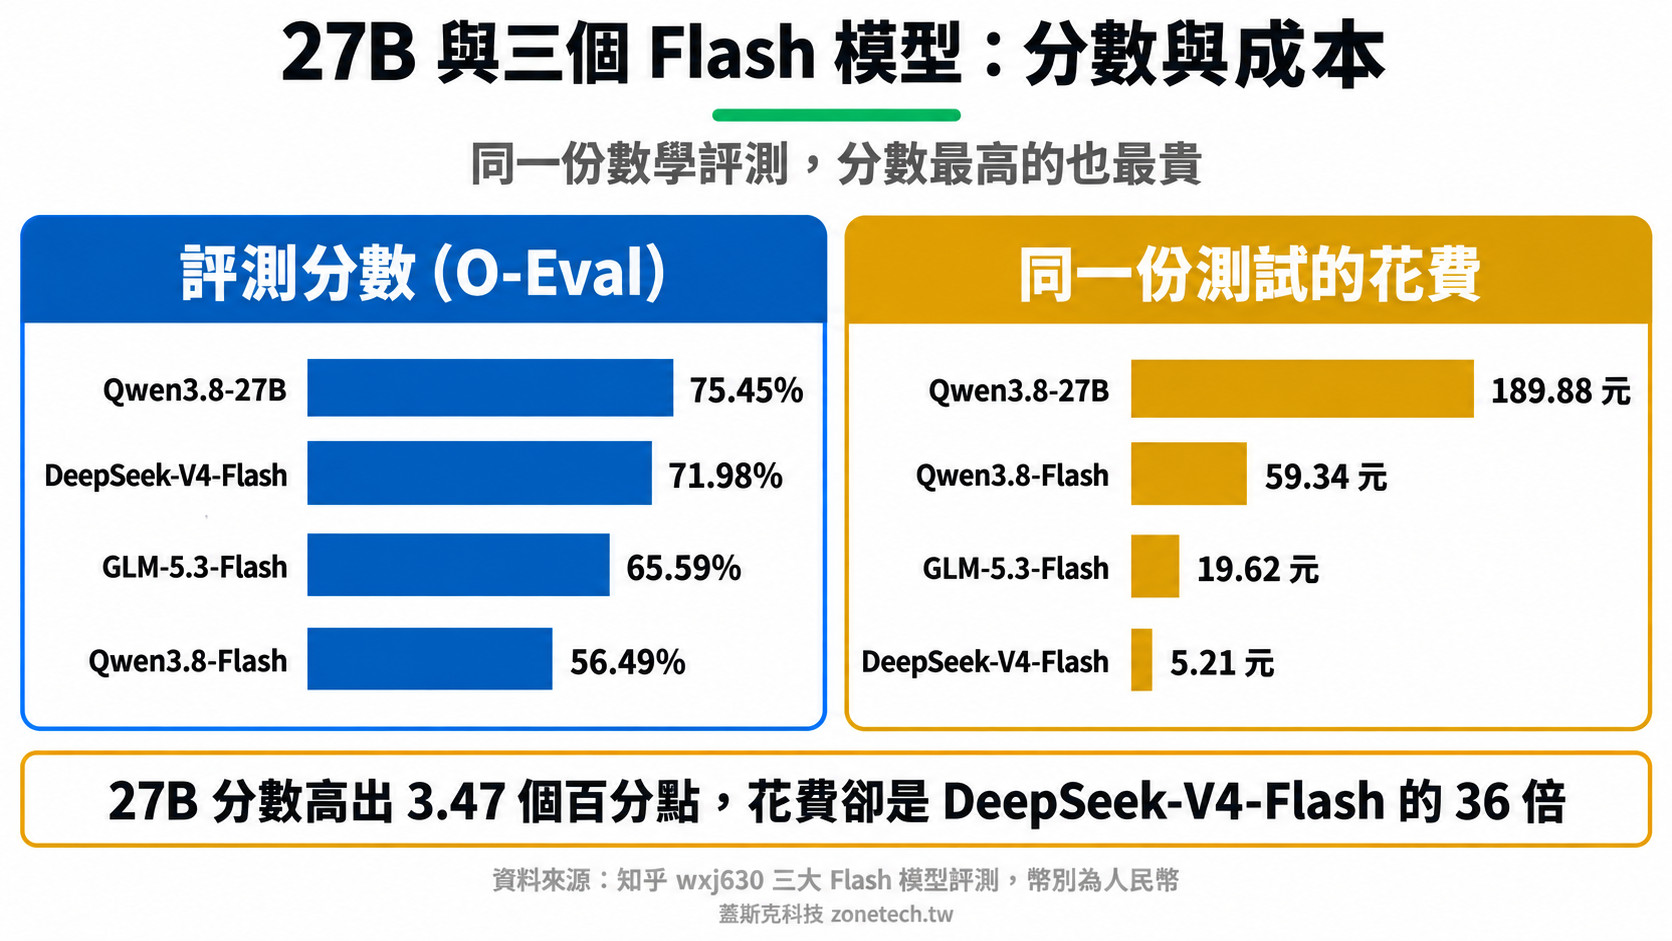
知乎作者 wxj630 用同一份數學評測跑過四個模型,把分數與花費並排之後,落差很清楚:Qwen3.8-27B 的 O-Eval 分數 75.45%,比 DeepSeek-V4-Flash 高 3.47 個百分點,但同一份測試的花費是人民幣 189.88 元,而 DeepSeek-V4-Flash 只要 5.21 元。原因是 27B 是 Dense 模型,每個 token 都要動用全部參數,而且它思考的篇幅特別長。
| 模型 | O-Eval 分數 | 同一份測試花費(人民幣) | 一句話判讀 |
|---|---|---|---|
| Qwen3.8-27B(FP8) | 75.45% | 189.88 元 | 分數最高,花費也最高 |
| DeepSeek-V4-Flash | 71.98% | 5.21 元 | 最穩也最便宜 |
| GLM-5.3-Flash | 65.59% | 19.62 元 | 中間值 |
| Qwen3.8-Flash | 56.49% | 59.34 元 | 最費 token、波動最大 |
Reddit 留言區對這個現象的描述更直白:有使用者指出,同一件事情交給不同等級的模型,指令要寫的細緻度差很多——大模型可以「做 X,用 Y」,27B 這種尺寸則要寫成「照某個檔案裡的規格做 X」,模型才不會自己亂猜。另一則留言提到 27B 的輸出長度與 GLM-5.2 接近,差別在於 GLM 多數人是透過 API 使用感受不到,而 27B 是自己的機器在跑,思考兩小時就是實際佔住兩小時。
看到「某某方法讓 27B 超越前沿模型」這類說法時要多留意。Reddit r/Qwen_AI 一篇貼文(930 讚)宣稱某個外掛框架能讓 Qwen3.8-27B 表現超過大型閉源模型,但留言指出測試方法讓 27B 反覆嘗試、還提供了正確答案對照,而對照組只跑一次,兩邊條件並不對等。
社群實際拿 27B 在做什麼
從討論串看得出來,27B 目前最常見的用途集中在三類:一是程式開發輔助,前面提到的 16GB 顯卡使用者用它跑完整個專案;二是內部文件處理與問答,因為資料不必外傳;三是把它當成大模型的執行端,由較強的模型負責規劃、27B 負責執行。有使用者形容這種搭配「跟前沿模型比起來沒有明顯變差」。
社群也有不少調整過的版本流通,例如去除內容限制的版本、蘋果晶片專用的 MLX 版本,以及各種量化版本。企業使用時要留意來源:這些版本多數由個人或社群團隊發布,沒有原廠的維護承諾,導入前至少要確認發布者、下載次數與是否有人回報異常。
Flash-Next 有機會塞進單張顯卡嗎
X 上有使用者宣稱在單張 24GB 的 RTX 4090 上跑起 Qwen3.8 Flash-Next(1,250 億參數、每 token 啟用 60 億),並開到 25 萬 token 上下文,解碼速度每秒約 21 token、預填每秒約 364 token。這是單一使用者的公開宣稱,沒有第三方複現紀錄,做法上通常需要把大部分權重放在系統記憶體或 SSD,由顯卡只處理啟用的部分。企業評估時建議當成「技術上有人做到」,而不是「這樣買就會有同樣效果」。
五、Apache 2.0 授權對企業的實際意義
Qwen 開源系列採用 Apache 2.0 授權,可以商用、可以改、不必付授權費,也不需要公開你改過的版本。這對企業的價值在於三件事:模型可以裝在自己的機器上、輸出可以用在商業產品、不必擔心供應商哪天調價或停止服務。
要注意的是授權只涵蓋模型權重本身。你用它處理的資料、產出的內容,責任仍在企業自己。醫療、金融、法律這類受監管的場景,仍要自行確認產業規範。模型跑在公司內部,資料沒有送出去,是地端部署最實際的好處;但主機一旦連上網路,就要另外處理網段隔離與對外連線管控,做法可以參考AI 防火牆建置指南。
六、怎麼跑起來:先用 Ollama 試,上線再換 vLLM
評估階段用 Ollama,三個指令就能跑;要給多人同時使用,換成 vLLM 或 SGLang。兩者的差別在於併發處理能力,不是模型品質。
# 1. 安裝(macOS/Linux)
curl -fsSL https://ollama.com/install.sh | sh

# 2. 下載並啟動 Qwen3.8-27B(預設 Q4 量化)
ollama run qwen3.8:27b

# 3. 用 API 呼叫,確認服務正常
curl http://localhost:11434/api/generate -d '{
  "model": "qwen3.8:27b",
  "prompt": "用三句話說明公司導入地端 AI 的好處"
}'
Ollama 的優點是安裝簡單,缺點是多人同時使用時排隊明顯。正式上線建議改用 vLLM:它會把多個請求合併批次處理,同樣一張卡能服務的人數差很多。什麼時候該換、換了之後能撐幾個人,可以參考Ollama 可以上企業生產環境嗎。
vLLM 的啟動方式也不複雜,差別在於它會常駐成一個服務,並提供與 OpenAI 相容的介面,前端工具可以直接接:
# 以 vLLM 啟動 Qwen3.8-27B(單張 24GB 顯卡)
pip install vllm

vllm serve Qwen/Qwen3.8-27B
  --quantization awq
  --max-model-len 32768
  --gpu-memory-utilization 0.92
--port 8000幾個參數值得先理解:--max-model-len 決定上下文長度,開越大吃越多顯存;--gpu-memory-utilization 是允許 vLLM 使用的顯存比例,留一點餘裕給系統比較安全。多人同時使用時,vLLM 會自動把請求排進同一批運算,這是它跟 Ollama 最大的差別。
16GB 顯卡要壓榨性能的話,llama.cpp 的調校空間比較大。前面提到的 Reddit 實戰分享就是用 llama.cpp,搭配量化 KV 快取與推測解碼,才在 16GB 上撐出 73K 上下文。這類調校需要花時間試參數,評估階段不必一開始就做。
七、哪些企業場景適合地端 Qwen?
資料不能出公司、用量穩定、需求集中在文件處理與內部問答的場景,地端最划算。反過來說,用量很少或需求尖峰落差大的公司,用 API 反而便宜。
| 場景 | 為什麼適合地端 | 建議配置 |
|---|---|---|
| 內部文件問答、知識庫檢索 | 文件含營業秘密,不適合上傳雲端 | 27B Q4+單張 24GB 顯卡 |
| 客戶資料整理、報表摘要 | 涉及個資,受法規約束 | 27B Q4+獨立網段 |
| 程式開發輔助 | 原始碼外流風險高 | 27B+長上下文設定 |
| 全公司共用的 AI 服務 | 併發需求高,API 費用會失控 | 專業卡或多機叢集,改跑 Flash-Next |
| 偶爾用一下的小型團隊 | 用量低,養機器不划算 | 直接用雲端 API |
中文表現與 DeepSeek 怎麼選
兩個模型的中文能力都夠用,差別在硬體門檻與輸出風格。Qwen 由阿里巴巴訓練,中文語料比例高,處理繁體中文的公文、報價單、會議紀錄時不太需要特別調整提示詞;DeepSeek 的 Flash 系列在同樣的評測裡分數接近,token 花費低很多,但地端要跑起來需要的記憶體是另一個量級。
實務上的分界線很清楚:手上只有一兩張消費級顯卡,選 Qwen3.8-27B;已經有專業卡、DGX Spark 這類設備或打算做叢集,才有條件把 DeepSeek V4 Flash 這種尺寸放進來比較。兩個都想測的話,建議拿公司最常做的 10 到 20 個任務,同一批題目各跑一次再決定。
八、要不要自己養這台機器?決策流程
先問資料能不能出去,再問幾個人要用,最後才選硬體。順序顛倒的話,很容易買了卡才發現規格不對。
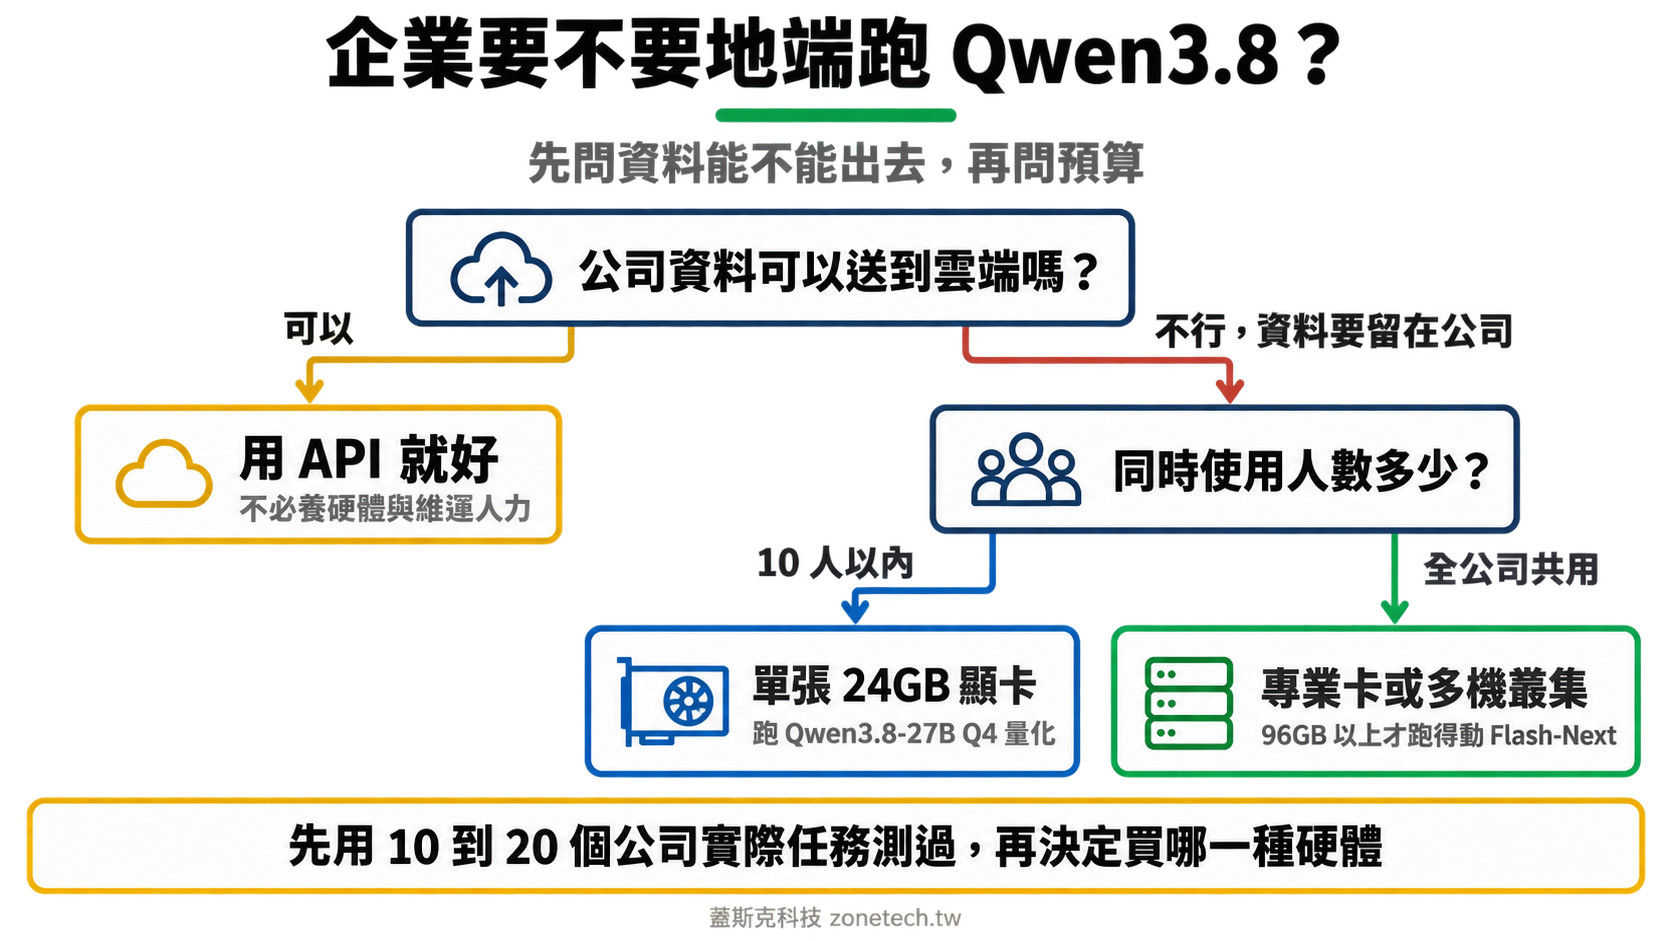
硬體選型的細節,單卡與多卡的差異可以看單卡 vs 多卡企業推理選型;DGX Spark、Mac Studio 與自組主機的比較,可以看地端 LLM 主機大車拼。整套建置流程與費用結構,則整理在地端 LLM 建置完整指南。
模型選擇上,如果你的使用情境以中文長文件為主,也值得把 DeepSeek 地端部署放進來一起比。前面那張分數與成本對照已經說明,分數高的模型不一定是最划算的選擇,實際上還是要拿自己公司的任務去測。
九、企業導入最常見的四個誤判
多數失敗的評估不是敗在模型不夠強,而是一開始就把問題問錯。下表整理社群討論與實際導入時最常見的狀況。
| 誤判 | 實際情況 | 建議做法 |
|---|---|---|
| 參數愈大愈好 | 27B 與 Flash-Next 中間沒有選項,硬體預算差好幾倍 | 先確認任務需要的品質,再回推硬體 |
| 看評測分數挑模型 | 分數最高的模型 token 花費可能是別人的數十倍 | 用公司自己的任務測,同時記錄耗時與用量 |
| 買了卡才發現上下文不夠 | 顯存要同時裝模型與 KV 快取,開長上下文會吃掉空間 | 先估算常用的文件長度,再決定量化版本 |
| 裝好就直接連內網使用 | 推論主機通常要能連外下載模型,容易被忽略 | AI 主機獨立網段,只放行必要的對外連線 |
最後一項是實務上最容易出事的地方。模型跑在自己公司,資料確實沒有離開,但主機本身為了下載模型與更新套件通常要能連上網路,這條路徑如果沒有管控,等於在內網開了一個對外出口。網段怎麼切、防火牆規則怎麼寫,可以照AI 防火牆建置指南的做法處理。
結論
Qwen3.8-27B 把「自己養一台 AI 主機」的門檻壓到單張顯卡,這是 2026 年最大的變化。三個重點帶走:第一,27B 的 Q4 量化約 17GB,24GB 顯卡最穩,16GB 要接受更激進的壓縮與較短的上下文。第二,27B 之後直接跳到 1,250 億參數,沒有中間尺寸,全公司共用的規模要另外規劃硬體。第三,評測分數只是參考,27B 話多、思考久的特性會實際佔住你的機器,導入前用自己的任務測過再決定。
立即開始:把 Qwen 跑在自己的機器上
蓋斯克科技協助台灣企業評估地端 LLM 主機規格、網段隔離與部署流程,從單張顯卡的測試機到全公司共用的推論服務都能協助規劃。
我們提供:
- 依使用人數與任務類型,推算需要的顯存與機器規格
- Qwen、DeepSeek 等開源模型的實測比較與選型建議
- AI 主機的網段隔離、防火牆規則與對外連線管控
- 透明報價,無隱藏費用
想把 AI 留在公司內部,又不確定硬體要買多大?
蓋斯克科技專注台灣中小企業 IT 基礎建設,協助企業把地端 AI 從評估、建置到維運一次做到位。
預約地端 AI 評估 免費預約諮詢電話:02-2717-1019 LINE:@zonetech
關於作者
黃俊凱 Gask Hung|蓋斯克科技創辦人,曾任 D-Link 網路研發工程師、QNAP 雲端儲存應用工程師/專案經理,近期投入地端 LLM 導入評估。完整作者介紹
延伸閱讀:地端 LLM 主機大車拼|LLM 主機規格怎麼抓|DeepSeek 地端部署指南|地端 AI 導入諮詢
參考資料:知乎〈2026 年本地大模型顯存需求表〉、知乎 wxj630〈三大 Flash 模型評測〉、知乎〈5060Ti 16G 本地部署千問 3.8 27B〉|Reddit r/LocalLLaMA:Unsloth 證實 17GB 可跑、3.8 與 3.6 架構相同、Dynamic v3 量化、Artificial Analysis 評測討論、16GB 顯卡實戰配置|資料查詢日 2026-09-16