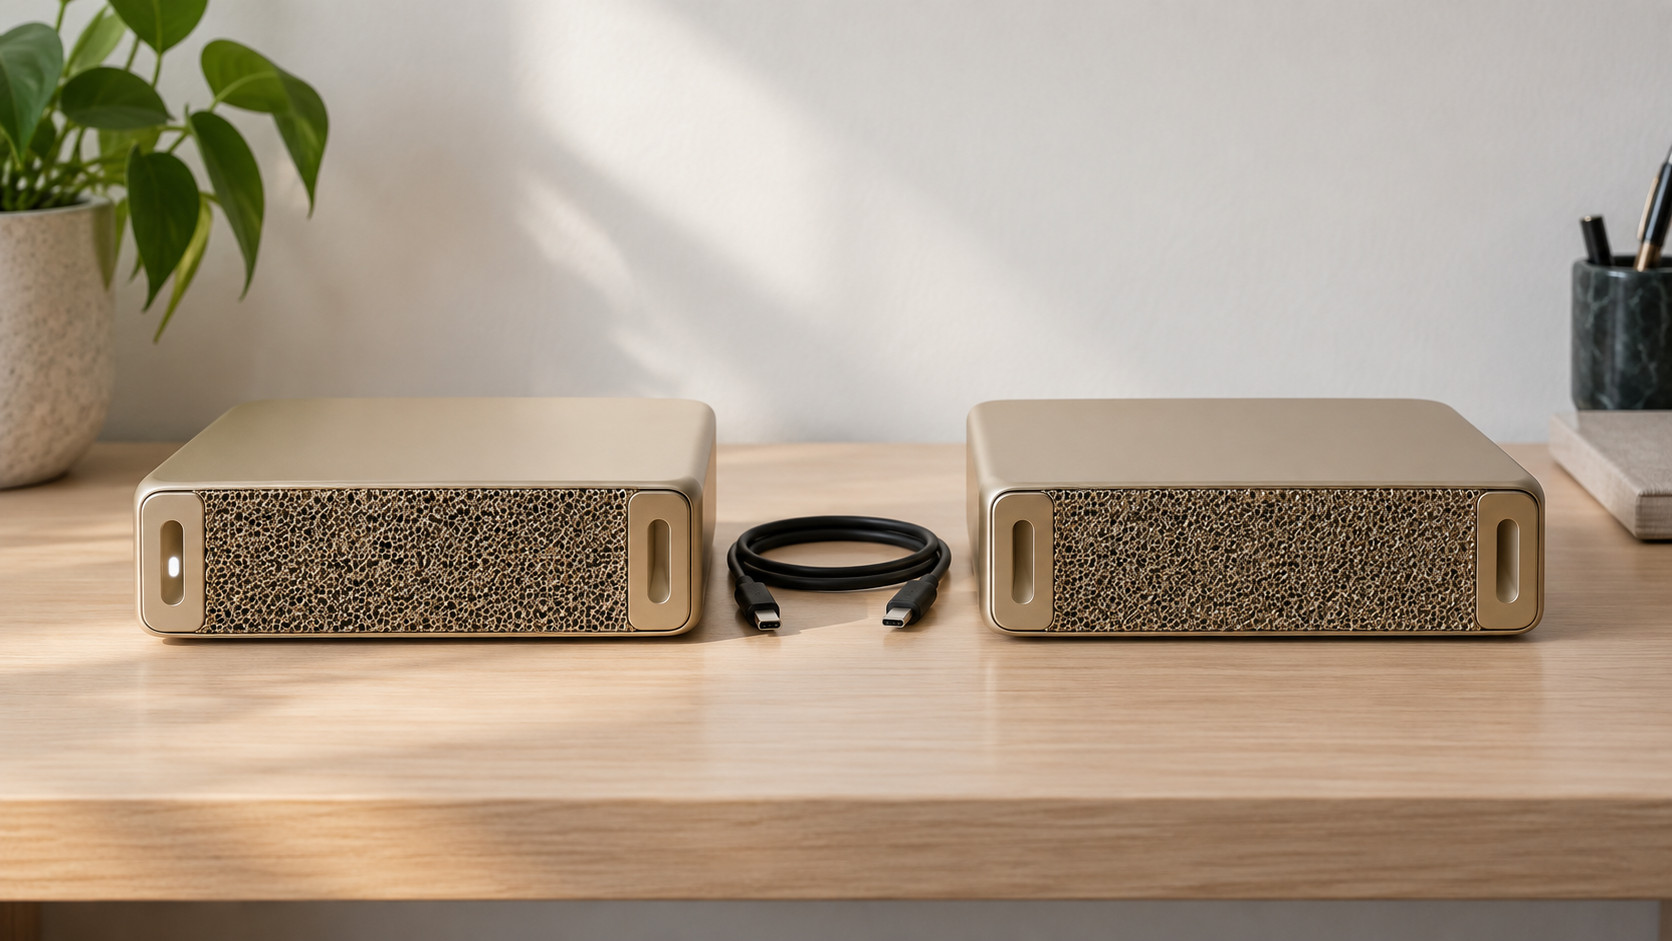
「買一台,還是直接買兩台?」是 DGX Spark 社群裡討論最熱的問題,光是 Reddit 上一篇帖子就有 139 則留言還吵不完。答案不是「兩台當然更好」,而是取決於你跑什麼模型、需要多少 context 長度、能不能接受 token 速度的上限。
這篇把兩種配置的實際效能數字、能跑的模型範圍、成本差距全部比清楚,讓你做決定前有具體數字可以對照。
這篇適合誰看
- 準備買第一台,想知道一台夠不夠用
- 已有一台,考慮加購第二台是否值得
- 主要用途是跑大模型(70B 以上)的開發者
- 需要 600k context 以上 context window 的應用場景
核心差距:一台 vs 兩台跑得了什麼
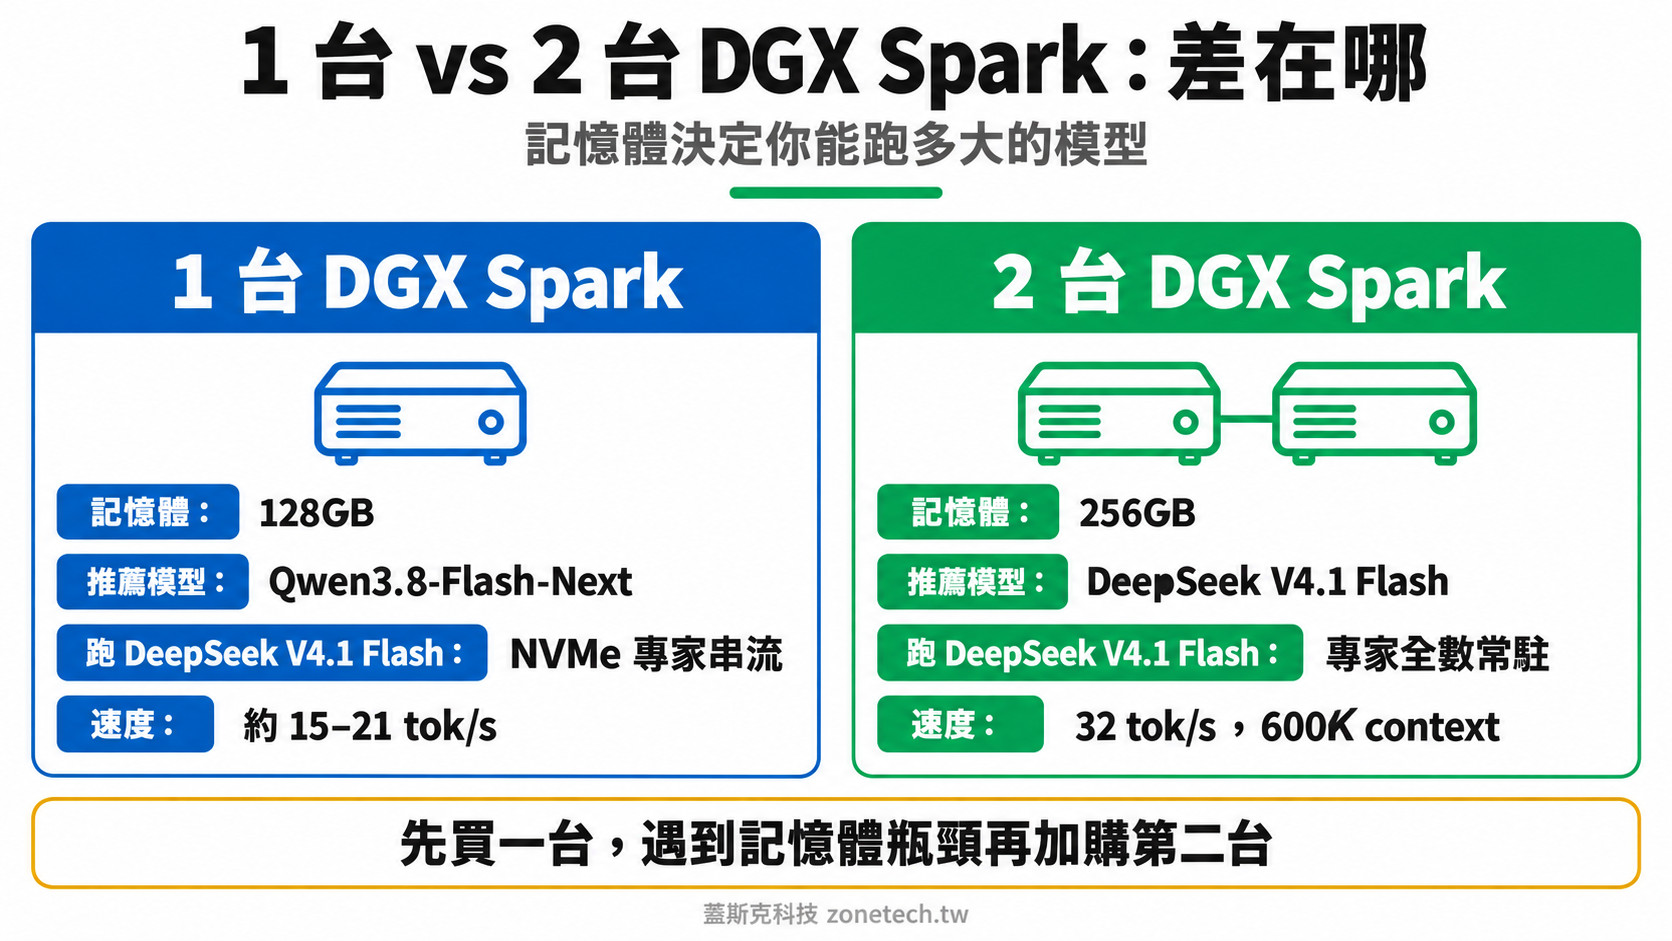
最直接的差別不是速度,是你能跑什麼模型、跑到多長的 context。
| 配置 | 統一記憶體 | 最大可用模型 | DeepSeek V4.1 Flash | context 上限 | 估計月費用 |
|---|---|---|---|---|---|
| 1x DGX Spark | 128 GB | Qwen3.8-Flash-Next (125B A6B) | 需 NVMe expert offload | 依設定(專家串流可到 256K) | 約 NT$199,000(一次性) |
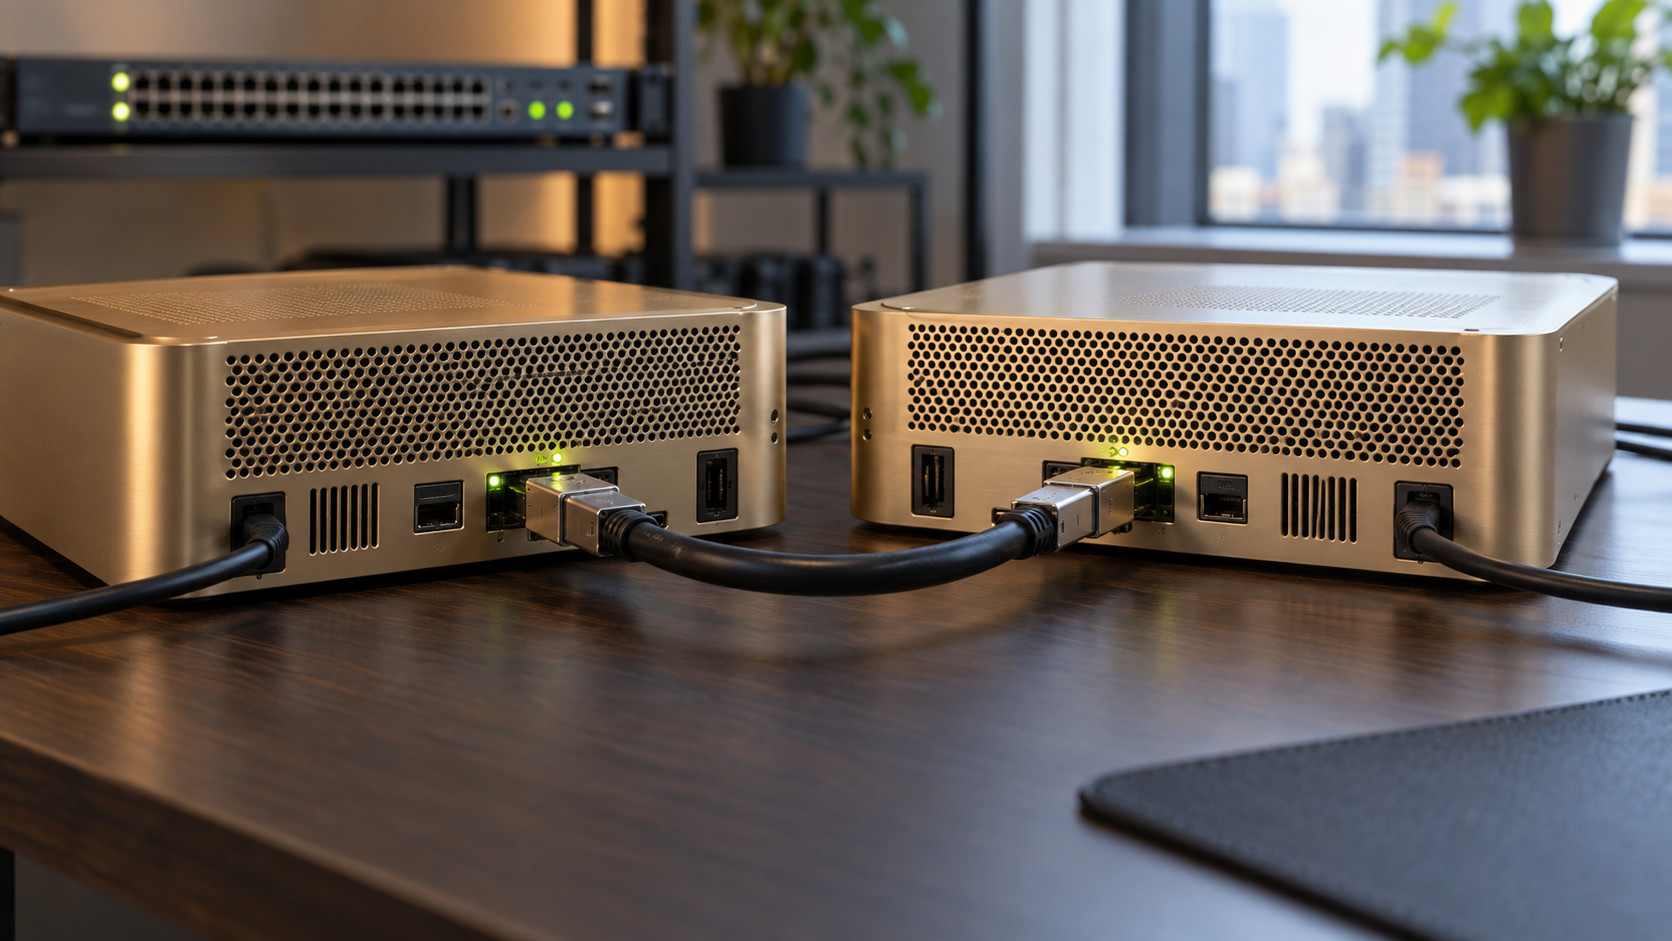
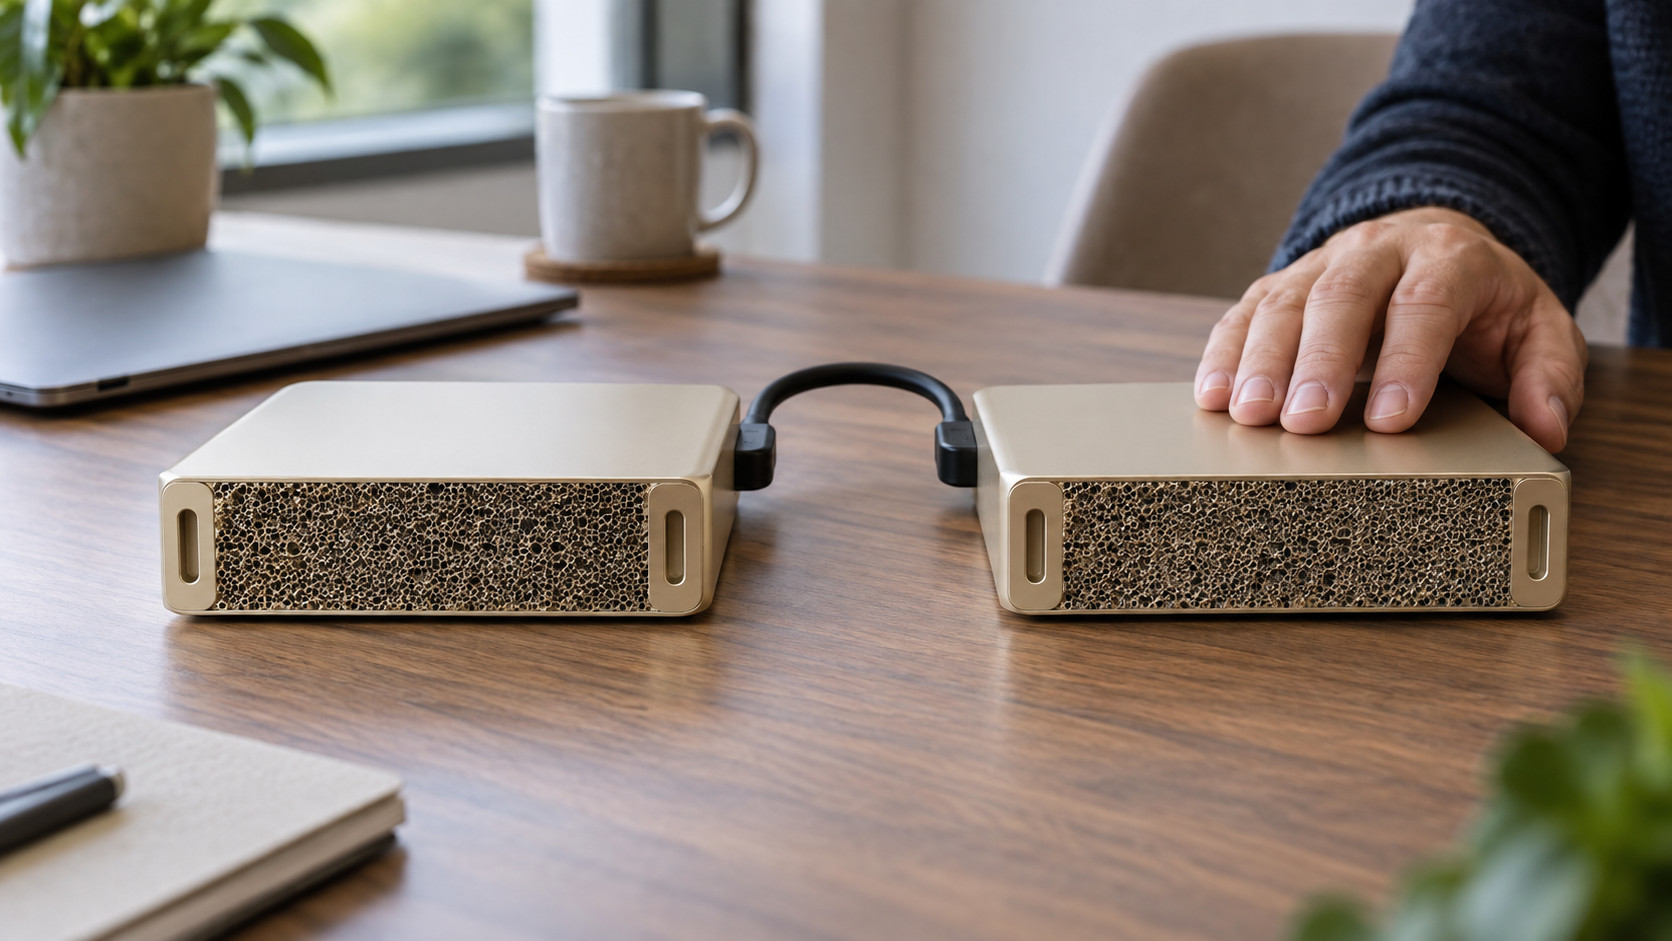
| 2x DGX Spark | 256 GB | DeepSeek V4.1 Flash(完整) | 全 expert 常駐 | 600,000 tokens | 約 NT$403,000(一次性,含官方互聯線) |
用戶 TWUC 實測 2x DGX Spark 跑 DeepSeek V4 0731:80 tok/s(輕負載)、重度 prefill 降至 45 tok/s,prefill 速度約 1,200 tokens/s。用戶 0x0SojalSec 分享 1–2 台 Spark 用 EXL3 量化跑 DeepSeek V4.1 Flash:32 tok/s 單串流、42 tok/s 雙並發、1,000 tok/s prefill,支援 600k context、775k KV cache。資料來源:Reddit r/LocalLLM、X @0x0SojalSec。
單台就夠的情境
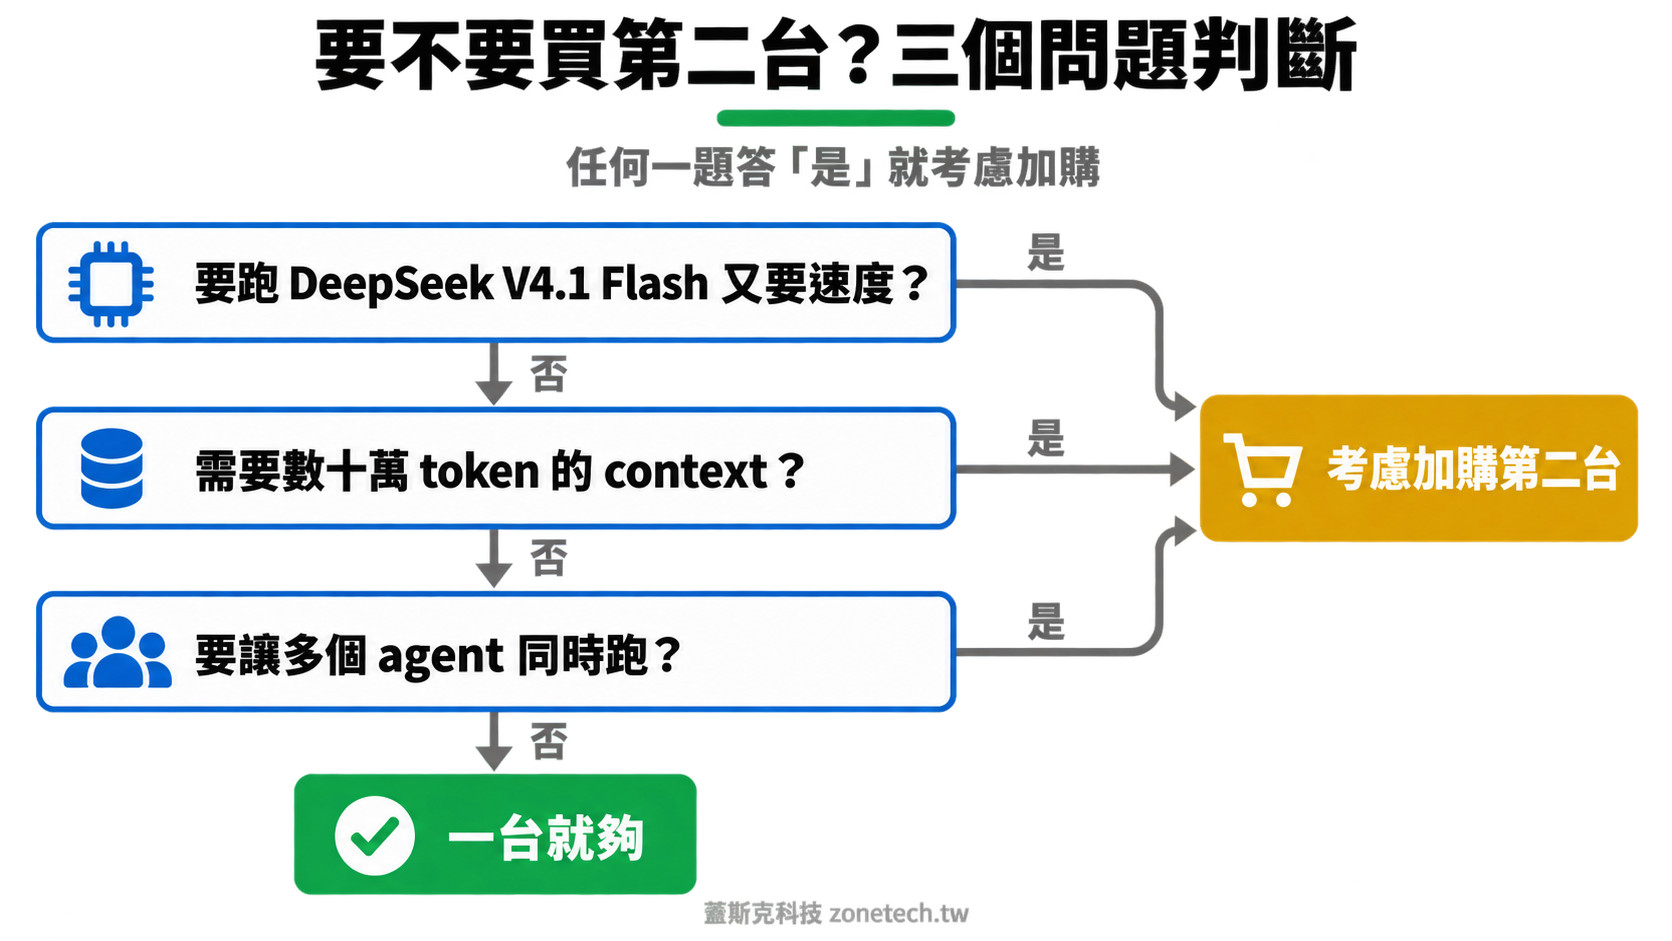
不是每個用途都需要兩台。以下這些情境一台足夠,不用多花 NT$199,000。
- 主力模型是 Qwen3.8-Flash-Next 或 27B 以下:單台 128GB 完整常駐,25–40 tok/s,速度沒有問題
- context 需求不大:一般程式碼 review、文件摘要、日常對話用不到數十萬 token
- 主要跑單一任務而非多 agent 並發:一台跑一個模型、一條對話,速度很夠
- 預算考量優先:一台先跑起來,等模型生態成熟再加購
必須兩台的情境
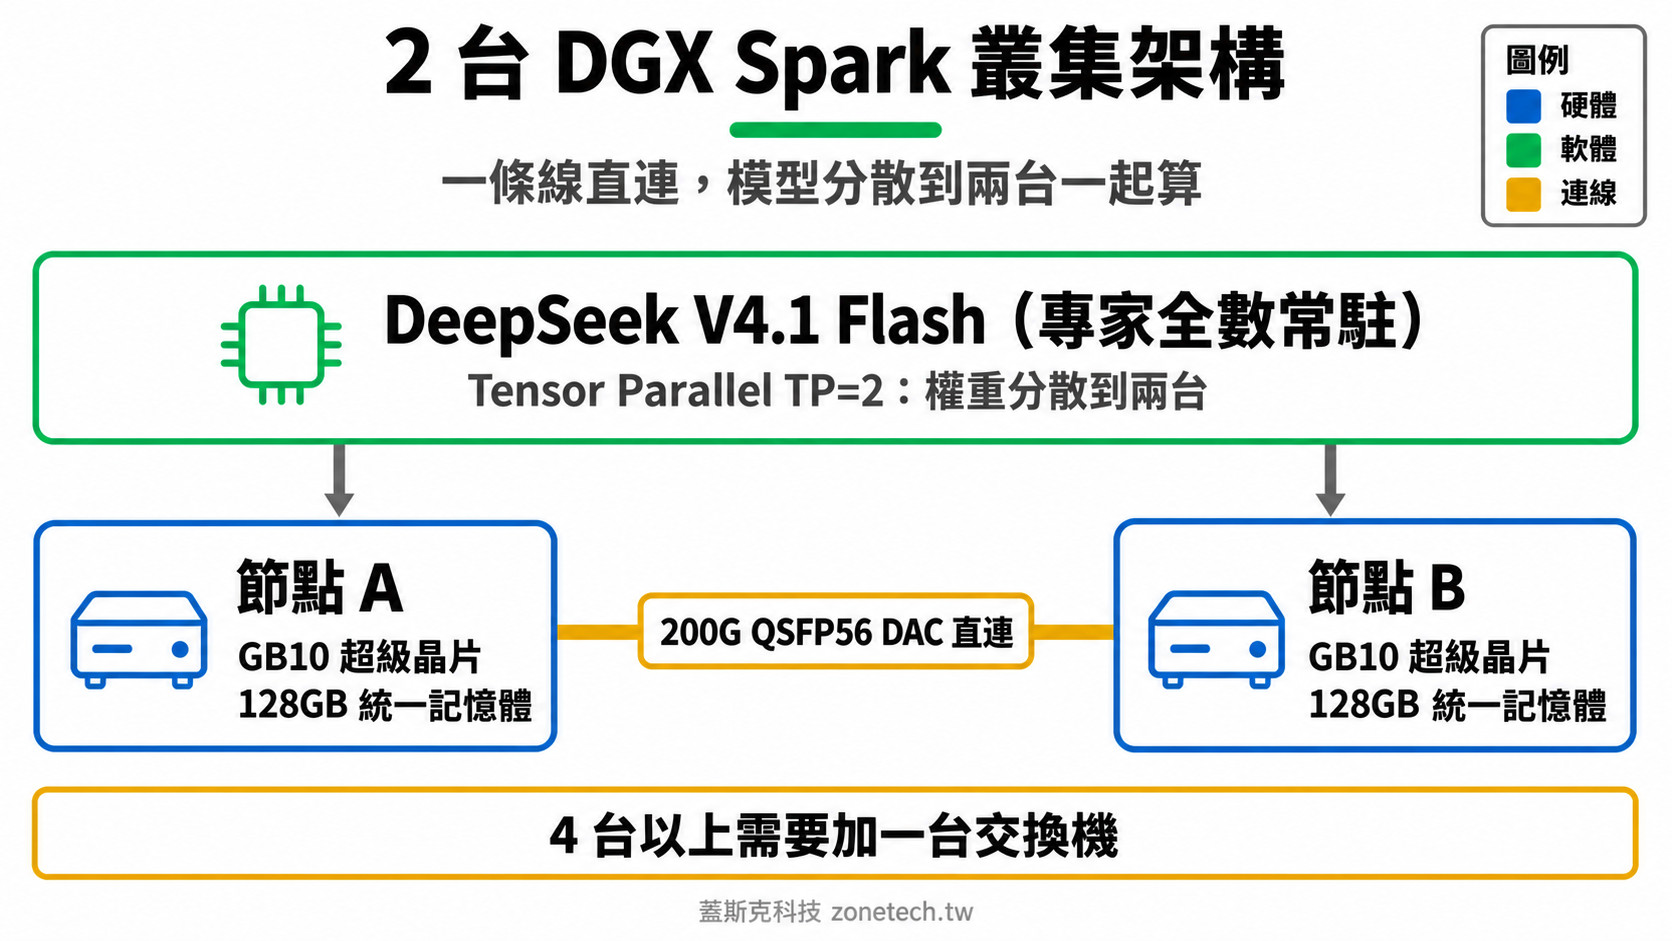
以下幾個情境,一台的記憶體就是物理上的瓶頸,不是調參數可以解決的。
- 要跑 DeepSeek V4.1 Flash 完整版:510GB 模型,單台只能用 NVMe streaming(社群實測約 15–21 tok/s,比雲端 API 慢),兩台才能讓 expert 常駐、達到 32 tok/s
- 需要數十萬 token 的 context 又要速度:單台用專家串流可以開到 256K context 但速度有限,要 600K context 加上 32 tok/s 的速度,社群做法是 2 台
- 多 agent 並發:同時跑多個 subagent,兩台的 TP=2 配置可以讓 prefill 更快、並行效能大幅提升
- 研究用途,想跑 GLM 5.3 Flash 等新 MoE 模型:社群推薦用 2 台跑
實測單台跑 Qwen3.8-27B:25–40 tok/s,同時還能跑 Gemma 4 26B 做 tandem 推論,滿足啟動期使用。2 台 DGX Spark 才能跑完整 context 的 DeepSeek V4 Flash,甚至 GLM 5.3 Flash。
結論
一台先跑起來是合理選擇。等你發現「跑 DeepSeek V4.1 Flash 速度太慢」或「需要 600k context」這兩個痛點出現,就是加購第二台的時機。這不是「越多越好」的問題,而是有具體需求才擴充。如果你的主力模型是 Qwen3.8-27B 或更小,單台就夠了。
立即開始:先確認你需要幾台
蓋斯克科技協助評估地端 AI 主機的台數與擴充時機,避免一次買太多或買了才發現不夠。
我們提供:
- 依模型與 context 需求判斷一台夠不夠
- 第二台的接線、網路設定與頻寬驗證
- 多台叢集的交換器選型與擴充路徑
- 台灣採購通路、保固與交期
已經有一台,在考慮要不要加第二台?
把你的模型、context 長度與同時使用人數告訴我們,先幫你判斷加機器有沒有用。
預約擴充評估 免費預約諮詢電話:02-2717-1019 LINE:@zonetech
關於作者
黃俊凱 Gask Hung|蓋斯克科技創辦人,曾任 D-Link 網路研發工程師、QNAP 雲端儲存應用工程師/專案經理,近期投入地端 LLM 導入評估。完整作者介紹
延伸閱讀:DGX Spark 雙機怎麼接?ConnectX-7 200G 網路設定|DGX Spark 最佳模型推薦:1x / 2x / 4x 配置清單|DGX Spark 台灣完整購買指南|地端 LLM 主機大車拼:DGX Spark vs Mac vs RTX 5090