DGX Spark 裝好了,然後呢?Ollama 拉什麼模型?1 台和 2 台的最佳選擇不一樣,而且推薦清單變動很快。這篇根據社群最新實測數字,整理了各配置的最佳模型清單,以及每個模型的實際 tok/s 和適用場景。
這篇要給你:1x / 2x / 4x DGX Spark 各配置的推薦模型、實測 token 生成速度、以及每個模型最適合做什麼用途。
這篇適合誰看
- 剛收到 DGX Spark 不知道要安裝什麼模型
- 已在跑 Llama 3 但想升級到更好的模型
- 考慮買第二台,想知道升級後能多跑什麼
- 想要「最強 / 最快 / 最聰明」這三個維度的清楚分類
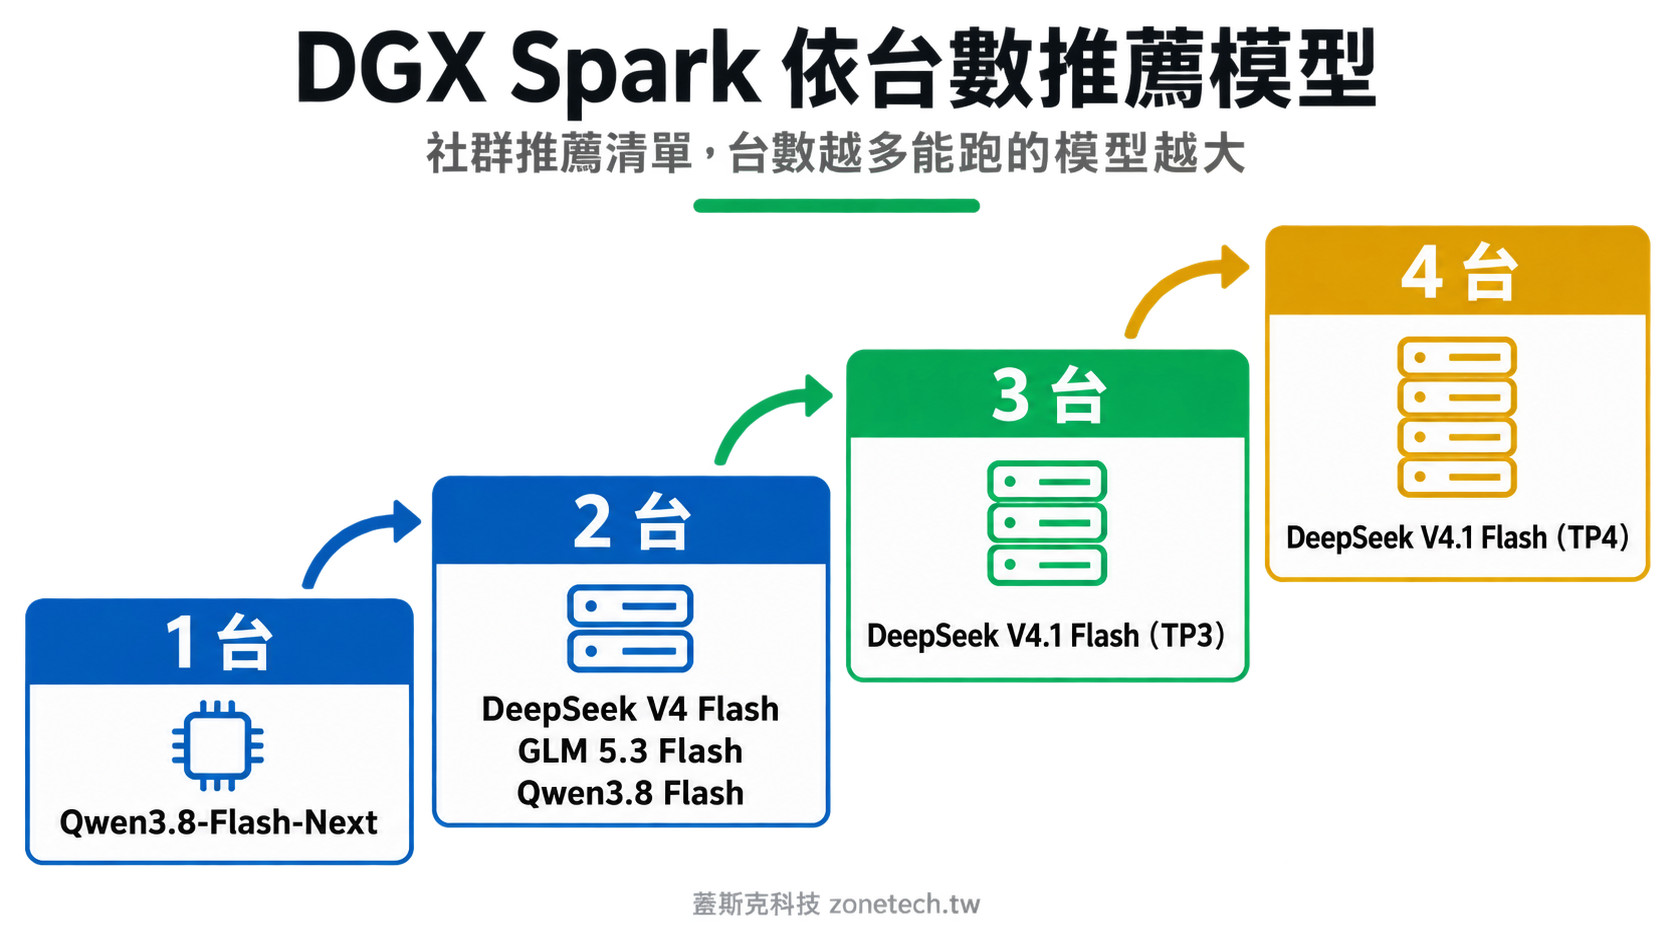
1x DGX Spark(128GB)推薦模型
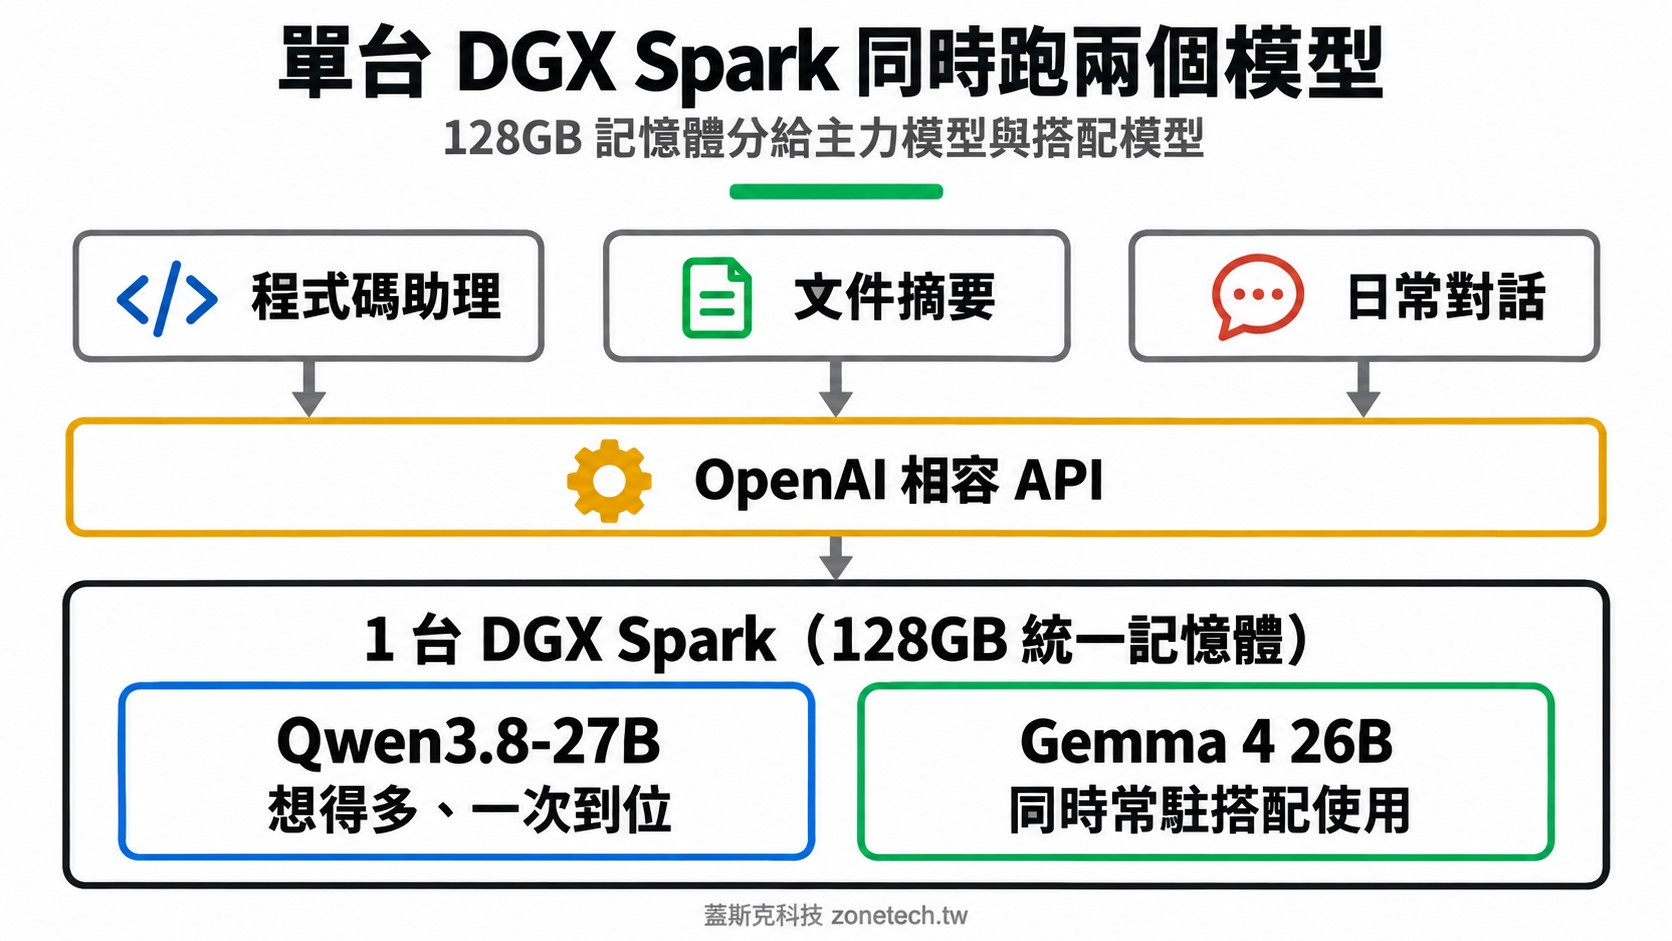
單台的常見組合是:Qwen3.8-Flash-Next 當主力,或 Qwen3.8-27B 搭配 Gemma 4 26B 同時常駐。
| 模型 | 社群實測速度 | 特色 | 備註 |
|---|---|---|---|
| Qwen3.8-Flash-Next(125B A6B,NVFP4) | 約 25–40 tok/s(依任務) | 嘗試、診斷、再重試 | 社群推薦單台首選 |
| Qwen3.8-27B | 約 25–40 tok/s(依任務) | 想得多,執行一次到位 | 可與 Gemma 4 26B 同時常駐 |
| Gemma 4 26B | 尚無公開單台數據 | 搭配 27B 使用 | 社群用戶同時常駐 |
| DeepSeek V4.1 Flash(NVMe 專家串流) | 15.2–20.85 tok/s | 本機可跑的最強開源模型之一 | 最高可開 256K context |
用戶 atumblingdandelion 實測單台 DGX Spark:Qwen3.8-Flash-Next 和 Qwen3.8-27B 約 25–40 tok/s(寫作較慢、程式與數學較快);跑 27B 時還能同時載入 Gemma 4 26B。用戶 MiaAI_lab 整理的社群推薦清單同樣以 Qwen3.8-Flash-Next 作為 1x Spark 的首選。資料來源:Reddit r/LocalLLM 串 1w5n0gl、X @MiaAI_lab。
2x DGX Spark(256GB)推薦模型
兩台的記憶體讓你進入一個不同的等級:DeepSeek V4.1 Flash 可以全 expert 常駐,context 長度直接跳到 600k。
| 模型 | 社群實測速度 | 備註 |
|---|---|---|
| DeepSeek V4.1 Flash(EXL3) | 32 tok/s 單串流/42 tok/s 雙並發 | 600K context |
| DeepSeek V4 Flash 0731 | 輕負載 80 tok/s,重度 prefill 降到 45 tok/s | prefill 約 1,200 tokens/s |
| GLM 5.3 Flash | 尚無公開數據 | 社群推薦 2 台可跑 |
| Qwen3.8-Flash-Next+DFlash | 數學 78.3/程式碼 58.7 tok/s | 數學比原生 MTP 快 36.1% |
3–4 台 DGX Spark 推薦配置
3 到 4 台才能讓 DeepSeek V4.1 Flash 用 tensor parallel 全速跑,4 台可以開到 1M context。
| 配置 | 模型 | 社群實測速度 | 備註 |
|---|---|---|---|
| 3 台(TP3,SGLang) | DeepSeek V4.1 Flash | 尚無公開單一數字 | 支援工具呼叫與視覺 |
| 4 台(TP4,vLLM) | DeepSeek V4.1 Flash | 65.3–84.9 tok/s | 1M context |
用戶 seanphan 實測 2x DGX Spark 上的 Qwen3.8-Flash-Next NVFP4 + DFlash 投機解碼:數學任務 78.3 tok/s(+36.1%)、程式碼 58.7 tok/s(+12.0%),對話任務略降至 37.8 tok/s(-13.5%)。說明投機解碼的加速效果高度取決於任務類型,數學和程式碼是最大受益者。
按用途選模型
| 用途 | 可以先試的模型 | 最低配置 |
|---|---|---|
| 程式碼、數學 | Qwen3.8-Flash-Next(2 台可加 DFlash) | 1 台 |
| 需要一次到位的推理 | Qwen3.8-27B | 1 台 |
| 長文件、長 context 且要速度 | DeepSeek V4.1 Flash | 2 台 |
| 多人共用的 API 服務 | DeepSeek V4.1 Flash(TP4) | 4 台 |
結論
2026 年 9 月,單台 DGX Spark 的最強組合是 Qwen3.8-Flash-Next NVFP4 作為主力,Qwen3.8-27B 作為備用。如果你有兩台,直接上 DeepSeek V4.1 Flash 完整版,這是目前本機可跑的最強 frontier 模型。模型生態演化很快,NVIDIA Developer Forum 持續有新的設定分享,值得追蹤。
立即開始:把模型真的跑起來
蓋斯克科技協助企業把地端模型從清單變成可用的服務,包含硬體、網路與推論框架。
我們提供:
- 依用途挑模型與量化格式
- vLLM/TensorRT-LLM 部署與 OpenAI 相容端點
- 多台 tensor parallel 的網路與設定
- 與現有系統、Agent 工具鏈整合
模型清單看完了,不知道從哪一步開始?
告訴我們你要處理的任務與資料量,我們幫你把機型、模型與部署方式一次配好。
預約地端模型導入評估 免費預約諮詢電話:02-2717-1019 LINE:@zonetech
關於作者
黃俊凱 Gask Hung|蓋斯克科技創辦人,曾任 D-Link 網路研發工程師、QNAP 雲端儲存應用工程師/專案經理,近期投入地端 LLM 導入評估。完整作者介紹
延伸閱讀:買一台還是兩台?DGX Spark 1x vs 2x 效能對決|510GB 模型塞進 128GB:DGX Spark 跑 DeepSeek V4.1 Flash|DGX Spark 雙機怎麼接?ConnectX-7 200G 網路設定|DGX Spark 並發效能:256 並行連線下的真實吞吐量