發布:2026-09-14|最後更新:2026-09-14
企業評估地端 LLM 推理架構時,很直覺會想「多幾張卡、多一點顯存,速度應該更快」。但實測數據常常不是這樣。
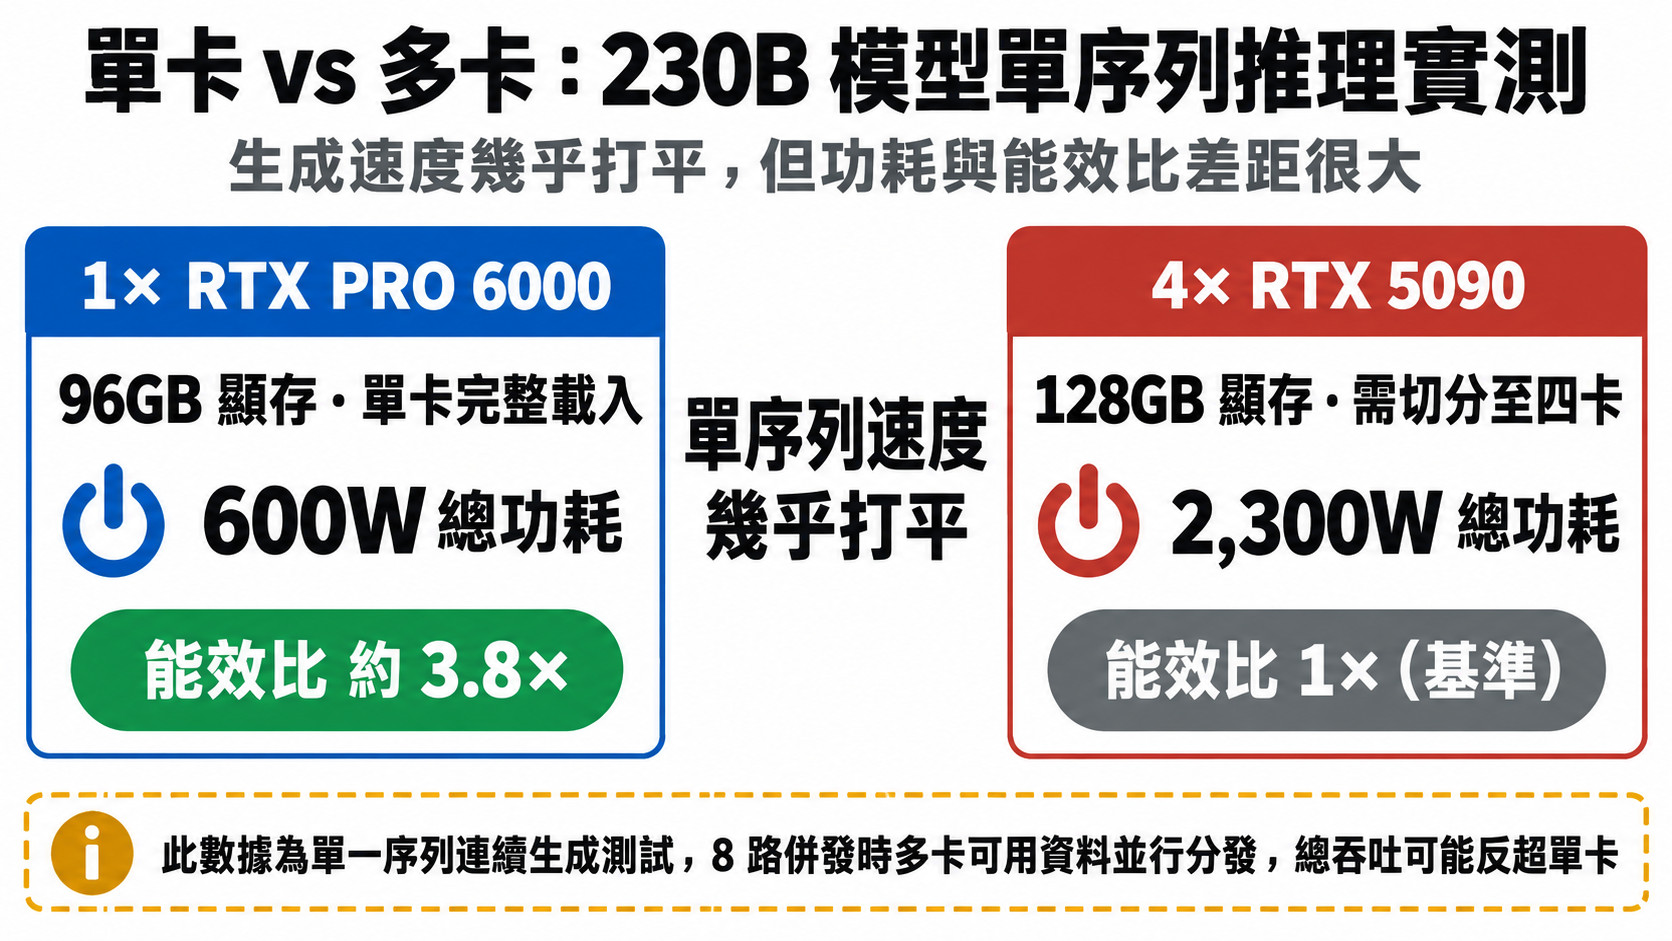
用 MiniMax M2.7(230B 參數,4bit 量化)做單一序列推理測試,一張 96GB 的 RTX PRO 6000,跟四張加起來 128GB 的 RTX 5090,生成速度幾乎打平——但總功耗差了將近 4 倍。這個結果推翻了「顯存加總越大越快」的直覺,也點出企業選型真正該問的問題:不是選單卡還是多卡,而是這張卡(或這組卡)跟你要跑的模型,配不配。
📋 本文重點摘要
- 230B 模型 4bit 量化測試:單張 RTX PRO 6000(96GB)與四張 RTX 5090(合計 128GB)單序列生成速度幾乎打平,但總功耗 600W 對 2,300W,能效比約 3.8 倍差距
- 單卡追得上多卡的原因:模型完整塞進單卡記憶體,不需跨卡通訊;多卡雖顯存更大,但要切分模型、每卡維護 KV cache 副本、還有層間同步開銷
- 這組數據測的是單序列推理,不代表高併發總吞吐——多用戶併發時,多卡反而能用資料並行分流,總吞吐可能反超單卡
- 企業實務通常是分層架構,不是二選一:核心大模型用單卡/少卡高顯存,高併發 API 用多卡横向擴充,開發測試用低階卡物理隔離
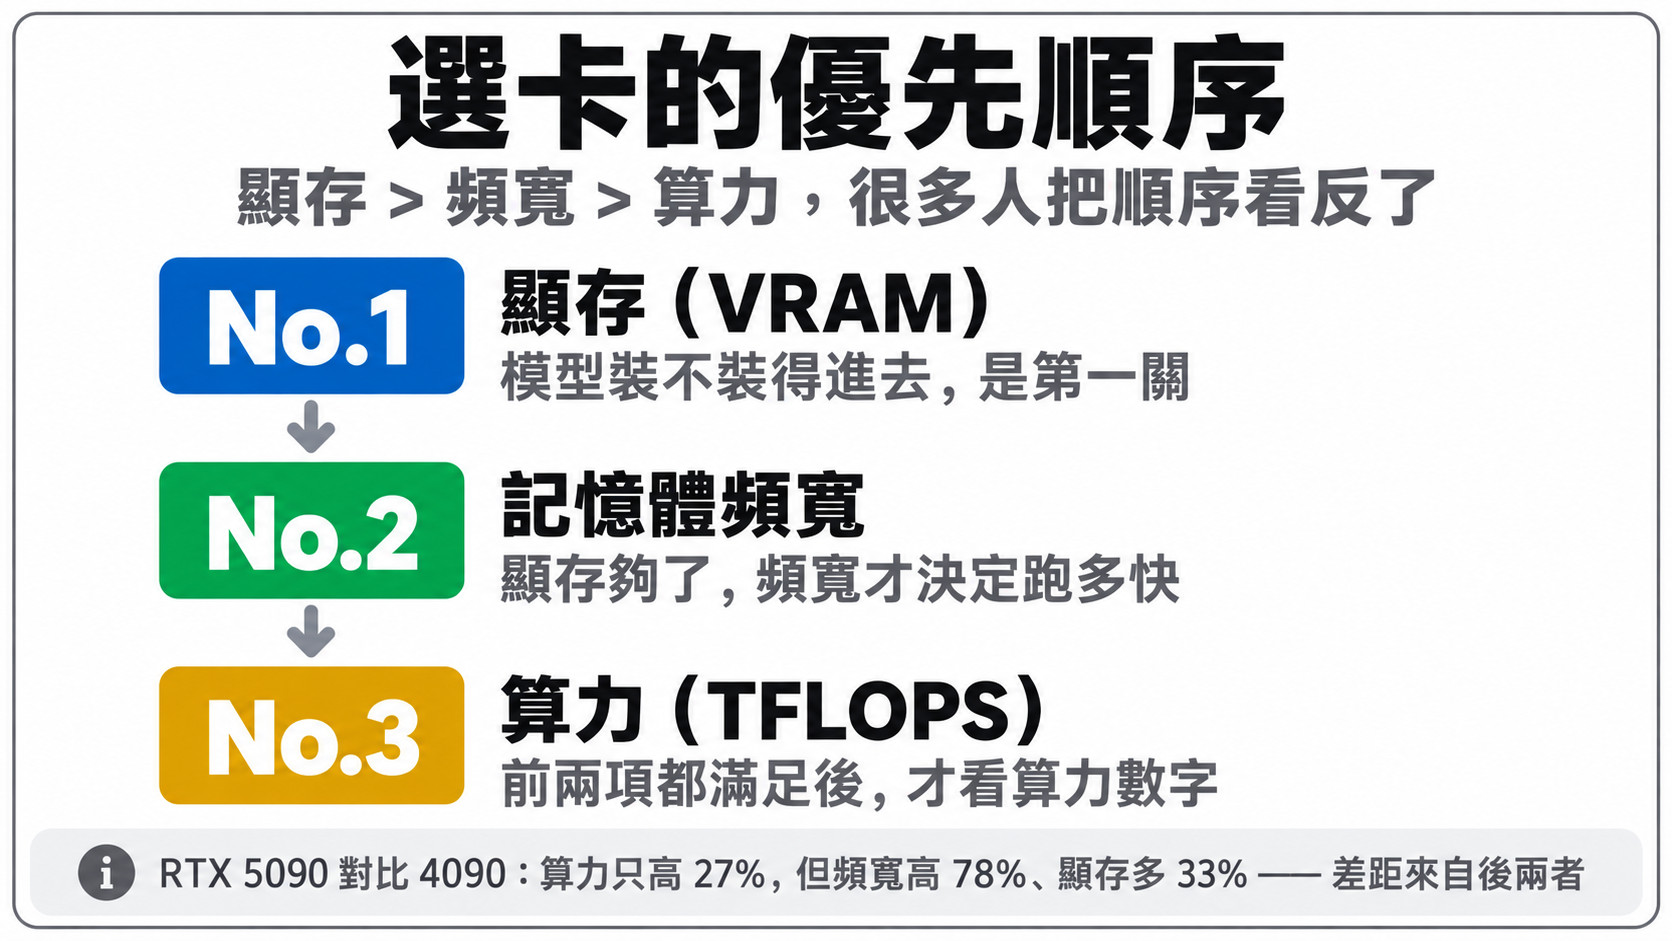
- 選卡優先順序:顯存 > 頻寬 > 算力,很多人第一眼看 TFLOPS,這個順序其實是錯的
👤 適合閱讀對象
- 要規劃地端推理叢集的 IT 主管:在「買一張大顯存卡」跟「買多張中階卡」之間猶豫,不確定哪個方向適合公司規模。
- 已經在跑地端 LLM、想擴充產能的工程團隊:現有單卡快撐不住併發量,要決定該加卡還是換更大顯存的卡。
- 負責 AI 基礎建設預算的企業主:想知道多花的顯卡預算,實際能換到多少效能,避免採購後才發現效益不如預期。
不確定該買單張大顯存卡還是多張中階卡?加 LINE 傳你要跑的模型規模與併發人數,我們先幫你初步判斷 → 加 LINE 諮詢
一、單張 96GB 打平四張 5090,測試結果是什麼
測試場景:MiniMax M2.7(230B 參數,GGUF UD-IQ3_XXS 量化),32K 上下文、4096 最大輸出 token,單節點測試。結果是單張 RTX PRO 6000 與四張 RTX 5090 的 token 生成速度幾乎打平。這個結果對很多人來說是反直覺的——四張卡加起來的顯存(128GB)明明比一張卡(96GB)大,理論上應該更快才對。
要注意這組數據測的是單一序列連續生成的吞吐速度,不是多用戶併發表現——這個限制在下一節會再說明,先看單序列場景下,為什麼單卡能追平四卡。
二、為什麼單卡追得上四卡:模型切分的隱藏成本
230B 模型 4bit 量化後權重約占 80–85GB,RTX PRO 6000 的 96GB 剛好完整吞下,整個推理過程都在單卡內完成,沒有跨設備通信。四張 RTX 5090 合計顯存雖然更大,但模型必須切分到四張卡上,每張卡都要維護一份完整的 KV Cache 副本,加上層與層之間的同步開銷,效率並沒有隨卡數線性提升。
| 維度 | 1× RTX PRO 6000 | 4× RTX 5090 |
|---|---|---|
| 單序列 token/s | 基準 | 幾乎持平 |
| 總功耗 | 約 600W | 約 2,300W |
| 能效比 | 約 3.8× | 1× |
| 8 路並發總吞吐 | 較低 | 反超(可資料並行分發) |
| 物理空間與部署複雜度 | 單卡,無互聯需求 | 需多卡互聯、散熱風道、供電冗餘 |
這組數據的限制要老實說清楚:token/s 測的是單一序列連續生成的吞吐,沒有反映並發批次處理能力。同時服務 8 個使用者請求時,四張 5090 可以透過資料並行(data parallelism)把請求分發到不同卡上,總吞吐反而會反超單卡 PRO 6000。這組測試適合理解「單一任務推理路徑」的效率,不等於完整的生產負載表現。
三、企業實務是分層架構,不是二選一
單卡與多卡不是互斥選項,企業實務上通常是依任務性質分層部署。一家系統整合商公布的金融業客戶部署案例,用的就是三層架構:
- 生產叢集層(RTX PRO 6000 × 4):負責核心大模型推理(70B+),處理長上下文客服場景,要求首個 token 回應時間(TTFT)低於 800 毫秒。
- 推理服務層(RTX 5090 × 8):負責中小模型(7B–14B)的高並發 API 服務,峰值 QPS 200+,透過 Kubernetes HPA 自動擴縮容因應流量波動。
- 開發測試層(RTX 5080/4090 × 1):負責模型微調、Prompt 工程、A/B 測試,與生產環境物理隔離,避免實驗影響正式服務。
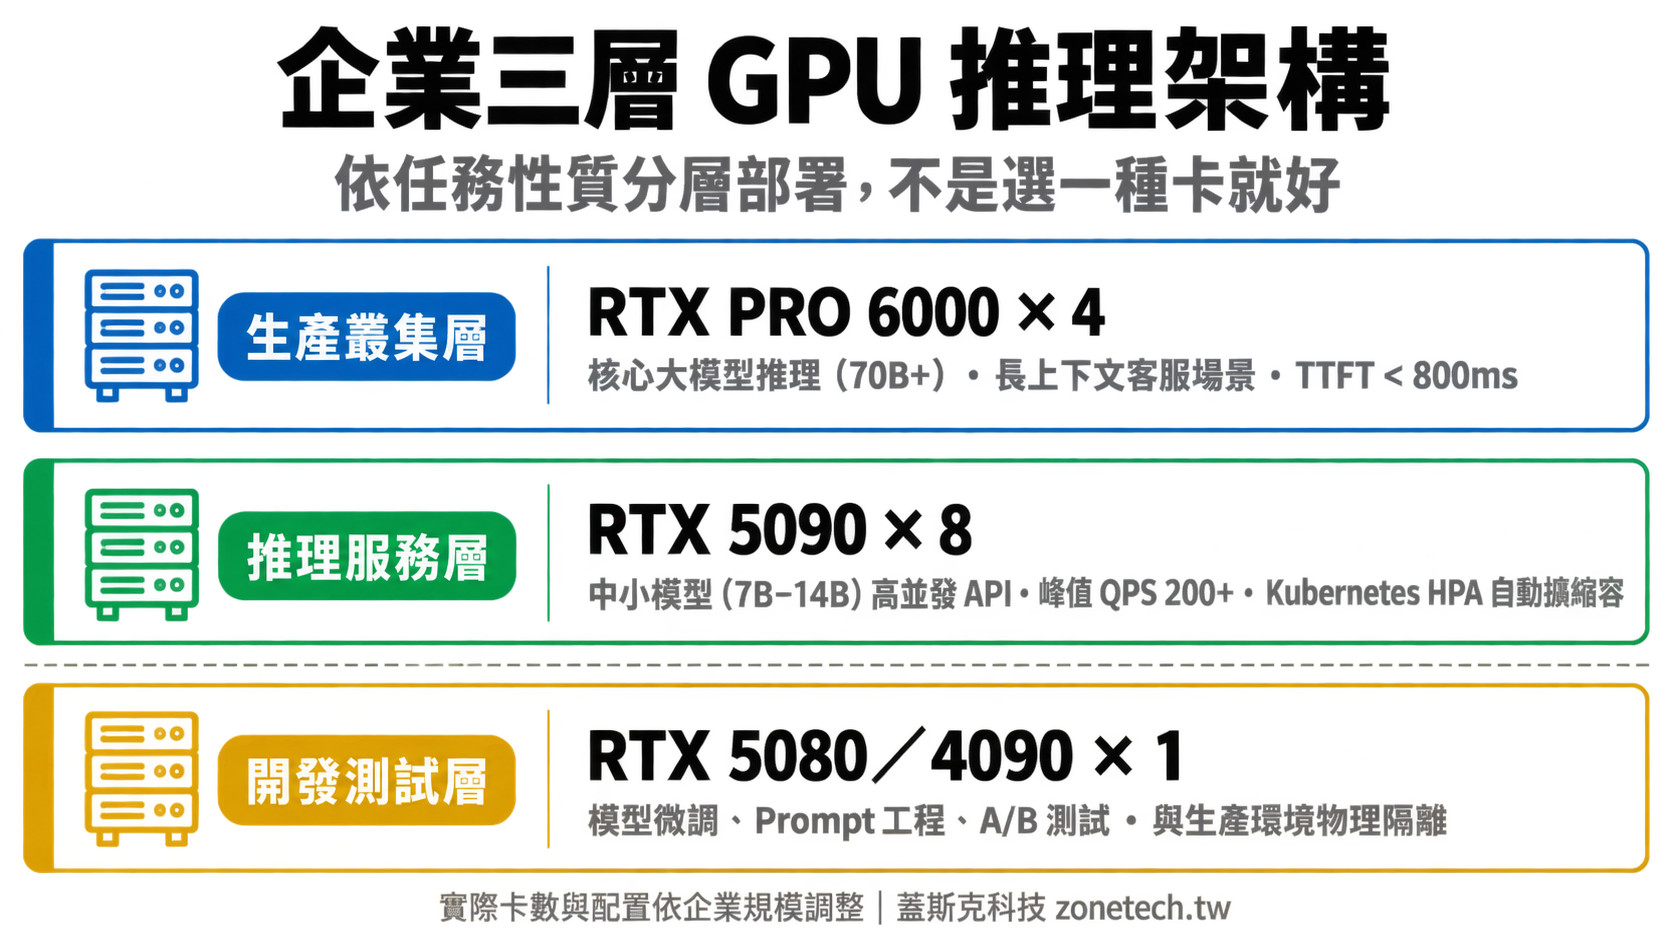
這個架構的邏輯很清楚:需要低延遲、大模型完整載入的核心任務用單卡/少卡高顯存;需要高吞吐、可橫向擴充的 API 服務用多卡叢集;實驗性質的工作跟生產環境分開,不共用資源。
真實用戶的單卡數據
- RTX PRO 6000 跑 Qwen 27B Q8(自行編譯 CUDA 13 版 llama.cpp):decode 約 44 tokens/s,prefill 約 1,600 tokens/s。持有者評語是「沒有很差,但也沒有很好;如果炒到台幣十萬等級的價位,這個價位有很多別的選擇」。
- 3 張 RTX PRO 6000(各約 97GiB)跑 GLM-5.2:用 .NET 推理引擎 TensorSharp,pp2048 達 1,145.8 tokens/s,對比同一台機器上 llama.cpp 的 763.1 tokens/s,約快 1.50 倍——推理引擎的選擇,對同一批硬體的實際表現影響很大。
- 也有使用者用改裝過的 48G 版 RTX 4090 當生產主力推理卡,跑 Qwen3.6-35B-A3B AWQ 4bit 量化版——說明二手/改裝硬體在特定量化與模型組合下,仍有實務可行性,但穩定性與保固風險要自行評估。
四、選卡的關鍵原則:顯存 > 頻寬 > 算力
很多人選卡第一眼看 TFLOPS(算力),這個順序其實是錯的——地端 LLM 推理場景,顯存容量的優先順序高於記憶體頻寬,記憶體頻寬又高於單純的算力數字。
以 RTX 5090 對比上一代 RTX 4090 為例:FP16 算力只比 4090 高約 27%,但記憶體頻寬高 78%、顯存多 33%。實際跑 32B 等級模型時,兩張卡的體驗差距,主要來自頻寬與顯存這兩項,不是算力數字。原因很單純:顯存不夠,模型根本裝不進去,再高的算力都用不上;顯存夠了,頻寬才決定實際跑多快。
選卡時可以按這個順序問自己三個問題:(1)這張卡的顯存,裝得下我要跑的模型(含量化格式與 KV cache)嗎?(2)裝得下之後,頻寬夠不夠支撐我要的生成速度?(3)前兩項都滿足了,才看算力數字決定要不要為了更快的 prefill 多花錢。
五、常見選錯的情境
| 常見誤區 | 為什麼會踩雷 | 該怎麼判斷 |
|---|---|---|
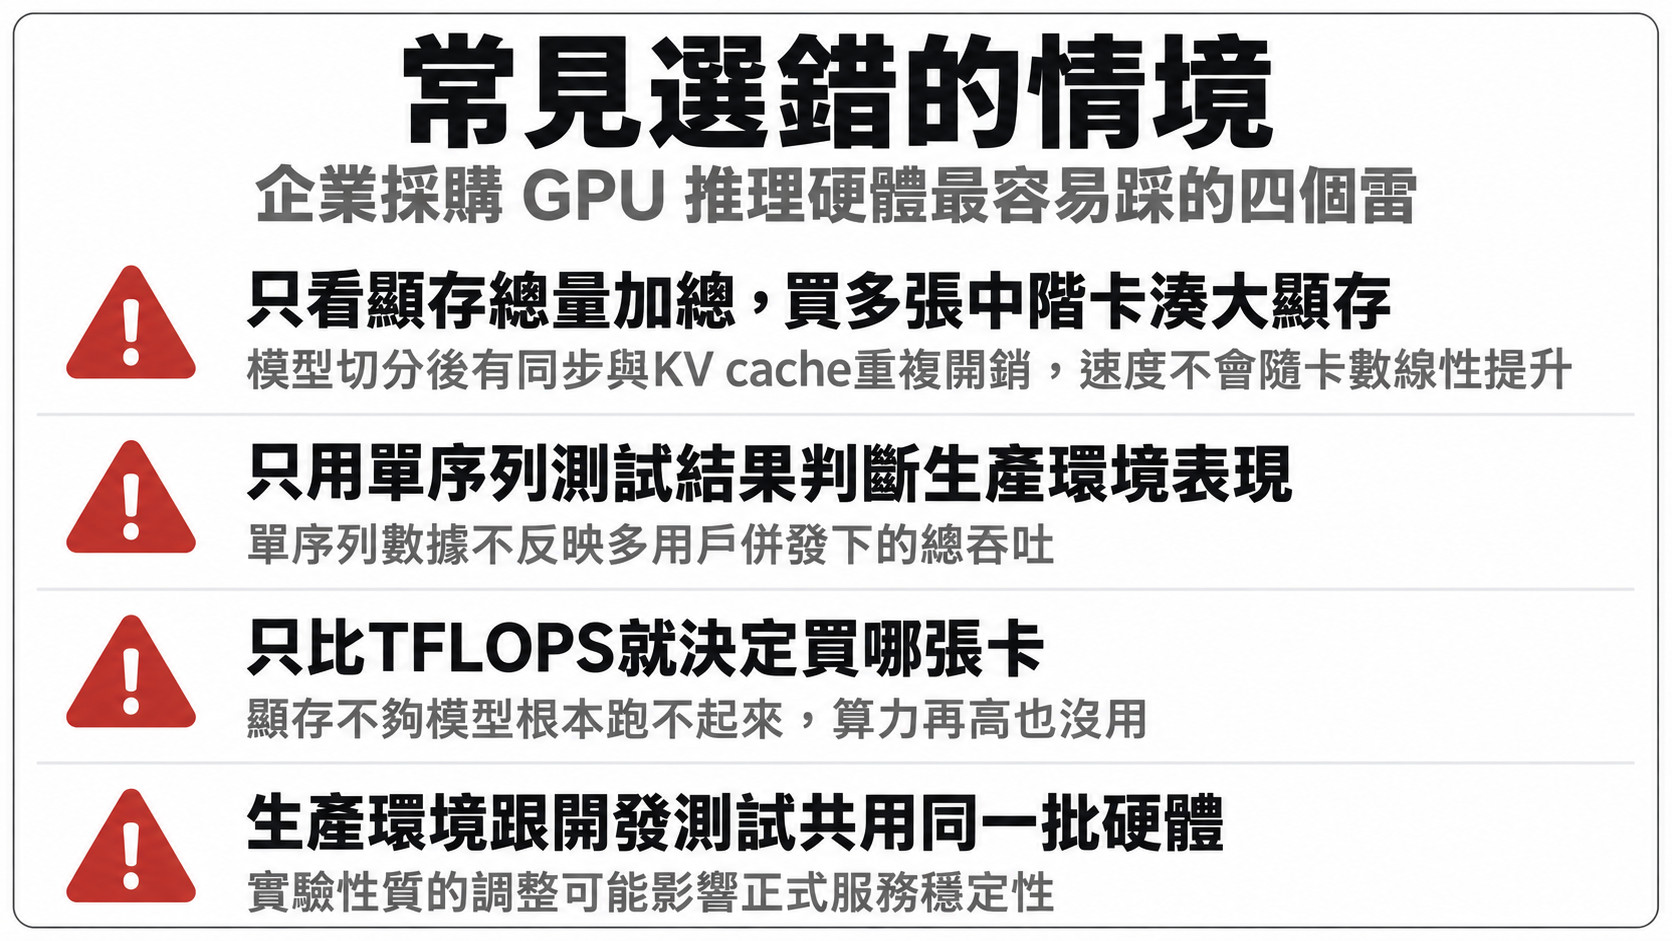
| 只看顯存總量加總,買多張中階卡湊大顯存 | 模型切分後有同步與 KV cache 重複開銷,單序列速度不會隨卡數線性提升 | 先確認模型能否完整塞進單卡,能塞就優先選單卡/少卡高顯存 |
| 只用單序列測試結果判斷生產環境表現 | 單序列數據不反映多用戶併發下的總吞吐,多卡在併發場景可能反而更划算 | 同時評估單序列延遲與目標併發量下的總吞吐,兩個數字都要看 |
| 只比 TFLOPS 就決定買哪張卡 | 顯存不夠模型根本跑不起來,算力再高也沒用 | 按「顯存 > 頻寬 > 算力」的順序評估,不要被算力數字牽著走 |
| 生產環境跟開發測試共用同一批硬體 | 實驗性質的調整可能影響正式服務穩定性,也難以做資源隔離 | 比照分層架構,至少把開發測試環境與生產環境物理隔開 |
結論
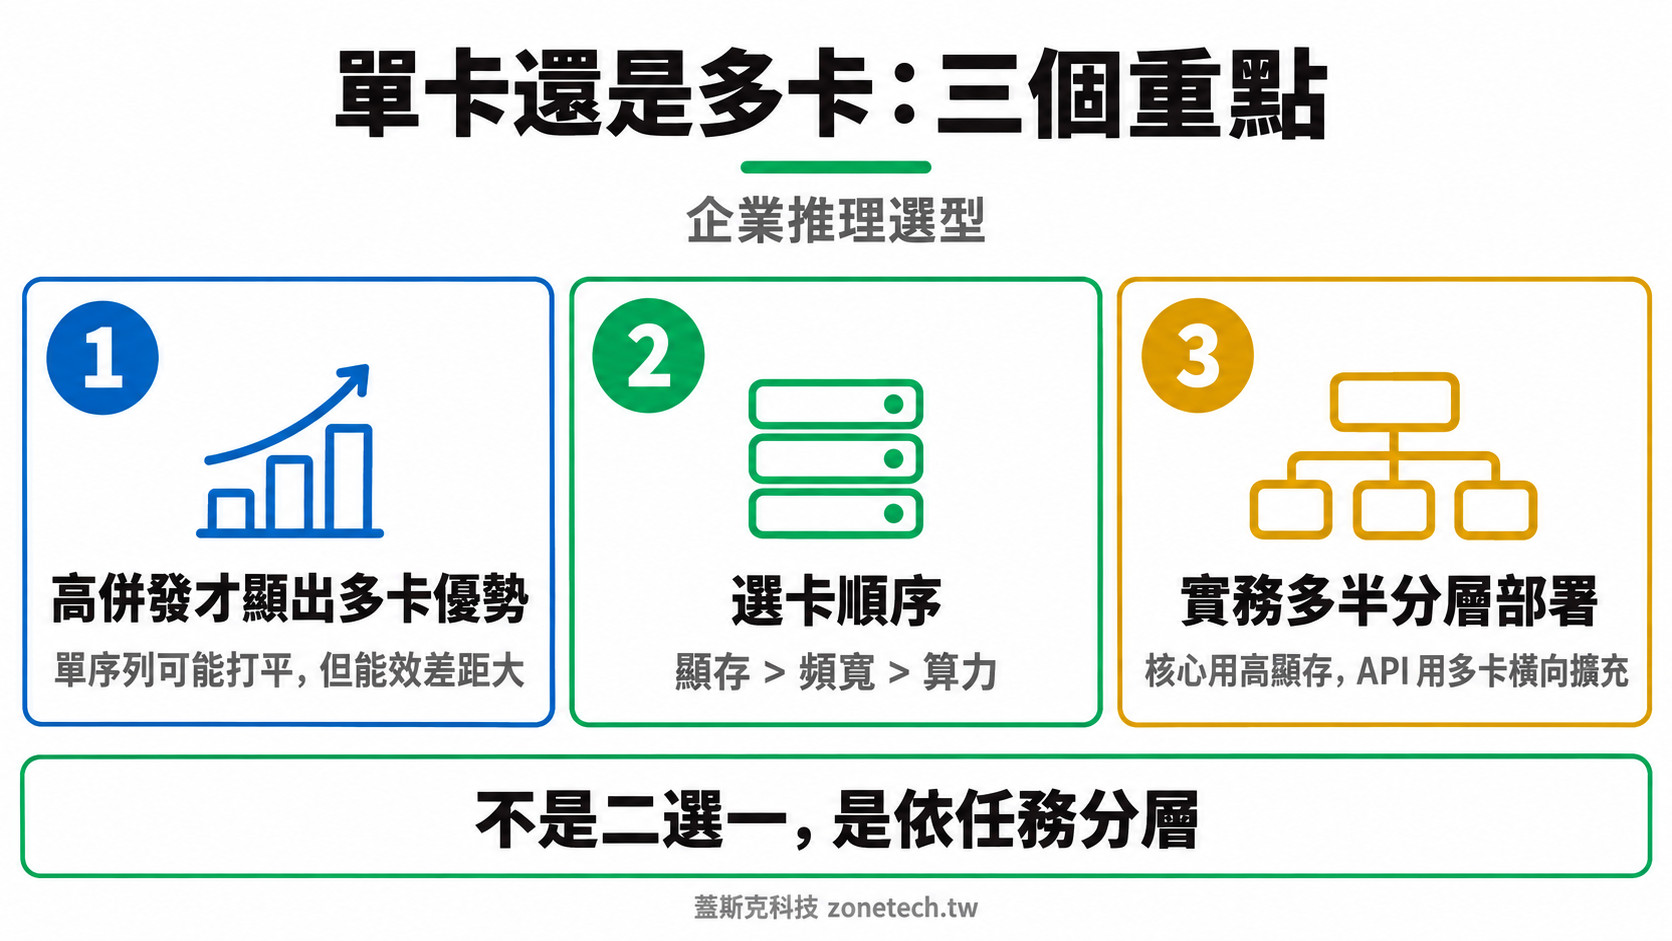
三個帶走的重點:(1)單卡與多卡在單序列推理場景下可能打平,但功耗與能效比差距很大,多卡的優勢要在高併發場景才會顯現;(2)選卡的優先順序是顯存 > 頻寬 > 算力,不是算力數字越大越好;(3)企業實務多半是分層部署,核心任務用高顯存單卡/少卡、高併發 API 用多卡橫向擴充、開發測試物理隔離,不是非此即彼的二選一。
立即開始:你的推理架構值得按實際負載規劃
蓋斯克科技協助台灣中小企業評估地端 AI 推理架構,依核心任務、併發 API、開發測試三種不同負載給分層建議,而不是先推銷特定卡種或數量。
我們提供:
- 依你的模型規模與併發需求,判斷該用單卡高顯存還是多卡橫向擴充
- 2026 年最新硬體市場報價區間,避免用過時規格或價格做決策
- 透明報價,無隱藏費用
- 設備租賃與採購兩種路線並陳,讓你先試用再決定
不確定該買單卡還是多卡?
蓋斯克科技提供企業設備租賃與地端 AI 推理架構評估服務,先幫你確認負載規模,再決定硬體配置。
了解設備租賃方案 免費預約諮詢電話:02-2717-1019 LINE:@zonetech
關於作者
Gask Hung|蓋斯克科技創辦人,專注台灣中小企業 IT:企業 Wi-Fi、4K 剪輯系統、IT 委外與設備租賃,近期投入地端 LLM 導入評估。完整作者介紹
延伸閱讀:地端 LLM 主機大車拼|地端 LLM 建置完整指南|設備租賃服務