作者:Gask Hung|發布:2026-09-15|最後更新:2026-09-15
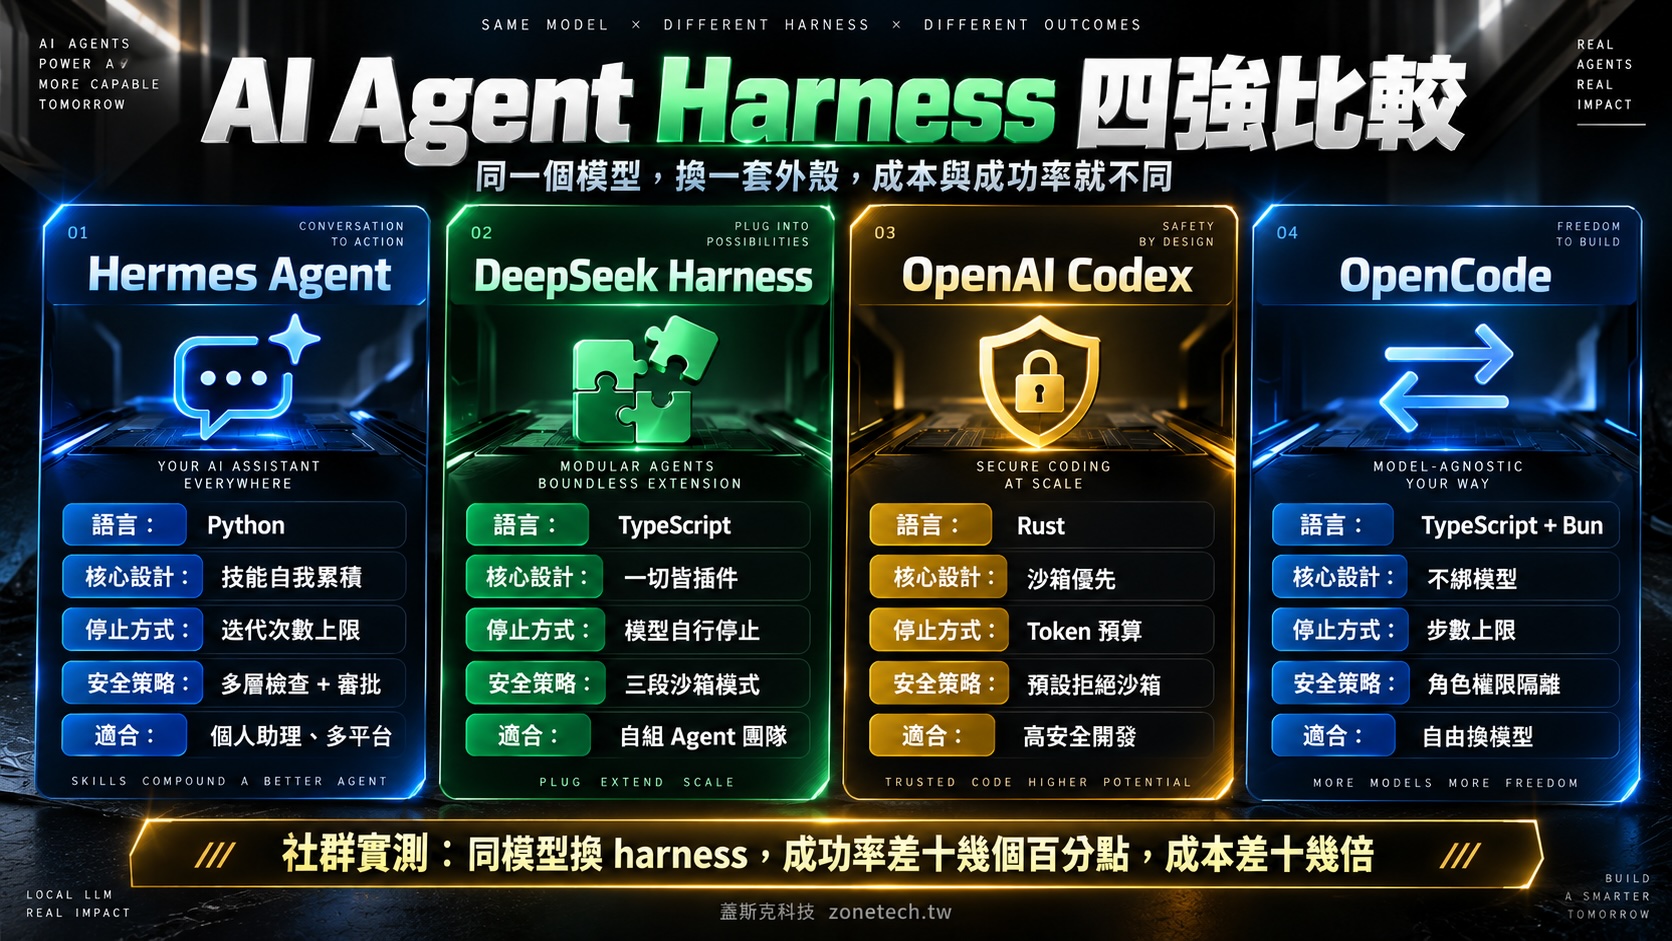
挑 AI Agent 工具時,模型只決定一半,另一半取決於包在模型外面的 harness。社群在 2026 年 8 到 9 月發布的多組實測顯示,同一個模型、同一批任務,只換 harness,成功率可以差到十幾個百分點,每次成功的成本差到十幾倍。Hermes Agent、DeepSeek Harness、OpenAI Codex、OpenCode 是目前 GitHub 追蹤數最高的四個開源 harness,各自押注在技能累積、插件化、沙箱安全、模型中立四個方向。企業導入前最該先比較的是停止機制、上下文壓縮與預設外部服務,而不是只看模型跑分。
📋 本文重點摘要
- 同模型換 harness:社群實測成功率落在 46.7% 到 67% 之間,每次成功成本從 US$0.028 到 US$18.34 都有(方法限制見第一節)。
- 四個專案的取捨:Hermes 會自己累積技能、DeepSeek Harness 所有元件可抽換、Codex 預設拒絕的沙箱最嚴格、OpenCode 支援 100 多個模型供應商。
- 企業導入三大風險:Agent 繞圈燒光預算、上下文壓縮後失憶、預設把資料送到未揭露的外部服務。
- 最準的選法:拿公司最常做的 10 到 20 個任務,同一個模型跑兩到三個 harness,量成功率、耗時與 token。
👤 適合閱讀對象
- 技術主管/CTO:工程團隊各自在用 Claude Code、Codex、OpenCode,想統一工具卻不知道比較基準在哪。
- IT 負責人:老闆要導入 AI Agent 做自動化,擔心裝了開源 Agent 之後資料被送去哪裡、會不會亂動公司電腦。
- 已經在跑地端 LLM 的團隊:公司內部已有模型主機,想找一個能接內部模型、又不會把 token 燒光的 Agent 外殼。
想知道你們團隊該用哪一套 AI Agent?加 LINE 傳你們最常交給 AI 做的三件工作與目前用的模型,我們先幫你初步配對 → 加 LINE 諮詢
本文整合三個來源:知乎作者對四個專案原始碼的架構分析、X 約 150 則與 Reddit 約 140 篇社群討論,以及蓋斯克在 2026 年 9 月 15 日逐一回 GitHub 查證的專案數據與 issue 紀錄。原文與社群說法互相矛盾的地方,會在第七節照實列出,不替任何一方下結論。
一、AI Agent harness 是什麼?為什麼同一個模型換 harness 結果差很多
AI Agent harness 是包在大型語言模型外面的執行框架,用於決定模型能用哪些工具、怎麼跑迴圈、何時停止。harness 負責的事情包括系統提示、工具定義、工具怎麼並行、上下文滿了怎麼壓縮、指令在不在沙箱裡執行。模型本身只負責「想」,harness 決定模型想完之後怎麼「做」。
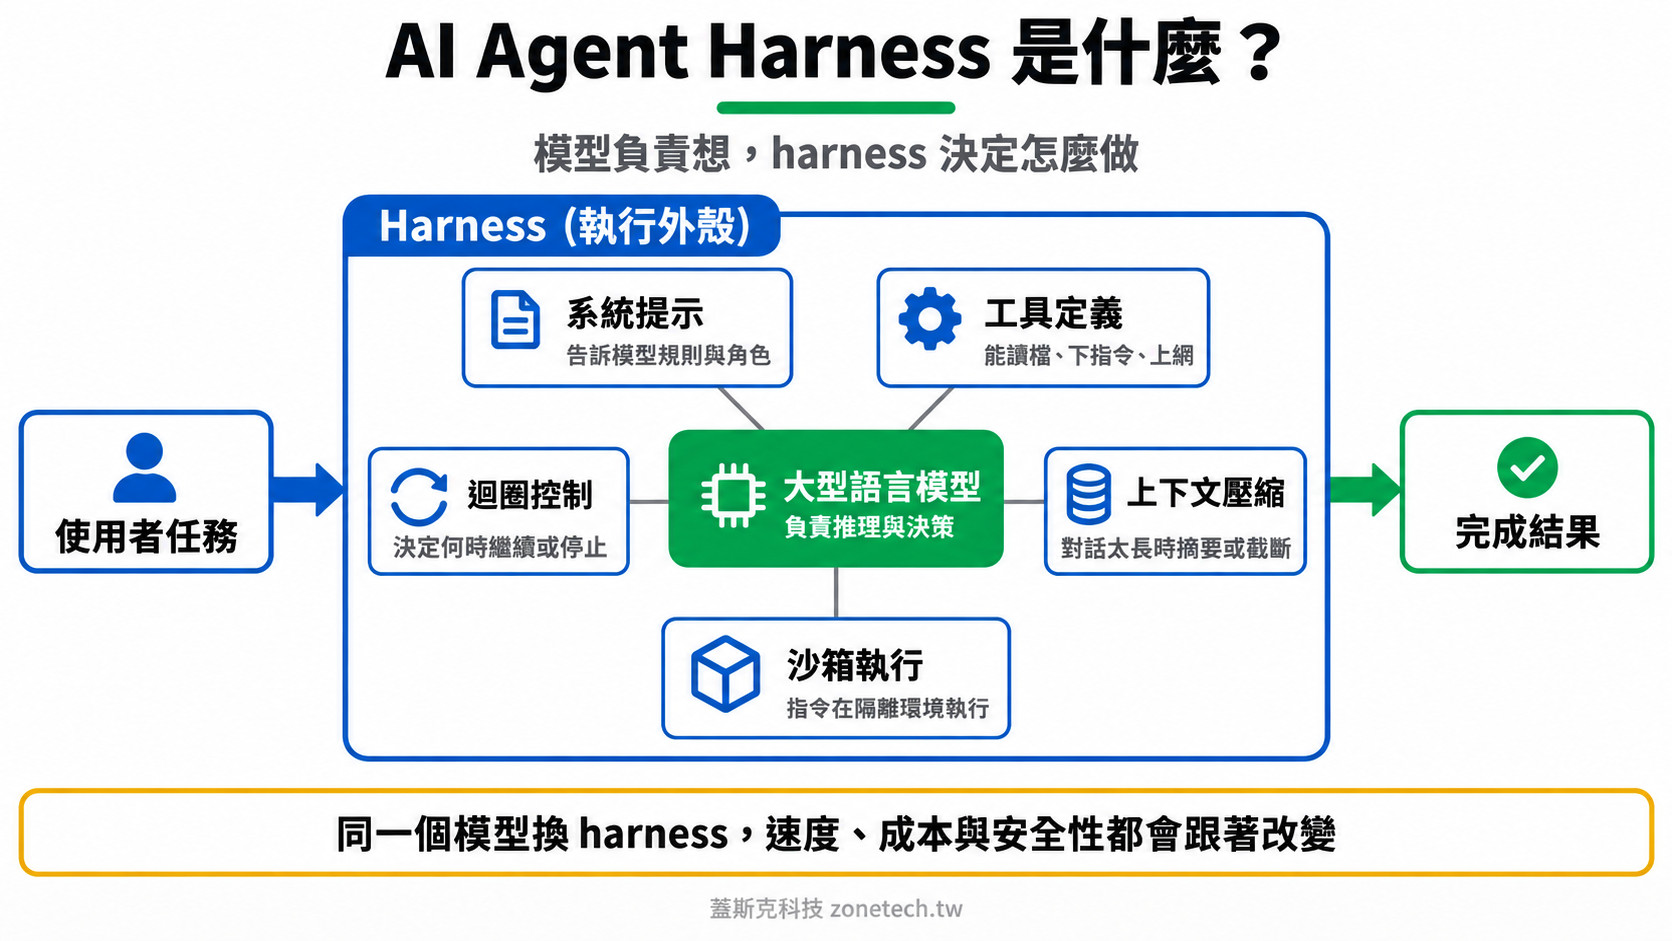
一個好懂的比喻:模型像一位能力很強的外包工程師,harness 像公司給他的工作規範與工具箱。同一位工程師,拿到一本寫得精簡的 SOP,可能兩小時交件;拿到一本三百頁、每件事都要先讀一遍的手冊,同樣的工作要做一整天,錢也多花好幾倍。工程師沒變,差別出在規範與工具怎麼設計。
Harness 的影響有多大,社群在 2026 年 8 到 9 月做了三組實測,數字方向一致:
| 實測 | 測試設計 | 主要結果 | 適用情境 |
|---|---|---|---|
| FrontierHarness Eval(X @guanlan,2026-09-02) | 9 個 harness、同模型同任務同環境,360 次執行、20 億 token | 成功率 50% 到 67%,每次成功成本 US$1.05 到 US$18.34 | 評估開發型任務的成本差距 |
| 8 個 harness 跑 DeepSeek V4 Flash(Reddit r/DeepSeek,2026-08) | 25 個跨 Slack、Sheets、Gmail 的自動化任務 | Pi Agent 66.7% 最高、OpenCode 46.7% 最低;每次成功成本 US$0.028 到 US$0.195 | 評估辦公自動化型任務 |
| Claude Code/OpenCode/Pi 對打(Reddit r/LocalLLaMA,2026-08) | 本機 vLLM 跑 DeepSeek V4 Flash,大型程式碼庫實際工作 | 三者改出的程式碼品質接近,Claude Code 耗時約為最快者 4 倍 | 評估大型專案的時間成本 |
第三組實測的發文者另外量了每個 harness 開場塞給模型的系統提示長度:Pi 約 1,340 token、OpenCode 約 7,197 token、Claude Code 約 23,132 token。Claude Code 的大宗是 27 個工具的說明文字。第二組實測則發現,Claude Code 與另一個 harness 每個任務都用了約 74 萬 token,但 Claude Code 只有 1.5% 命中快取、Codex 有 70%,花費因此差了將近一倍。工具呼叫次數多,成功率沒有跟著變高。
這三組數字要搭配留言區的方法質疑一起讀。第二組透過 OpenRouter 呼叫模型,OpenRouter 會分派到價格與品質不同的供應商;三組大多只跑一輪,LLM 每次輸出不同;任務都是發文者自己挑的。社群實測能支撐的結論是「harness 設計會大幅影響成本與成功率」,排名本身換一批任務就可能改變。
二、Hermes、DeepSeek Harness、Codex、OpenCode 差在哪?四個專案一次看
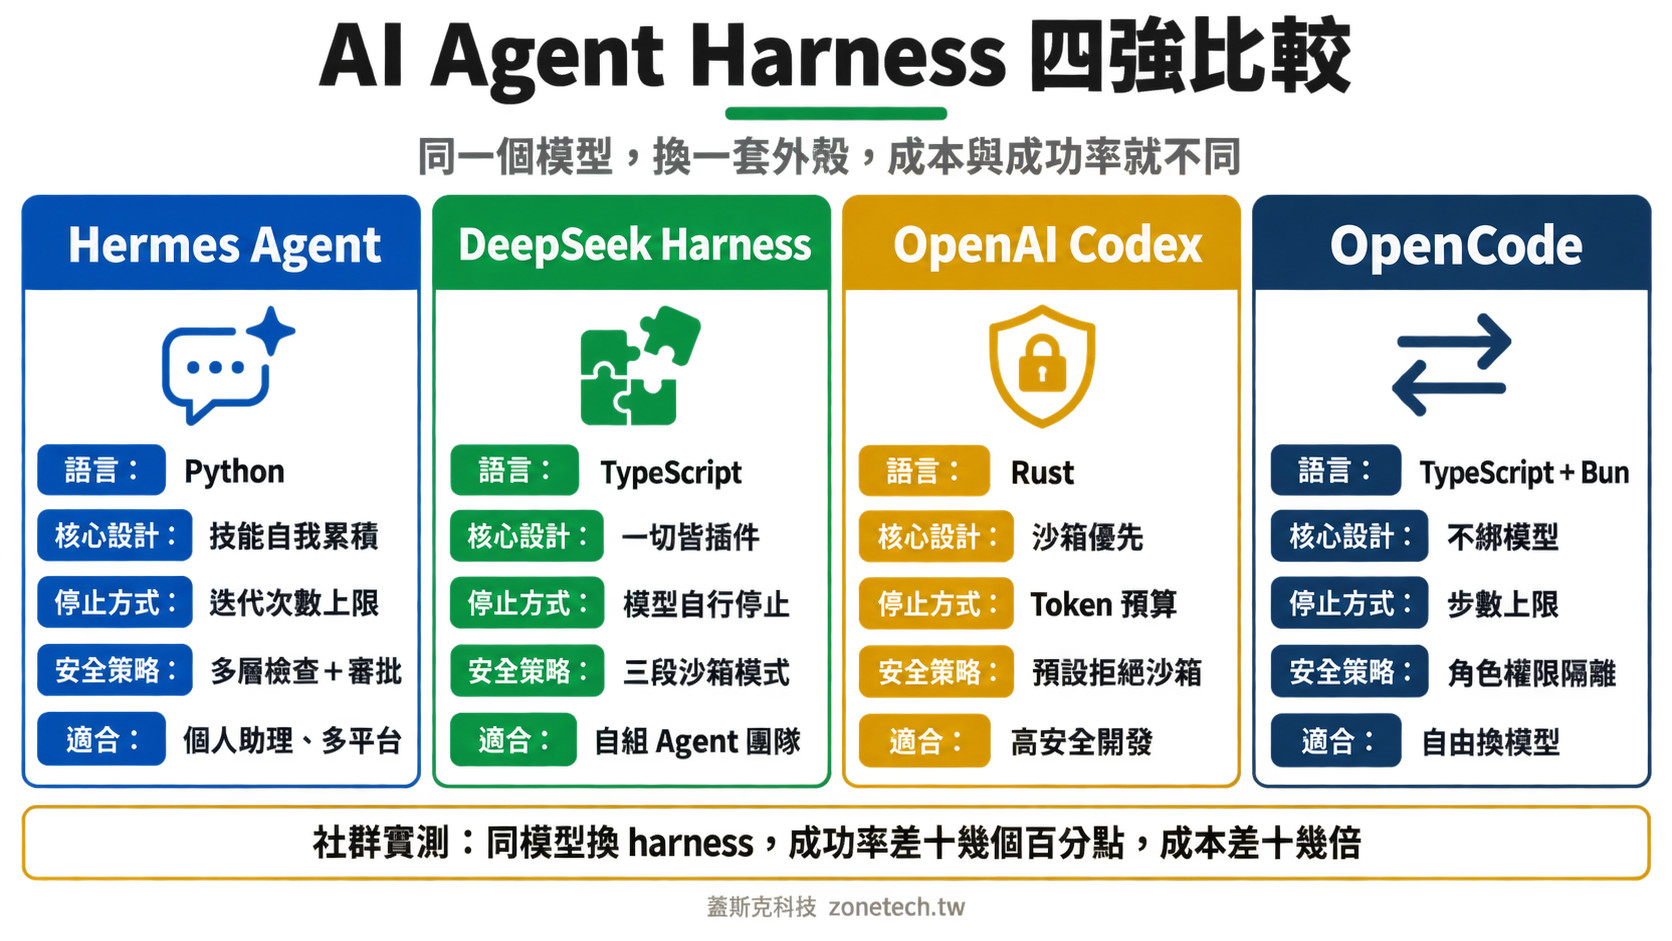
四個 harness 各押一個方向:Hermes 押技能累積、DeepSeek Harness 押全面插件化、Codex 押沙箱安全、OpenCode 押模型自由。下表的 GitHub 追蹤數與授權,由蓋斯克在 2026 年 9 月 15 日逐一查詢 GitHub 取得;架構描述整理自知乎作者對原始碼的分析。
| 項目 | Hermes Agent | DeepSeek Harness | OpenAI Codex | OpenCode |
|---|---|---|---|---|
| 開發方 | Nous Research | DeepSeek | OpenAI | 社群(anomalyco) |
| 主要語言 | Python | TypeScript | Rust | TypeScript+Bun |
| GitHub 追蹤數(2026-09-15) | 約 24.6 萬 | 約 22.4 萬 | 約 12.4 萬 | 約 20.7 萬 |
| 授權 | MIT | MIT | Apache-2.0 | MIT |
| 核心設計 | 技能以 Markdown 檔存放,Agent 可自行新增修改 | 建立在 Cordis 依賴注入框架,模型、工具、沙箱、迴圈都能抽換 | 每個功能一個 Rust crate,跨平台沙箱內建 | 客戶端與伺服器分離,規劃模式與執行模式權限分開 |
| 模型支援 | 多個供應商適配器與備援鏈 | 模型層本身是插件 | OpenAI 為主,另支援 Ollama、LM Studio | 透過 models.dev 支援 100 多個供應商 |
| 適用情境 | 接 Telegram、Slack 等 8 個通訊平台的個人或團隊助理 | 有能力自行組裝客製 Agent 的團隊 | 對資安要求高的程式開發 | 想自由切換模型、包含地端模型的開發者 |
Hermes Agent 的設計重點是讓 Agent 越用越懂使用者:完成複雜任務後,Hermes Agent 可以把做法寫成技能檔,下次直接套用,四個專案裡只有它的擴充機制會自己變。代價是核心類別龐大,知乎作者指出建構子有 47 個參數,除錯要跨好幾層模組。
DeepSeek Harness 的「一切皆插件」來自北大與 DeepSeek 合作的論文〈A Programming Paradigm for Spatiotemporal Composability〉,概念是元件卸載時能完整撤銷自己做過的事,依賴被換掉時會自動反應。會話紀錄採事件溯源,只追加不修改,所以能回到任何時間點重建狀態。代價是學習門檻高,DeepSeek 官方在 GitHub README 也明確提醒這仍是開發者預覽版:
DeepSeek Harness 官方 README 寫道:「DeepSeek Harness is in developer preview and iterating rapidly. THERE WILL BE COMPATIBILITY-BREAKING CHANGES.」(目前是開發者預覽版、快速迭代中,之後一定會有破壞相容性的更新。)
OpenAI Codex 是四個專案裡唯一用 Rust 寫的,原因是要做跨平台沙箱:macOS 用 Seatbelt、Linux 用 Bubblewrap 加 Landlock 加 seccomp、Windows 用 ACL,macOS 策略預設全部拒絕再逐項開放。OpenCode 則是唯一由社群主導的專案,規劃模式下編輯工具根本不會出現在模型的工具清單裡,模型想改檔案也改不了,使用者同意後才切到執行模式。
三、AI Agent 什麼時候會停?會不會繞圈把預算燒光?
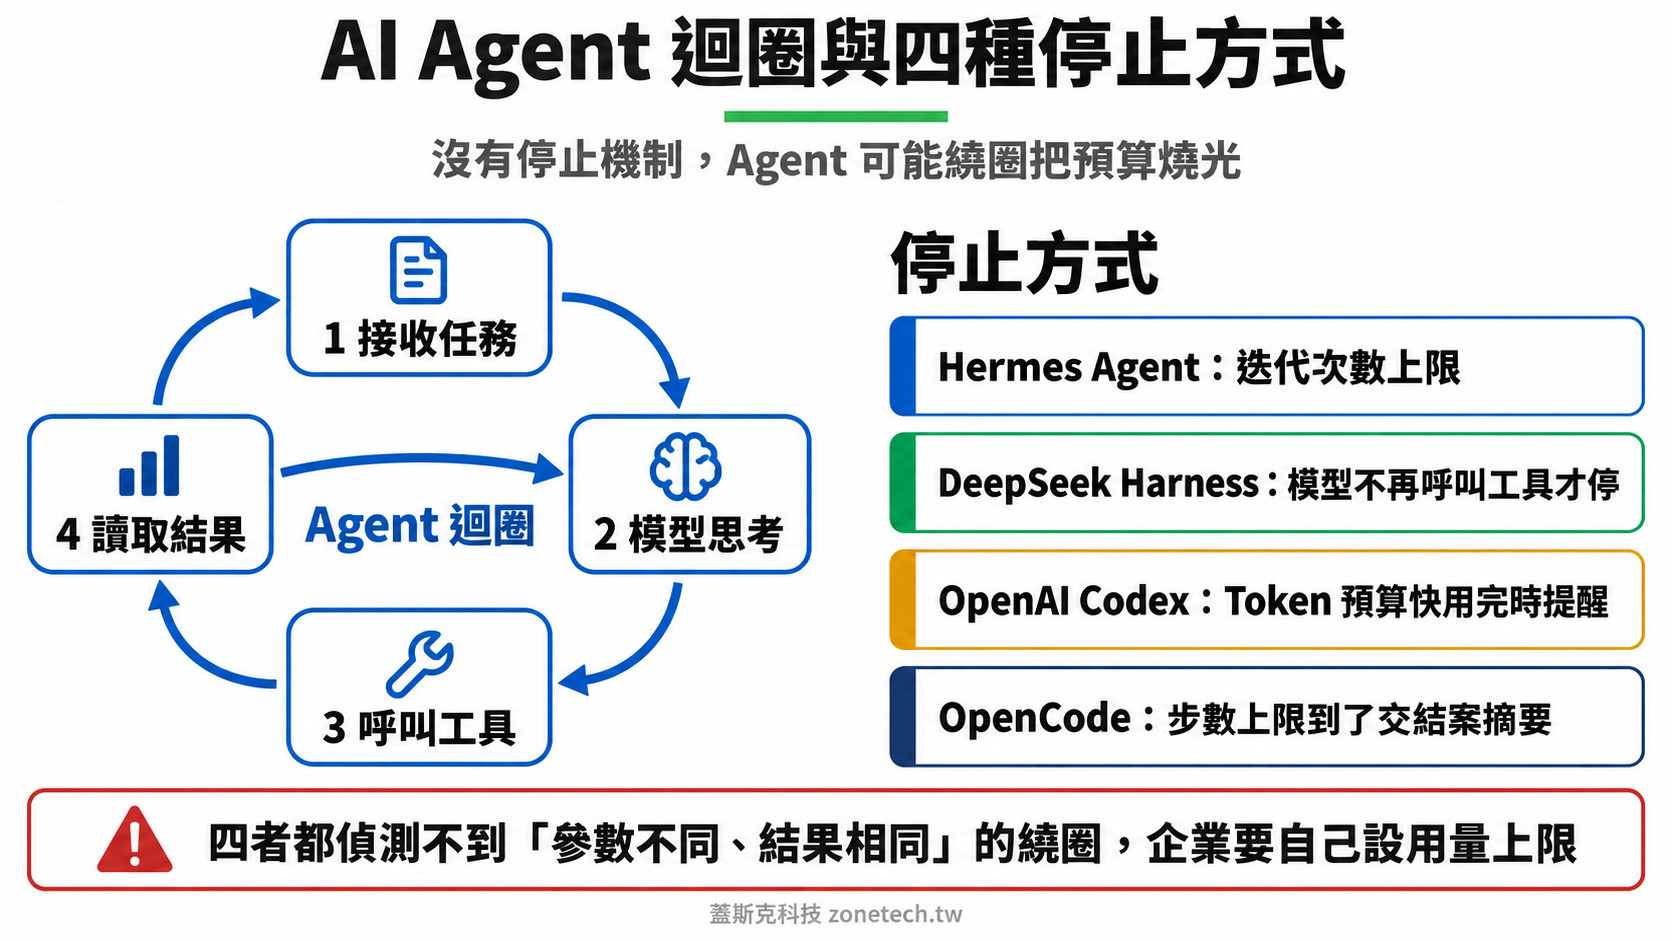
四個 harness 的停止機制完全不同,而且沒有一個能偵測「換不同參數繞圈子」的情況,企業一定要自己設預算上限。停止機制決定了 Agent 卡住時,燒掉的是幾分錢還是整個月的額度。
| Harness | 停止方式 | 優點 | 適用情境 |
|---|---|---|---|
| Hermes Agent | 迭代次數上限,主 Agent 500 次、子 Agent 50 次 | 用完後再給模型一次收尾機會 | 需要硬性保護的長時間任務 |
| DeepSeek Harness | 沒有迭代上限,模型不再呼叫工具才停 | 不會把正在推進的工作硬切斷 | 信任模型判斷、有人盯著的任務 |
| OpenAI Codex | 依輸出與輸入 token 加權計算的預算 | 快用完時提醒模型,不直接中斷 | 在意 API 花費的開發團隊 |
| OpenCode | 步數上限,到了就要求模型交出結案摘要 | 降級體驗最好,會交代做到哪裡 | 需要知道中斷點的自動化流程 |
繞圈燒錢不是理論風險。Hermes Agent 的 GitHub issue #60084(2026-07-07 提出,蓋斯克 2026-09-15 查詢時仍未關閉)記錄了一個案例:本機模型反覆用略有不同的網址抓同一個被封鎖的頁面,把整個迭代預算燒光,重複偵測完全沒觸發。原因是 Hermes Agent 比對的是「呼叫參數」,參數每次都不同,結果卻一模一樣。
四、上下文壓縮會不會讓 AI Agent 失憶?
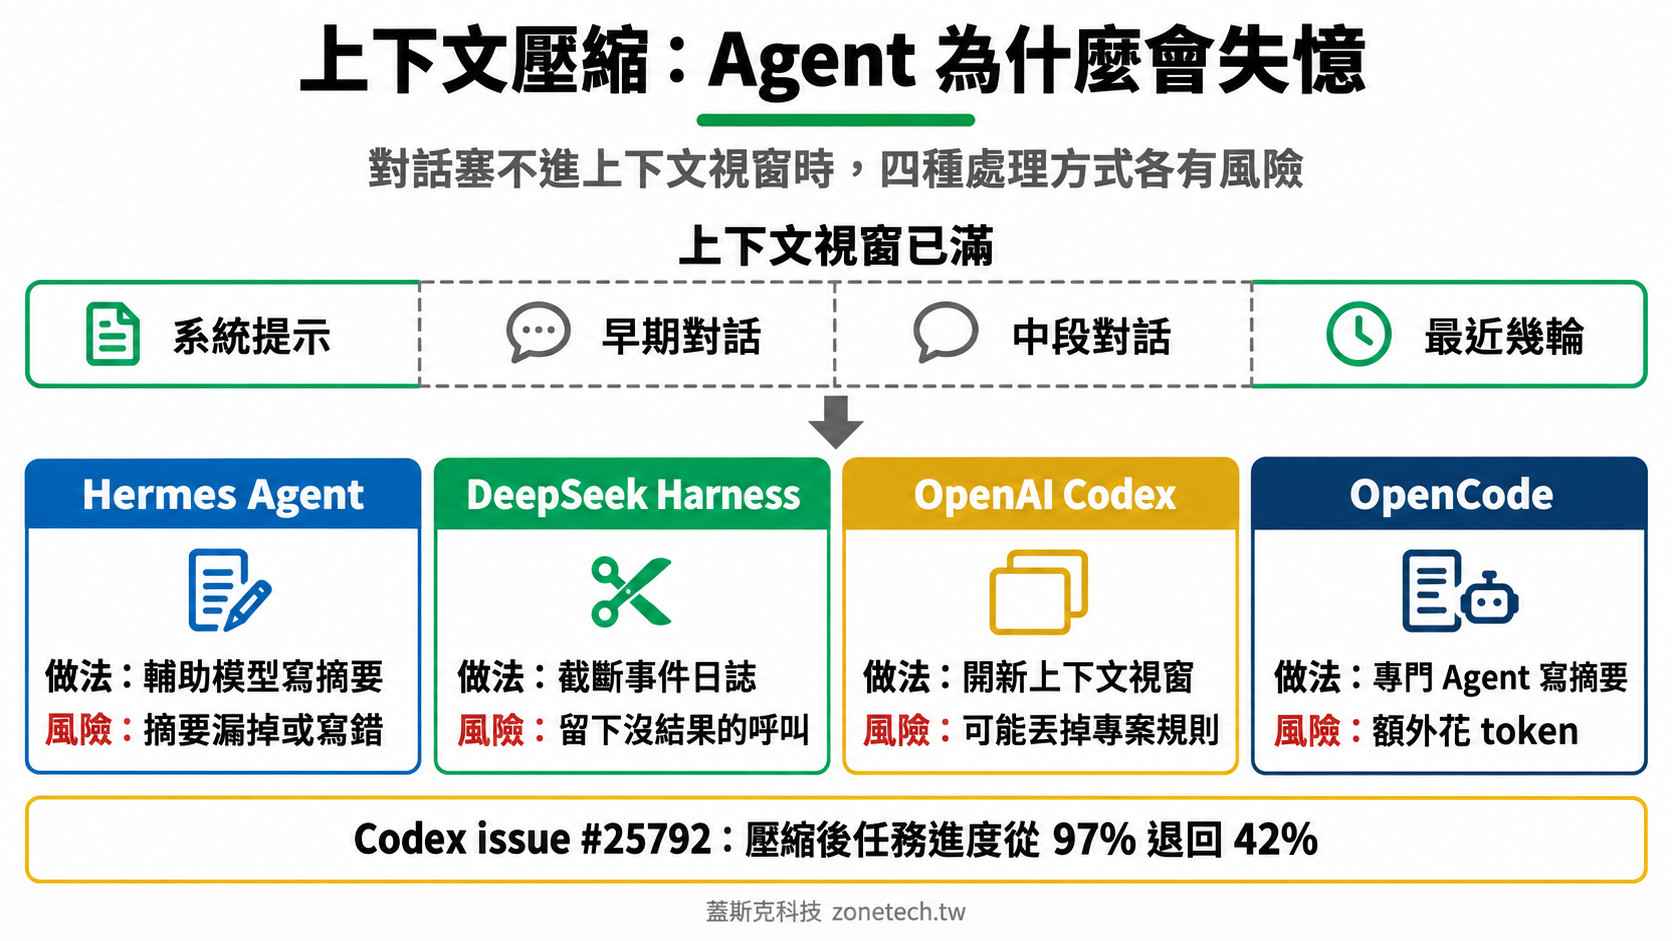
會,四個 harness 都有壓縮後遺失重要資訊的風險,而且都沒有機制檢查壓縮品質。對話越來越長、塞不進模型的上下文視窗時,harness 必須丟掉或摘要一部分內容,丟錯東西 Agent 就會重走老路。
| Harness | 壓縮方式 | 主要風險 | 適用情境 |
|---|---|---|---|
| Hermes Agent | 用便宜的輔助模型寫摘要,保留開頭與最近幾輪 | 摘要漏掉細節或寫錯,Agent 照錯的摘要繼續做 | 對話型、容許小誤差的任務 |
| DeepSeek Harness | 截斷事件日誌 | 截在工具呼叫與結果之間,會留下沒有結果的呼叫 | 需要事後稽核完整紀錄的任務 |
| OpenAI Codex | 開新的上下文視窗 | 等同失憶,可能丟掉專案規則 | 任務可切成獨立段落的情境 |
| OpenCode | 派一個專門的 Agent 寫摘要 | 最有彈性,但壓縮本身要額外花 token | 預算充足、重視延續性的任務 |
OpenAI Codex 的失憶代價有公開紀錄。Codex GitHub issue #25792(2026-06-02 提出)的標題直接寫出問題:壓縮後忘記 AGENTS 規則,任務進度從 97% 退回 42%。更早的 issue #9505(2026-01-19)也回報重要的早期上下文在壓縮時被刪除。
社群的使用經驗也呼應這點。Reddit r/hermesagent 一篇三個月使用心得(589 讚)的作者試遍所有記憶外掛後全部關掉,只保留 Hermes Agent 內建的 USER、MEMORY、SOUL 三個 Markdown 檔,他的結論是「Agent 不會記得,Agent 只會讀檔」。記憶方案怎麼選、怎麼避免規則被更新洗掉,可以參考AI Agent 記憶系統完全指南。
五、開源 AI Agent 裝進公司安全嗎?沙箱與預設外部服務要先查
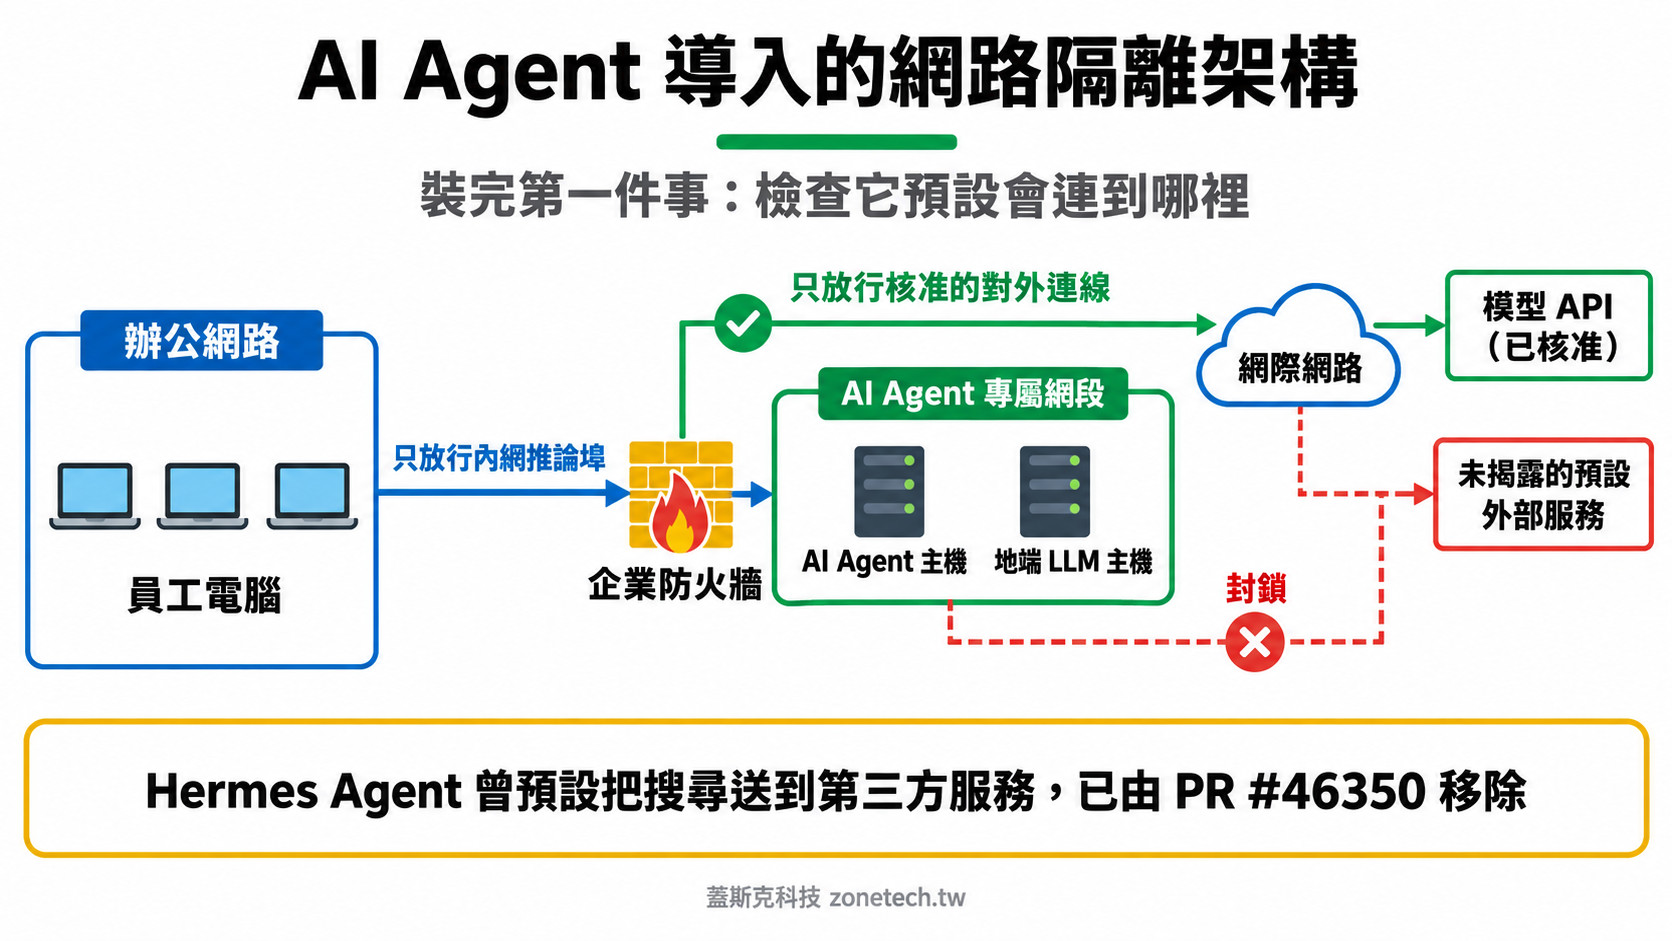
開源 AI Agent 最大的資安盲點不在沙箱,而在「預設會連到哪些外部服務」,裝完第一件事是檢查它的對外連線。四個 harness 的沙箱策略差異很大,但 2026 年 6 月的一起事件顯示,資料外流可能發生在使用者完全沒設定的地方。
| Harness | 安全策略 | 需要注意 | 適用情境 |
|---|---|---|---|
| Hermes Agent | 提示注入掃描、路徑檢查、擋內網位址、金鑰遮蔽、危險指令審批、改檔前自動快照 | Docker 不可用時會退回本機執行,可能在使用者沒發現時降級 | 願意逐項檢查設定的團隊 |
| DeepSeek Harness | 唯讀、工作區可寫、完全存取三種沙箱模式 | 知乎作者指出,無沙箱環境下工具仍可申請完全存取 | 在隔離的測試機上試用 |
| OpenAI Codex | 預設拒絕的沙箱+AI 審查者+四種審批模式 | 沙箱太嚴時一般開發工作也會卡住,要花時間調白名單 | 對資安要求最高的環境 |
| OpenCode | 沒有內建沙箱,靠 Agent 角色權限隔離 | 指令直接在本機執行,要搭配外部隔離 | 個人開發機或已有容器隔離的環境 |
Reddit r/hermesagent 在 2026 年 6 月出現一篇高互動貼文(848 讚),使用者發現 Hermes Agent 的網頁搜尋在沒設定任何金鑰的情況下,會把查詢送到 Parallel.ai 的服務。蓋斯克回 GitHub 查證,對應的 issue #45058 標題為「web_search/web_extract silently routes to Parallel.ai without user opt-in」,Nous Research 隨後以 PR #46350 移除這個免設定的預設值,並於 2026-06-14 合併。貼文作者另外指出,同一位貢獻者在 14 個以上的開源專案提交過類似修改,多數沒有揭露雇傭關係,這部分屬於貼文作者的調查,蓋斯克未逐一查證。
這起事件對企業的教訓很具體:導入任何開源 AI Agent,要先盤點它預設會連到哪些網址,並在防火牆層限制 Agent 主機的對外連線。地端 AI 主機的網段隔離、只放行必要對外連線的防火牆規則怎麼設,可以參考AI 防火牆建置指南。如果公司沒有人力做這一輪盤點,可以預約蓋斯克做 AI 導入前的資安健檢。
六、導入 AI Agent 最常犯的錯誤
大部分 AI Agent 導入失敗,問題出在沒有量測、沒有預算上限、沒有盤點對外連線,而不是選錯工具。下表整理社群討論中最常見的症狀與處理方向。
| 症狀 | 常見原因 | 解決方向 | 蓋斯克怎麼做 |
|---|---|---|---|
| API 帳單突然暴增 | Agent 繞圈重複呼叫,或快取命中率極低 | 設定每日 token 上限,檢查快取命中率 | 協助設定用量監控與告警門檻 |
| 做到一半開始重做已經完成的事 | 上下文壓縮丟掉進度與專案規則 | 把關鍵規則寫進固定讀取的檔案,任務切短 | 協助規劃 Agent 的規則檔與任務拆分方式 |
| Agent 說做完了,實際一堆問題 | 主動型 harness 傾向回報完成 | 用第二個 harness 稽核第一個的成果 | 協助建立交叉驗證流程 |
| 預設設定就在連外部服務 | 開源專案預設值含第三方服務 | 裝完先查對外連線,防火牆限制 Agent 主機 | 提供 AI 主機網段隔離與防火牆規則設定 |
| 版本更新後設定壞掉 | 專案仍在快速迭代,更新會破壞相容性 | 鎖定版本,更新前先在測試機驗證 | 協助建立測試環境與更新流程 |
「用第二個 harness 稽核第一個」這個做法來自 Reddit r/ClaudeCode 一篇對照 Claude Code 與 Codex 系統提示的討論(519 讚)。發文者比對後發現 Claude Code 的提示一直鼓勵模型主動判斷、主動往前推,Codex 的提示比較像在防止跑偏。留言區有使用者分享,Claude Code 回報功能完成後,會把它的說法貼給 Codex 請它找漏洞,常常能抓出沒做完的地方。
七、社群實際用起來,跟架構分析說的一樣嗎?
不完全一樣,蓋斯克在整合時找到四處架構分析與社群使用經驗互相矛盾的地方,導入前建議回官方文件確認。
| 項目 | 架構分析的說法 | 社群的使用經驗 | 蓋斯克的判讀 |
|---|---|---|---|
| Hermes Agent 能不能接本機模型 | 比較表標示「不支援」 | r/hermesagent 使用者用兩張 RTX 3090 跑 Gemma 與 Qwen 3.6 | 原文可能指沒有內建 Ollama 整合,實際可以接 |
| DeepSeek Harness 是否只能用 DeepSeek | 比較表標示「DeepSeek only」 | r/LocalLLaMA 使用者搭配 Qwen 使用 | 模型層本身是插件,換模型比表格寫的容易 |
| Codex 與 Claude Code 成本比較表 | 標示為 2026 年消融實驗 | 原文參考文獻對應的是 2025 年的 BountyBench | 年份與實驗性質對不上,引用前要回原論文查 |
| 哪個 harness 最好 | 依設計哲學分析各有取捨 | 三組實測的排名互相不一致 | 只能確定差距大,無法確定誰最好 |
社群對 DeepSeek Harness 的評價也很兩極。Reddit r/LocalLLaMA 一篇正面心得(268 讚)稱讚設定過程順暢,想接加密通訊軟體直接叫 Agent 自己接好;同一串留言也有人回報安裝時記憶體溢位、到現在沒有官方 CLI 介面。對 Hermes Agent 的批評則集中在功能越加越多:r/hermesagent 一篇批評文(180 讚)指出 MCP 斷路器門檻寫死在程式碼、插件不能改系統提示,預設開啟太多工具與技能讓行為難以預測。
八、地端模型搭不同 harness,網路實測表現如何?
公開原始數據最完整的一組地端實測顯示,同一個地端模型換 harness,程式碼品質沒有可量測的差異,耗時與輸出 token 卻差到將近 4 倍。社群實測多半透過雲端 API 呼叫模型,台灣企業更在意模型跑在公司內部主機時的表現,這組測試剛好補上這一塊。
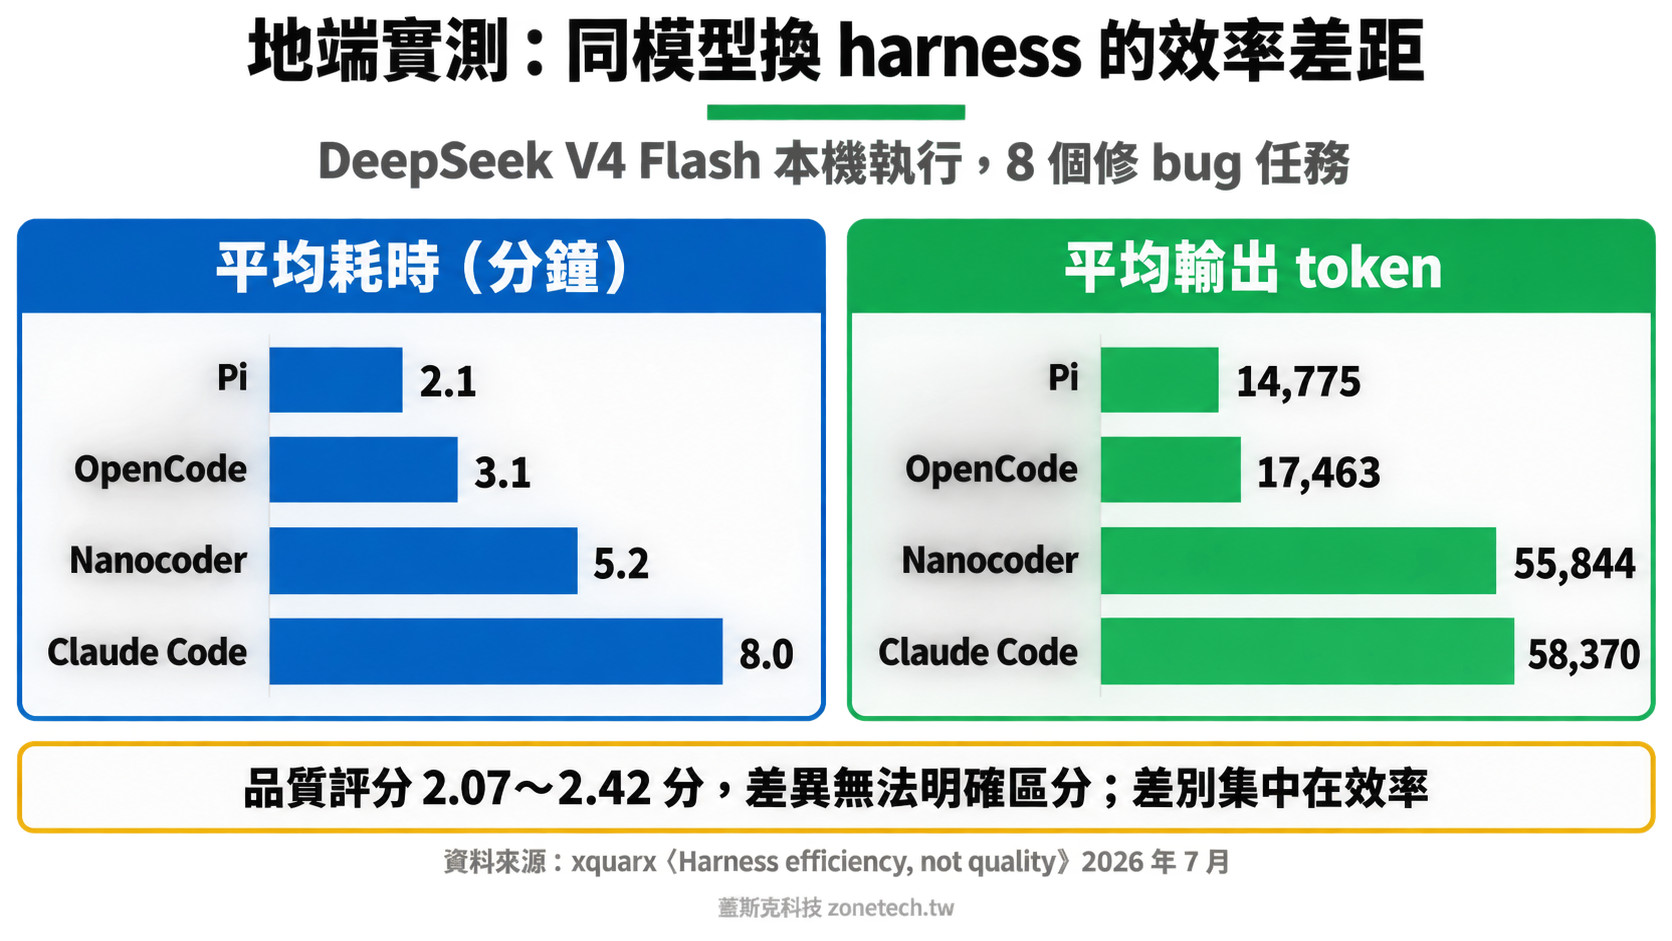
根據 Reddit 使用者 xquarx 在 2026 年 7 月發布的〈Harness efficiency, not quality〉完整測試報告,測試模型固定為 DeepSeek V4 Flash(High),發文者在 r/LocalLLaMA 的貼文中說明是以本機 vLLM 提供服務、速度約每秒 180 token。任務是 8 個真實程式碼錯誤修復,Pi、OpenCode、Claude Code 每個任務各跑 3 次、共 24 次,Nanocoder 每個任務跑 8 次、共 64 次,品質以統一標準評 0 到 3 分。
| 項目 | Pi(v0.80.10) | OpenCode(v1.17.10) | Claude Code(v2.1.186) | Nanocoder(v1.29.0) |
|---|---|---|---|---|
| 工具數 | 4 | 10 | 27 | 15 |
| 系統提示 token | 1,340 | 7,197 | 23,132 | 6,121 |
| 平均步驟數 | 28.0 | 16.6 | 37.9 | 37.4 |
| 平均輸出 token | 14,775 | 17,463 | 58,370 | 55,844 |
| 平均耗時 | 2.1 分鐘 | 3.1 分鐘 | 8.0 分鐘 | 5.2 分鐘 |
| 品質評分(0–3) | 2.34 | 2.07 | 2.42 | 2.25 |
| 適用情境 | 重視速度、想自己加工具的開發者 | 需要分派子任務、換模型的團隊 | 願意用時間換主動探索的大型專案 | 想要介於兩者之間的輕量選擇 |
作者的結論是四個 harness 的品質分數在 95% 信心區間內「無法乾淨分開」,差別幾乎全部落在效率:Claude Code 平均耗時是 Pi 的約 3.8 倍,平均輸出 token 是 Pi 的約 4 倍。報告同時指出,Claude Code 系統提示的大宗是 27 個工具的說明文字,工具越多,每一輪都要重送的內容就越多。
這組數字對地端部署的意義比對雲端更直接。雲端 API 多花的 token 會變成帳單;地端主機多花的 token 會變成 GPU 被佔住的時間,一台主機能同時服務的人數跟著變少。同一台主機要給全公司共用時,harness 的精簡程度幾乎等於主機的有效產能。推論框架怎麼撐多人併發,可以參考Ollama 可以上企業生產環境嗎;主機規格則可以對照地端 LLM 主機大車拼。
社群另有幾則單一使用者的經驗分享,參考價值較低,但能看出討論方向。r/singularity 一篇貼文(336 讚)分享用 Hermes Agent 搭 DeepSeek V4 Flash,一個提示跑了 32 分鐘、花費 US$0.07,留言區有多位使用者表示照做也做不出同樣結果。r/ClaudeCode 一篇熱門貼文(1,680 讚)宣稱在 Pi 上跑 22GB 的地端 Qwen 模型,修 bug 表現勝過 Claude Opus 5,最高讚的反駁留言則指出地端模型速度慢很多,比較時漏掉耗時等於漏掉一半的決策條件。
公司還沒決定模型要跑在雲端還是內部主機,可以先看地端 LLM 建置完整指南,掌握硬體、模型、部署框架的決策順序。要注意 harness 與推論框架是兩層不同的東西:harness 決定 Agent 怎麼做事,Ollama、vLLM 這類推論框架決定模型怎麼跑,兩層都要選對,地端 AI Agent 才跑得動。
九、AI Agent harness 怎麼選?依情境建議
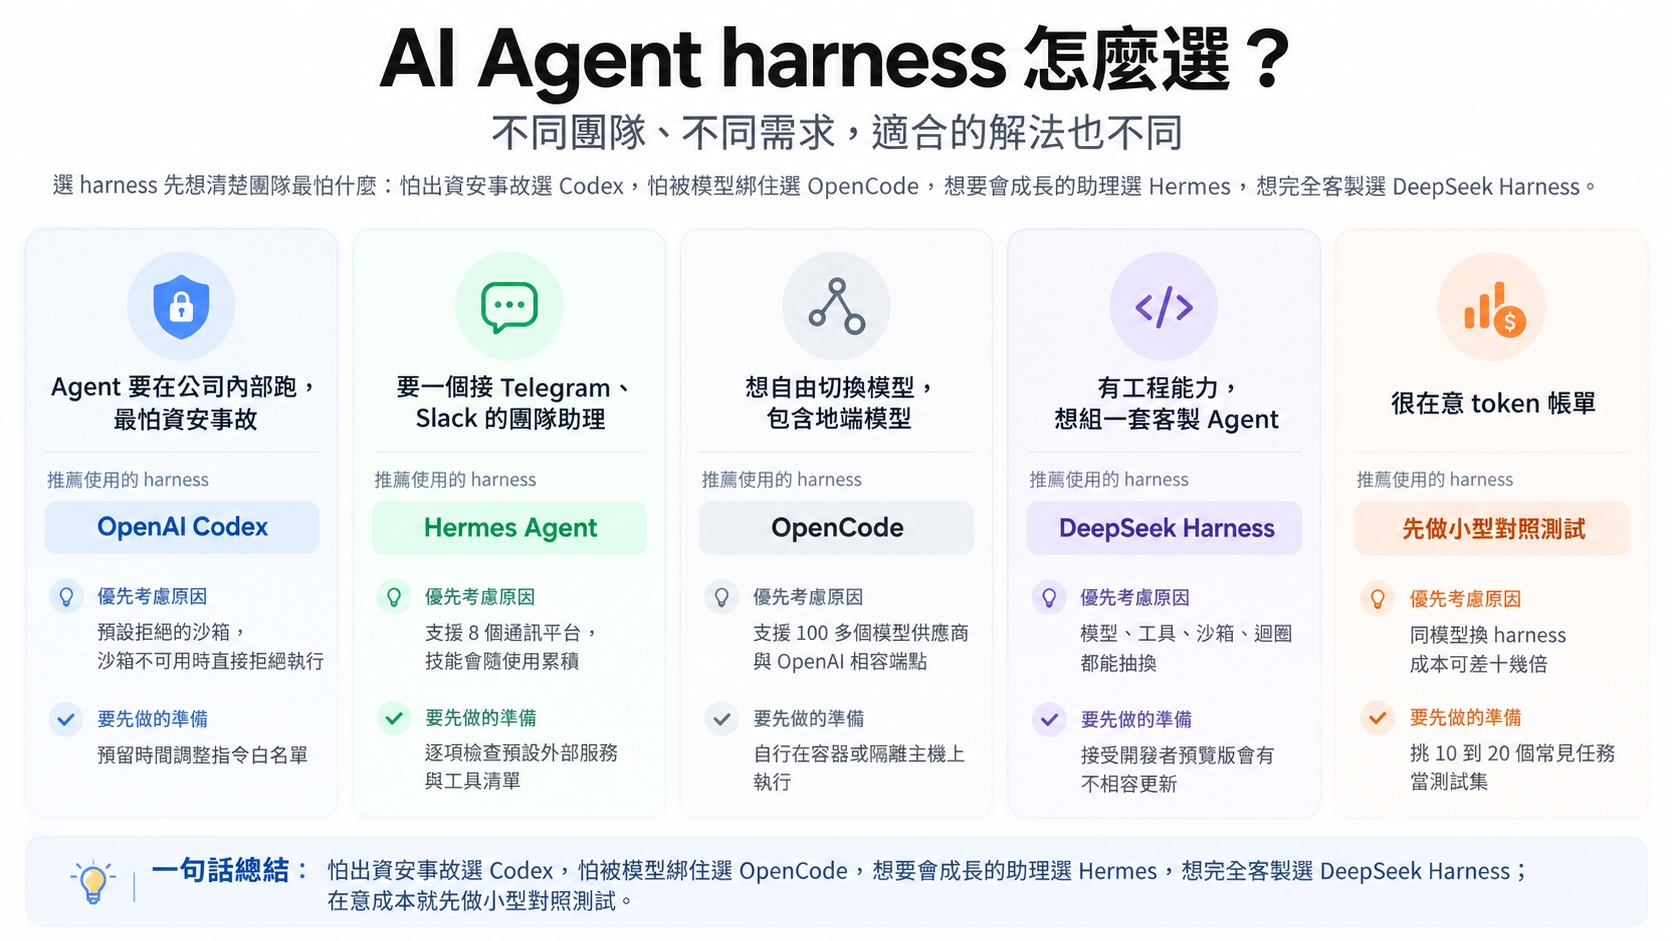
選 harness 先想清楚團隊最怕什麼:怕出資安事故選 Codex,怕被模型綁住選 OpenCode,想要會成長的助理選 Hermes,想完全客製選 DeepSeek Harness。
| 團隊情況 | 優先考慮 | 原因 | 要先做的準備 |
|---|---|---|---|
| Agent 要在公司內部跑,最怕資安事故 | OpenAI Codex | 預設拒絕的沙箱,沙箱不可用時直接拒絕執行 | 預留時間調整指令白名單 |
| 要一個接 Telegram、Slack 的團隊助理 | Hermes Agent | 支援 8 個通訊平台,技能會隨使用累積 | 逐項檢查預設外部服務與工具清單 |
| 想自由切換模型,包含地端模型 | OpenCode | 支援 100 多個模型供應商與 OpenAI 相容端點 | 自行在容器或隔離主機上執行 |
| 有工程能力,想組一套客製 Agent | DeepSeek Harness | 模型、工具、沙箱、迴圈都能抽換 | 接受開發者預覽版會有不相容更新 |
| 很在意 token 帳單 | 先做小型對照測試 | 同模型換 harness 成本可差十幾倍 | 挑 10 到 20 個常見任務當測試集 |
結論
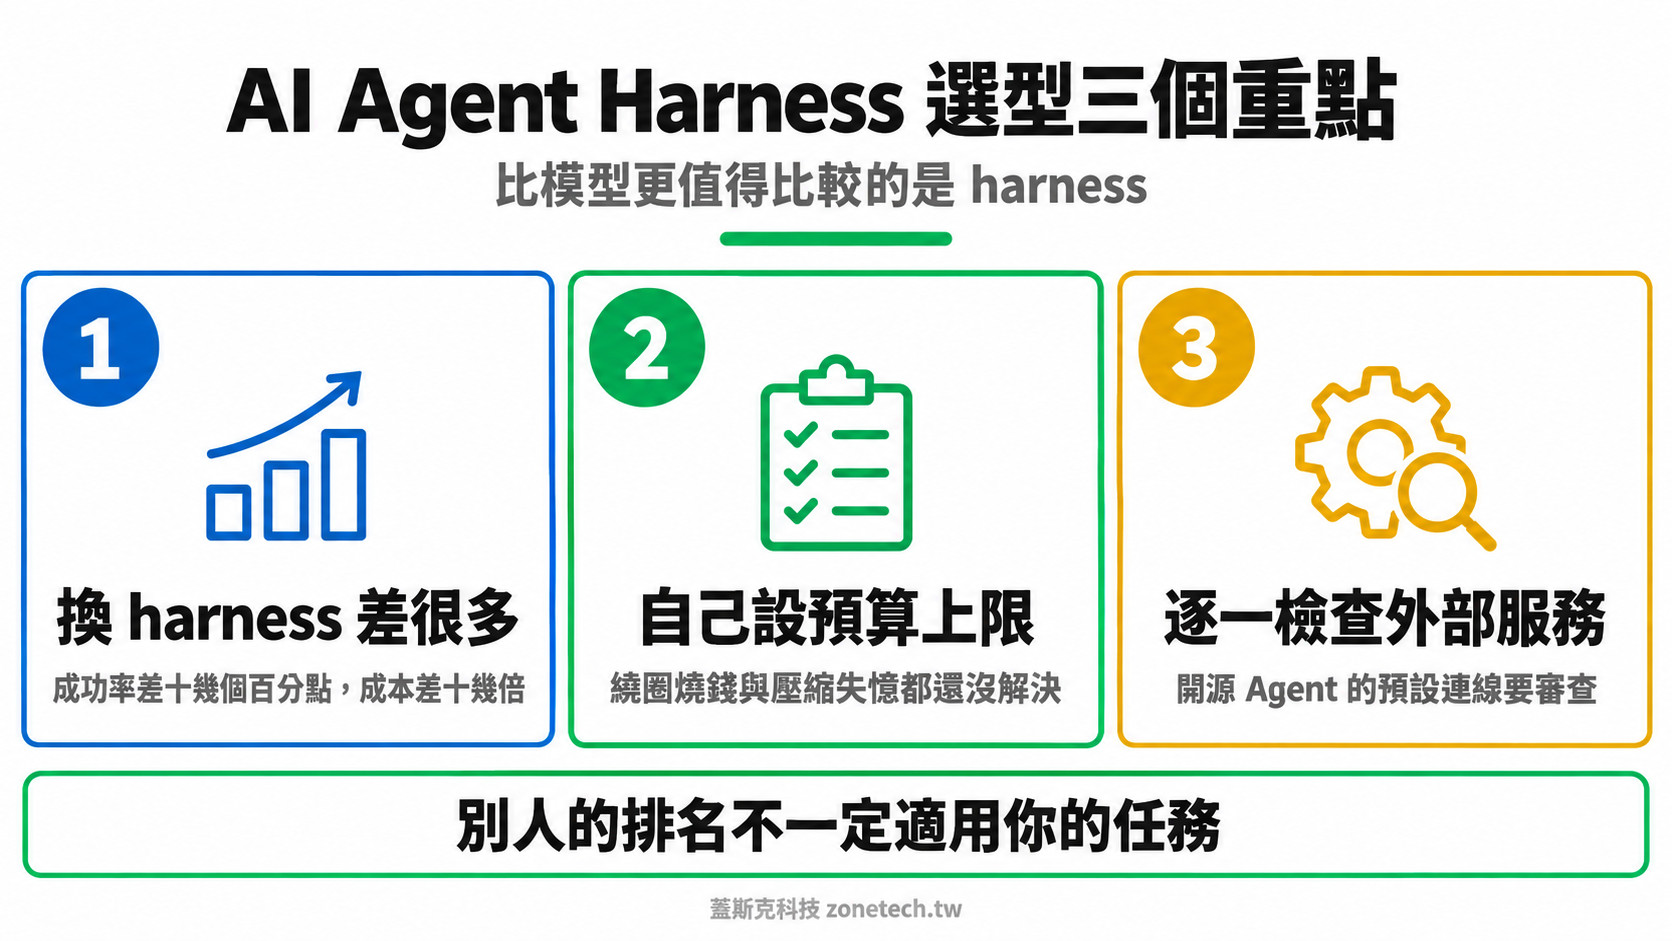
2026 年導入 AI Agent,比模型更值得花時間比較的是 harness。三個重點帶走:第一,同一個模型換 harness,社群實測的成功率差到十幾個百分點、成本差到十幾倍,別人的排名不一定適用你的任務。第二,四個主流 harness 都沒解決繞圈燒錢與壓縮失憶,企業要自己設預算上限與規則檔。第三,開源 Agent 的預設外部服務要逐一檢查,Hermes Agent 的 Parallel.ai 事件就是實例。
立即開始:你的 AI Agent 值得一套跑得穩又不亂花錢的外殼
蓋斯克科技協助台灣企業規劃地端 LLM 主機、網路隔離與 AI 導入流程,從單台主機到全公司共用的內部 AI 服務都能協助評估。
我們提供:
- 依你們的任務類型與模型,建議適合的 AI Agent harness
- 地端模型主機與 harness 的搭配評估,含 2026 年硬體市場報價或估算假設
- AI 主機網段隔離與對外連線防火牆規則
- 透明報價,無隱藏費用
團隊裝了 AI Agent,卻不確定它在做什麼、花了多少、連到哪裡?
蓋斯克科技專注台灣中小企業 IT 基礎建設,協助企業把 AI Agent 導入到公司網路裡跑得穩、看得見、管得住。
預約 AI 導入評估 免費預約諮詢電話:02-2717-1019 LINE:@zonetech
關於作者
Gask Hung|蓋斯克科技創辦人,專注台灣中小企業 IT:企業 Wi-Fi、4K 剪輯系統、IT 委外與設備租賃,近期投入地端 LLM 導入評估。完整作者介紹
延伸閱讀:AI Agent 記憶系統完全指南|AI Agent 的企業級進化|DeepSeek 地端部署指南|AI 導入諮詢
參考資料:知乎專欄〈Hermes、Deepseek Harness、Codex、OpenCode 四个AI Agent架构深度对比〉,2026-08-19|GitHub:Hermes Agent、DeepSeek Harness、OpenAI Codex、OpenCode(追蹤數與授權查詢日 2026-09-15)|Shi 等人〈A Programming Paradigm for Spatiotemporal Composability〉