作者:黃俊凱 Gask Hung|發布:2026-10-06|最後更新:2026-10-06
Mac Studio 出字比較快,DGX Spark 讀長文比較快,差別來自記憶體頻寬與算力的取捨。M3 Ultra 的記憶體頻寬是 819 GB/s、M4 Max 是 546 GB/s,DGX Spark 只有 273 GB/s,單人對話時 Mac 通常快兩到三倍。DGX Spark 則有 1 PFLOP 的 FP4 算力和完整的 CUDA 生態,處理長文件、影像生成、微調,或開發完要搬上 NVIDIA 伺服器時,它順手很多。
📋 本文重點摘要
- 頻寬:M3 Ultra 819 GB/s、M4 Max 546 GB/s、DGX Spark 273 GB/s,單人對話的出字速度大致照這個比例。
- 算力:DGX Spark 有 1 PFLOP FP4 算力,處理長輸入(預填充)與多人並發明顯較快。
- 生態:DGX Spark 跑 Linux 與 CUDA,vLLM、TensorRT-LLM、影像生成工作流直接能用;Mac 走 MLX,影片生成容易卡在只支援 CUDA 的節點。
- 容量:要單機放進 200B 以上模型得選大記憶體 Mac,但 M3 Ultra 的 256GB/512GB 版本已停售,新機要看 M5 Ultra。
- 價格:DGX Spark 2026 年 2 月漲到 4,699 美元,Mac Studio M3 Ultra 美國市價約 5,299 美元,兩邊都缺貨。
👤 適合閱讀對象
- 預算 4,000 到 6,000 美元、要選一台本地 AI 主機的工程師或研究員:想知道兩條路線各自的強項與代價。
- 評估部門共用 AI 主機的技術主管:要決定是個人工作站路線,還是放在辦公室常開的推論服務。
- 手上已有 M 系列 Mac 的使用者:在考慮升級到大記憶體 Mac Studio,或改買 DGX Spark。
還在 DGX Spark 和 Mac Studio 之間猶豫?加 LINE 告訴我們你要跑的模型和主要用途,我們先幫你算哪一台跑得動、跑多快 → 加 LINE 諮詢
一、DGX Spark 和 Mac Studio 規格差在哪?
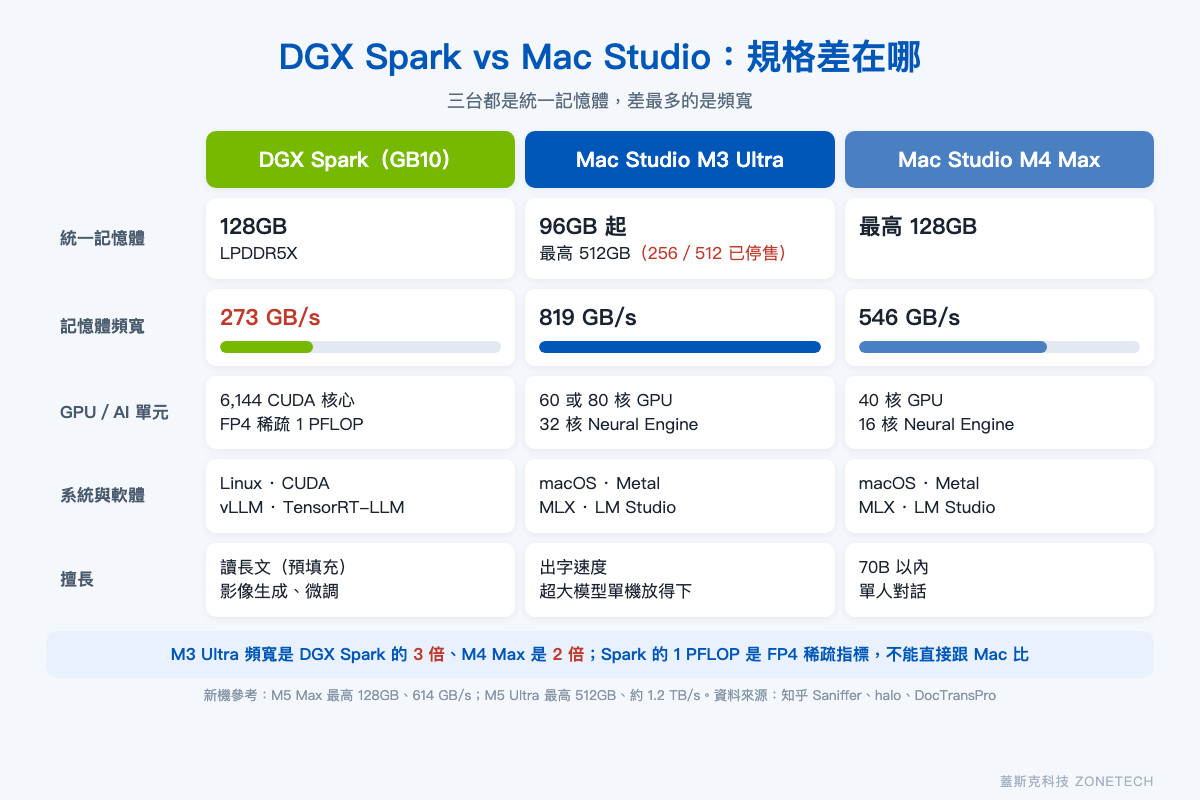
三台都是統一記憶體,CPU 和 GPU 共用同一塊,差最多的是頻寬:M3 Ultra 是 DGX Spark 的三倍,M4 Max 是兩倍。一位自己有 DGX Spark 的知乎作者 Saniffer 下了很準的定位:Mac Studio 像一台有超大共享記憶體的全能專業工作站,DGX Spark 則像一台縮小到桌面上的 CUDA AI 開發伺服器。
| 項目 | DGX Spark(GB10) | Mac Studio M3 Ultra | Mac Studio M4 Max |
|---|---|---|---|
| 統一記憶體 | 128GB LPDDR5X | 96GB 起,最高 512GB | 最高 128GB |
| 記憶體頻寬 | 273 GB/s | 819 GB/s | 546 GB/s |
| GPU | Blackwell,6,144 個 CUDA 核心 | 60 或 80 核 | 40 核 |
| AI 專用單元 | 第五代 Tensor Core,FP4 稀疏 1 PFLOP | 32 核 Neural Engine | 16 核 Neural Engine |
| 網路 | 10GbE+兩個 200Gb QSFP(ConnectX-7) | 10GbE、Thunderbolt 5 | — |
| 系統與軟體 | Linux、CUDA、vLLM、TensorRT-LLM | macOS、Metal、MLX | macOS、Metal、MLX |
- 1 PFLOP 不能拿來跟 Mac 比:這是 FP4 低精度加稀疏運算的條件下量到的,蘋果沒有公布可以直接對比的數字。GB10 的 AI 效能大約落在 RTX 5070 與 5070 Ti 之間。
- Mac 的 Neural Engine 通常不跑大模型:本地跑 LLM 主要靠 GPU 與統一記憶體,MLX 也主要把計算放在 CPU 和 GPU。
- 功耗不同:DGX Spark 整機約 140W,用外接 240W USB-C 供電;M3 Ultra 峰值約 250W。
規格有一處要留意:多數文章寫所有 M3 Ultra 都是 819 GB/s,但也有一篇 2025 年 3 月的文章寫 96GB 版只有 400 GB/s,購買低配版前請對照蘋果官方規格頁。M5 世代的新機規格為 M5 Max 最高 128GB、614 GB/s,M5 Ultra 最高 512GB、約 1.2 TB/s。資料來源:知乎〈512GB 蘋果 Mac Studio 能替代英偉達 DGX Spark 嗎?〉、〈128GB 以上統一內存的 Mac Studio,哪一代真正能跑大模型?〉、〈別買錯了,Mac 的統一內存≠顯存!〉。
二、出字速度:為什麼 Mac Studio 比較快?
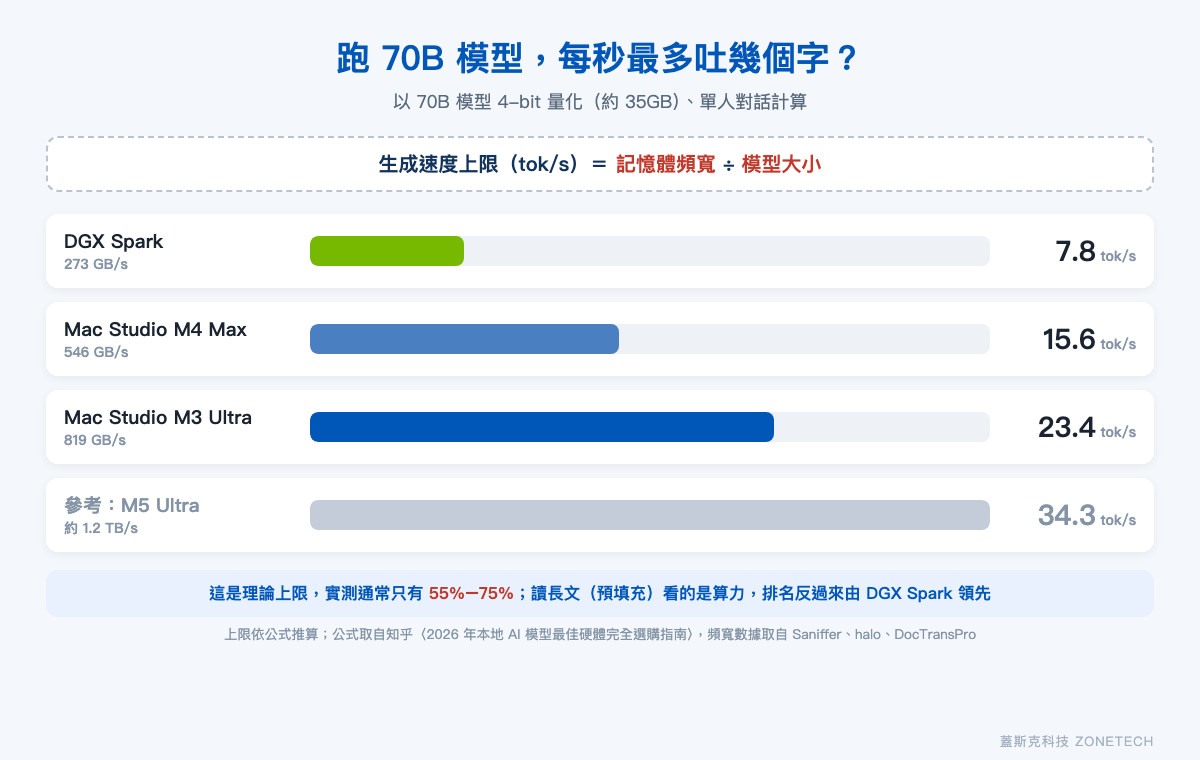
生成每一個字,都要把整個模型的權重從記憶體讀一遍,所以出字速度的上限就是頻寬除以模型大小。以 70B 模型 4-bit 量化(約 35GB)為例,DGX Spark 的上限約每秒 7.8 個 token,M4 Max 約 15.6,M3 Ultra 約 23.4。實測通常只有上限的 55% 到 75%,被快取讀寫與框架開銷吃掉。
| 機器 | 模型與設定 | 生成速度(tok/s) | 來源 |
|---|---|---|---|
| DGX Spark | Llama 3.1 70B,FP8 | 2.7 | 黃黃黃先森 |
| DGX Spark | Qwen3.8-27B,Q8,29GB | 6.8 | 大兵 |
| DGX Spark | GPT-OSS 20B,MXFP4,Ollama | 49.7 | 黃黃黃先森 |
| M3 Ultra 512GB | 70B,4-bit | 11–12 | 太平洋的水 |
| M3 Ultra 512GB | QwQ 32B,4-bit,32K 上下文 | 36.9 | 太平洋的水 |
| M3 Ultra 512GB | 8B 級,4-bit | 110–135 | 太平洋的水 |
| M3 Ultra 512GB | DeepSeek R1 671B,4-bit | 約 20 | 太平洋的水 |
這張表的模型、量化與框架都不一樣,不能逐列比大小,但方向很一致:稠密的大模型在 DGX Spark 上生成很慢,70B FP8 只有 2.7 tok/s,跟公式算出的上限吻合。
例外是混合專家(MoE)模型。MoE 每個 token 只啟用一小部分參數,要讀的權重少很多,所以在 DGX Spark 上跑 MoE 比跑稠密模型快得多。Reddit 用戶 zzsf 拿兩台 DGX Spark(ASUS GX10)對比 M5 Max 128GB 與 M3 Ultra 512GB,結果在 DeepSeek V4 這類 MoE 模型上,Spark 的生成速度跟 M5 Ultra 的推算值接近,但換到 Qwen3.6 的 MoE 模型就明顯落後。差距要看模型,買之前先找你主力模型的實測。
知乎作者虞大膽用同一個 Qwen 3.8 27B 對比 M4 Max 與 DGX Spark:M4 Max 頻寬是 Spark 的一倍多,但 GPU 算力有限,首字延遲比不上 DGX Spark,上下文越長差距越明顯;他也提到 llama.cpp 在部分設備上有 bug,這組測試沒辦法做到完全一致的比較。資料來源:知乎〈M4 Max Mac Studio 跑 Qwen 3.8 27B 推理實測〉、Reddit r/LocalLLM 串 1w93ap4。
三、讀長文與多人並發:DGX Spark 的主場
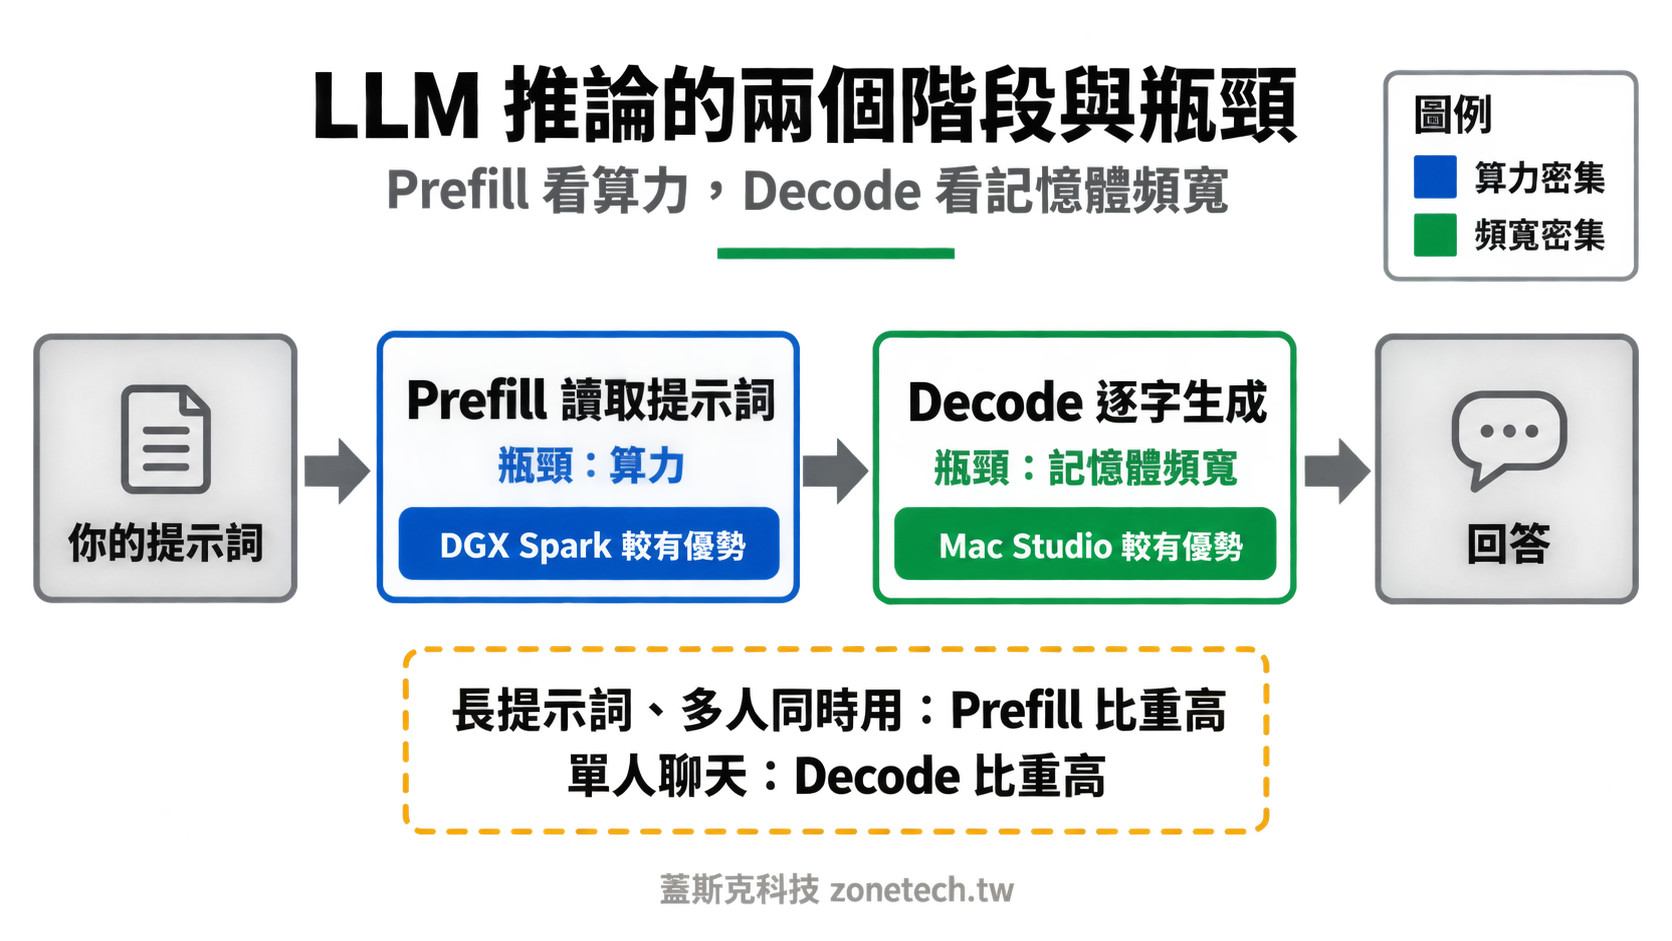
處理長輸入的「預填充」階段吃的是算力,排名在這裡反過來,DGX Spark 明顯較快。一份硬體選購指南舉了一個很有感的例子:128K token 的提示詞,蘋果晶片要處理好幾分鐘,高算力的 NVIDIA 卡只要幾秒。要把整份合約、整個程式庫丟進去問問題的人,這個差距比出字速度更重要。
| DGX Spark 實測 | 預填充(tok/s) | 生成(tok/s) |
|---|---|---|
| Llama 3.1 8B,FP8,SGLang,單人 | 7,991 | 20.5 |
| Llama 3.1 8B,FP8,SGLang,32 人並發 | 7,949 | 368(總量) |
| GPT-OSS 20B,MXFP4,Ollama | 2,053 | 49.7 |
| Llama 3.1 70B,FP8 | 803 | 2.7 |
多人同時用時,DGX Spark 的算力才真正發揮。上表同一個 8B 模型,單人只有 20.5 tok/s,32 人並發的總吞吐到 368 tok/s。Dendro Logic 的測試更極端:256 個並行連線下的總吞吐量是單人測試的 120 倍,細節可以參考DGX Spark 並發效能實測。要放在辦公室給一群人共用,看的是這種數字。
另一個常被忽略的差異是散熱。DGX Spark 用外接電源,機身內部有較大的散熱空間,評測者認為長時間運作比 Mac mini、Mac Studio 這類精簡機身有優勢,後者在類似測試中出現過降頻。資料來源:知乎〈NVIDIA DGX Spark 深度評測:個人超算的新標準〉、〈2026 年本地 AI 模型最佳硬體完全選購指南〉、Dendro Logic NVIDIA DGX Spark Concurrency Benchmark。
四、軟體生態:CUDA 還是 MLX?
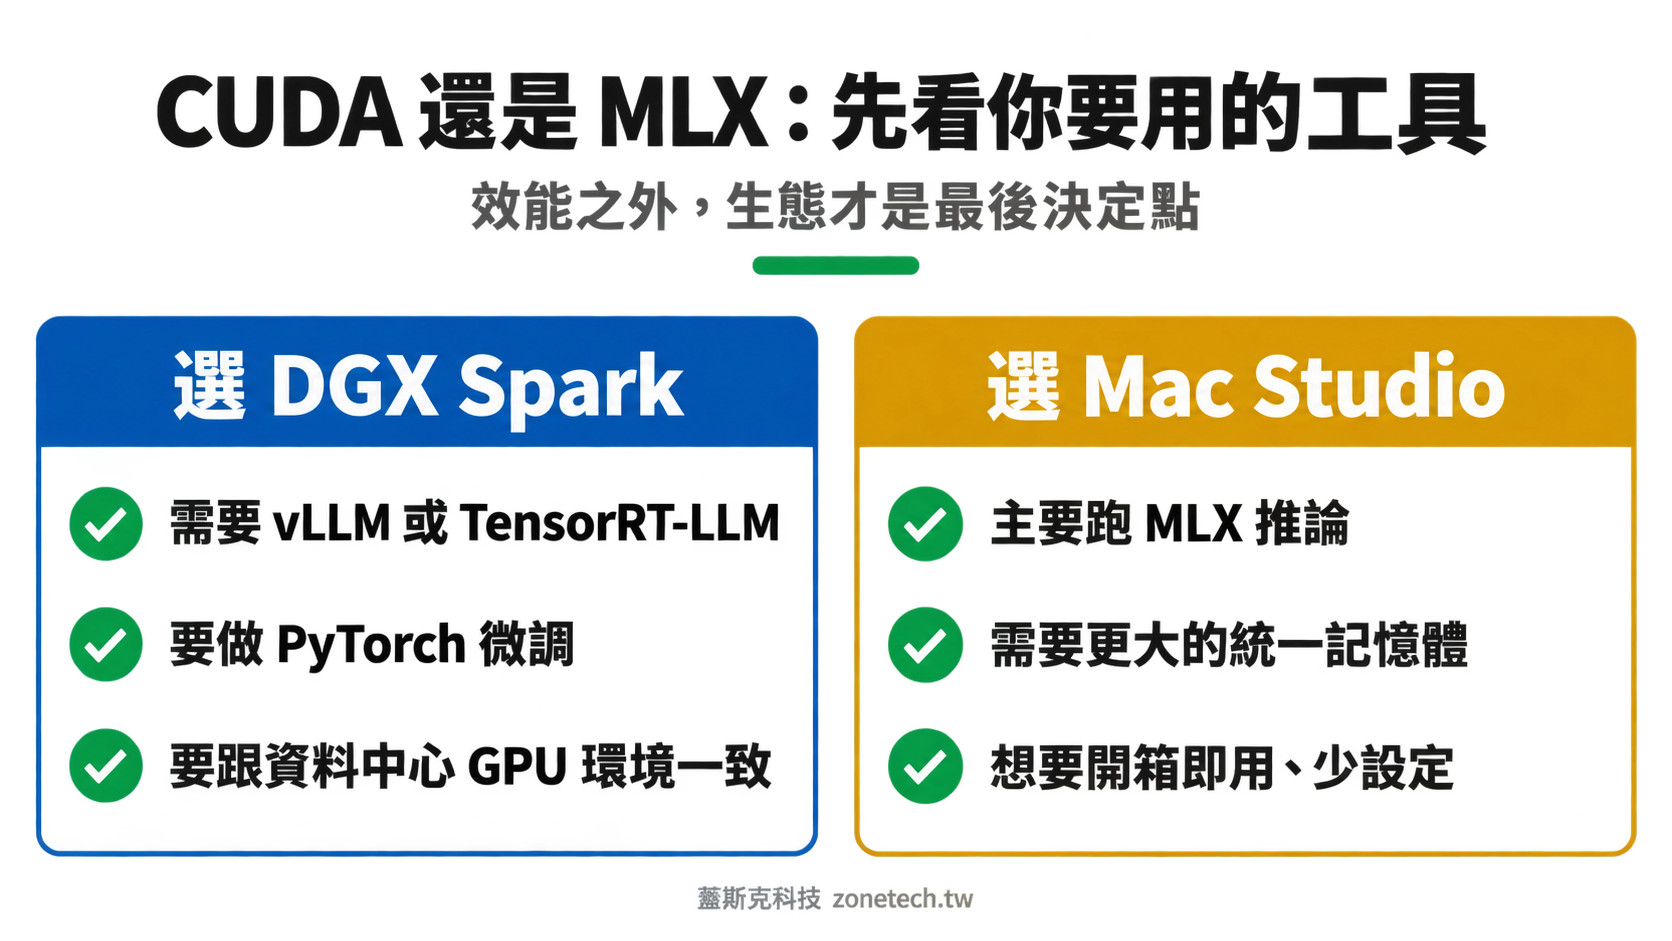
CUDA 仍然是 AI 開發的主航道,DGX Spark 上驗證過的模型搬到 H100、H200 或 RTX PRO 伺服器幾乎不用改。Mac 的 Metal、MLX 是另一條技術路線,模型可以轉過去跑,但跟企業常見的 CUDA 伺服器不是同一套開發與部署環境。
| 工作 | DGX Spark | Mac Studio |
|---|---|---|
| 本地大模型對話 | vLLM、SGLang、TensorRT-LLM、Ollama | MLX、LM Studio、Ollama、llama.cpp |
| 開發完搬到 NVIDIA 伺服器 | 同一套 CUDA 環境,幾乎不用改 | 要換一套工具鏈 |
| 圖片與影片生成 | 多數工作流先支援 CUDA | 只寫了 CUDA 的節點會報錯或退回慢速 |
| Whisper 語音轉寫 | faster-whisper 可用,要對齊 Arm 與 CUDA 版本 | 改用 MLX Whisper |
| 影片剪輯與編碼 | 1 組 NVENC、1 組 NVDEC | M3 Ultra 有 4 組編碼、4 組 ProRes 引擎 |
| 辦公室常開的共用服務 | Linux、SSH、Docker,天生就是伺服器 | 做得到,但比較像個人工作站 |
- MLX 生態在快速追趕:Ollama 在 2026 年 3 月把 Mac 後端換成 MLX,符合條件的機器生成速度接近翻倍。只用 Ollama 跑模型的人,Mac 的體驗已經比一年前好很多。
- DGX Spark 的坑在平台太新:它是 Arm 加 Blackwell,不是一般 x86 電腦加顯卡。Arm64、CUDA、cuDNN 與各套件的版本任何一個沒對上,就會出現硬體很強、軟體暫時跑不起來的狀況。
- 微調:NVIDIA 給 DGX Spark 的定位是最高 70B 級模型微調、200B 級模型推論,微調要搭配 LoRA 這類省記憶體的方法。Mac 也做得到 LoRA,但工具與教學資源仍以 CUDA 一側為多。
五、要跑更大的模型:串接與叢集
兩邊都能串接,但實測的擴充效率都不高,單機放不下的模型才值得串,不要期待兩台就快兩倍。
DGX Spark 每台有兩個由 ConnectX-7 驅動的 200Gb QSFP 埠,NVIDIA 官方說單台支援最高 200B 參數推論,兩台串起來可以跑 405B。這是標準的資料中心網卡,常見的分散式推論框架都能直接用,接法可參考DGX Spark 雙機 200G 網路設定指南。
Mac Studio 用 Thunderbolt 5 串接,關鍵在 RDMA。知乎上這個題目最高讚的回答整理了 Jeff Geerling 的實驗:四台 Mac Studio 串成 1.5TB 記憶體跑 671B 的 DeepSeek V3.1,單台 21.1 tok/s,四台約 31 tok/s。硬體加到四倍,速度只多不到五成。
- 要用 RDMA 才快:走 TCP 延遲約 300 微秒,RDMA 只要 30 到 50 微秒。macOS 新增了給 MLX 用的 RDMA API,Exo 框架先用上了,但它的 RDMA 程式碼還沒開源。
- 不是每個埠都能用:每台 Mac Studio 有 6 個 Thunderbolt 5,目前只有 3 個能走 RDMA。
- llama.cpp 幾乎沒受惠:它用自己的 RPC 協定走 TCP,用 Thunderbolt 5 只比 2.5GbE 乙太網快約一成。
- 也能混著用:有人把兩台 DGX Spark 與一台 256GB M3 Ultra 用 llama.cpp RPC 組成異構叢集,名義記憶體合計 512GB。
六、價格與供貨:M3 Ultra 大記憶體版已經停售
兩邊都在漲價、都缺貨,而且 M3 Ultra 的 256GB 與 512GB 版本已經買不到新機。美國市價上,DGX Spark 約 4,699 美元,Mac Studio M3 Ultra 約 5,299 美元。
| 機型 | 價格 | 供貨狀況 |
|---|---|---|
| DGX Spark 128GB | 2026 年 2 月從 3,999 漲到 4,699 美元(+17.5%) | 供應保守,下一代最快 2027 年第四季 |
| Mac Studio M3 Ultra | 約 5,299 美元(2026 年 6 月市價) | 256GB 與 512GB 版本已取消 |
| Mac Studio M3 Ultra 512GB | 中國大陸到手約 8 萬人民幣 | 已停售,只剩庫存或二手 |
| Mac Studio M5 Ultra 256GB | 中國大陸約 76,999 人民幣 | 現行新機 |
供貨是現在最大的變數。據知乎的硬體比較文,庫克在 2026 年 5 月的財報會上承認 Mac mini 與 Mac Studio 因 AI 需求暴增供應受限,最高配機型的交期一度拉長到 13 到 14 週;全球記憶體短缺也讓蘋果在 2026 年 6 月 25 日調漲 Mac 價格。M4 Max 128GB 的近期報價本篇沒有查到可靠來源。
DGX Spark 在台灣的購買管道、價格與採購陷阱,可以參考DGX Spark 台灣完整購買指南;Mac Studio M5 世代的配置選擇,可以參考Mac Studio M5 Max/M5 Ultra 跑地端 LLM 實測整理。
七、該選哪一台?七種情境對照
先想清楚主要用途:跟模型對話為主選 Mac Studio;要讀長文、生影像、微調,或開發完要搬上 NVIDIA 伺服器,選 DGX Spark。
| 你的主要用途 | 建議 | 理由 |
|---|---|---|
| 一個人跟 70B 以內的模型對話、寫文字 | Mac Studio M4 Max | 頻寬是 Spark 的兩倍,出字較快 |
| 單機要放進 200B 以上的模型 | Mac Studio 大記憶體版 | 128GB 的 Spark 放不下;M3 Ultra 大記憶體版已停售,新機看 M5 Ultra |
| 把整份合約或程式庫丟進去問 | DGX Spark | 長輸入的預填充靠算力,Spark 明顯較快 |
| 圖片與影片生成(ComfyUI) | DGX Spark | 工作流大多先支援 CUDA,Mac 容易卡在節點上 |
| 微調模型,或開發完要上線到 NVIDIA 伺服器 | DGX Spark | 同一套 CUDA 環境,搬過去不用改 |
| 辦公室常開、多人共用的推論服務 | DGX Spark | Linux 伺服器形態,並發吞吐高 |
| 影片剪輯為主,偶爾跑模型 | Mac Studio | 多組編碼與 ProRes 引擎,一台做完整個流程 |
- 選了 DGX Spark,就優先跑 MoE 模型:稠密的 27B 在 Spark 上只有個位數 tok/s,MoE 體驗差很多。
- 只跑 Whisper 或 32B 級模型,不必追大記憶體:為了跑 Whisper 買 512GB 是嚴重過剩,真正需要的是軟體適配與穩定的 GPU 加速。
- 裝得下不等於跑得動:671B 的模型放得進 512GB,生成卻只有約 20 tok/s。買之前先用公式算一下你要跑的模型在這台機器上最快能到多少。
八、蓋斯克怎麼評估
本篇的效能數字都來自文末參考資料的公開實測與原廠規格。[需提供蓋斯克的實際評估流程或客戶導入案例:客戶用途、最後選的機型與記憶體、上線後的實際速度與遇到的問題。若暫無,發佈時可刪除本節。]
結論:先看用途,再看頻寬,最後才看記憶體大小
- 對話選 Mac,開發選 Spark:單人出字速度 Mac 快兩到三倍;長輸入、多人並發、影像生成與 CUDA 工具鏈是 DGX Spark 的主場。
- 頻寬決定出字速度:用「頻寬 ÷ 模型大小」就能估出上限,比看記憶體容量或 TOPS 更準。
- 先確認買得到:M3 Ultra 大記憶體版已停售、兩邊都在漲價,下單前先確認配置與交期,不確定就先租來測。
立即開始:用你的模型算清楚哪一台跑得動
蓋斯克科技協助台灣企業評估地端 AI 基礎建設,從桌上型 AI 主機到多人共用的推論服務,依實際使用情境給建議,不先推銷特定機種。
我們提供:
- 依你要跑的模型、上下文長度與使用人數,估算兩台機器的實際速度
- DGX Spark 與 Mac Studio 的配置建議與採購陷阱提醒
- 租用與採購兩種路線並陳,先用真實工作量測過再決定
- 透明報價,無隱藏費用
📌 DGX Spark 還是 Mac Studio,想先租來測再決定?
蓋斯克科技提供企業設備租賃與地端 AI 導入評估,先用你的模型與工作量實測,再決定要不要投資硬體。
了解設備租賃方案 免費預約諮詢📞 電話:02-2717-1019 LINE:@zonetech
參考資料
- 512GB 蘋果 Mac Studio 能替代英偉達 DGX Spark 嗎?真正的差距不在內存大小(Saniffer,知乎,2026-07-21)
- 本地跑 700GB 大模型,Mac Studio 和 DGX Spark(GB10)怎麼選?(杞鋂的回答,知乎)
- 同問題:DGX Spark 與 Mac 的 llama.cpp RPC 異構叢集(知乎)
- 128GB 以上統一內存的 Mac Studio,哪一代真正能跑大模型?(halo,知乎,2026-06-04)
- M4 Max Mac Studio 跑 Qwen 3.8 27B 推理實測(虞大膽,知乎,2026-09-29)
- NVIDIA DGX Spark 深度評測:個人超算的新標準(黃黃黃先森,知乎,2025-10-16)
- 3 萬塊的 AI 超級電腦,每秒只能蹦 6.7 個 token(大兵,知乎,2026-08-29)
- Apple M3 Ultra(512GB 統一內存)本地 LLM 推理全面分析(太平洋的水,知乎,2025-07-17)
- 2026 年本地 AI 模型最佳硬體完全選購指南(曾小健,知乎,2026-07-17)
- DGX Spark、Mac Studio 與 Gorgon Halo 的 AI 硬體江湖(Chun,知乎,2026-08-05)
- 別買錯了,Mac 的統一內存≠顯存!(DocTransPro,知乎,2026-08-28)
- Reddit r/LocalLLM 討論串 1w93ap4(M5 Ultra Mac Studio vs 2x DGX Spark benchmark)、1w1tbvy(Mac Studio M5 vs DGX Spark)
- Dendro Logic:NVIDIA DGX Spark Concurrency Benchmark
關於作者
黃俊凱 Gask Hung|蓋斯克科技創辦人,曾任 D-Link 網路研發工程師、QNAP 雲端儲存應用工程師/專案經理,近期投入地端 LLM 導入評估。完整作者介紹
延伸閱讀:地端 LLM 主機大車拼|DGX Spark 1x vs 2x 效能對決|Mac Studio M5 跑地端 LLM 實測整理|LLM 主機規格怎麼抓|設備租賃服務