作者:Gask Hung|發布:2026-09-14|最後更新:2026-09-14
在〈地端 LLM 主機大車拼〉裡,Mac Studio M5 Max 那一格我們寫的是「社群實測樣本不足,暫不列出」。新款 Mac Studio 在 2026 年 8 月 25 日發表、9 月 22 日出貨,一個月內社群已經累積一批可以對照的實測。整理下來,Mac 跑本地大模型的表現可以拆成三件事:逐字輸出的速度跟著記憶體頻寬走,M5 Max 是 614 GB/s、M5 Ultra 是 1.2 TB/s;讀入長輸入的速度靠每個 GPU 核心內建的 Neural Accelerator 大幅提升,但要軟體支援;跑 Agent 與多人共用,則是 Mac 目前最明顯的短板。Mac Studio M5 適合一個人把大模型完整跑起來;要跑 Agent,先確認 prefill 與快取設定做對;要給多人共用,還是回到獨立顯卡的架構。
📋 本文重點摘要
- 官方規格:M5 Max 最高 128GB、614 GB/s;M5 Ultra 最高 512GB、1.2 TB/s。台灣售價分別為 NT$84,900 與 NT$199,900 起
- decode 跟著頻寬走:同一個 27B 8bit 模型,M5 Max 約 17.8 tokens/s,頻寬較高的 M3 Ultra 約 22.8 tokens/s(社群實測)
- prefill 才是 M5 的真正升級:同一台 M5 Max 開啟加速路徑後,gpt-oss-120b 的 prefill 從 877 提升到 1,833 tokens/s(社群實測)
- 跑 Agent 每輪都要重讀大量輸入,快取沒命中會嚴重拖慢;多人同時使用時,Mac 的吞吐明顯落後獨立顯卡
👤 適合閱讀對象
- 已經在用 Mac 的工程主管:想知道升級 M5 Max 128GB 或等 M5 Ultra,能不能拿來跑團隊內部的程式 Agent
- IT/MIS:老闆看到「512GB 統一記憶體」,想買一台當全公司的 AI 主機,自己不確定該怎麼評估
- 獨立開發者或研究人員:資料不能上雲,需要一台安靜、低功耗、能跑 100B 以上模型的桌機
想知道 Mac Studio 夠不夠你的團隊用?加 LINE 傳使用人數、常用模型和平常的上下文長度,我們先幫你判斷該看 Mac 還是獨立顯卡 → 加 LINE 諮詢
一、Mac Studio M5 Max 與 M5 Ultra 規格:先看頻寬,再看容量
M5 Max 最高 128GB、614 GB/s;M5 Ultra 最高 512GB、1.2 TB/s,Ultra 的記憶體頻寬約是 Max 的兩倍,容量上限是四倍。
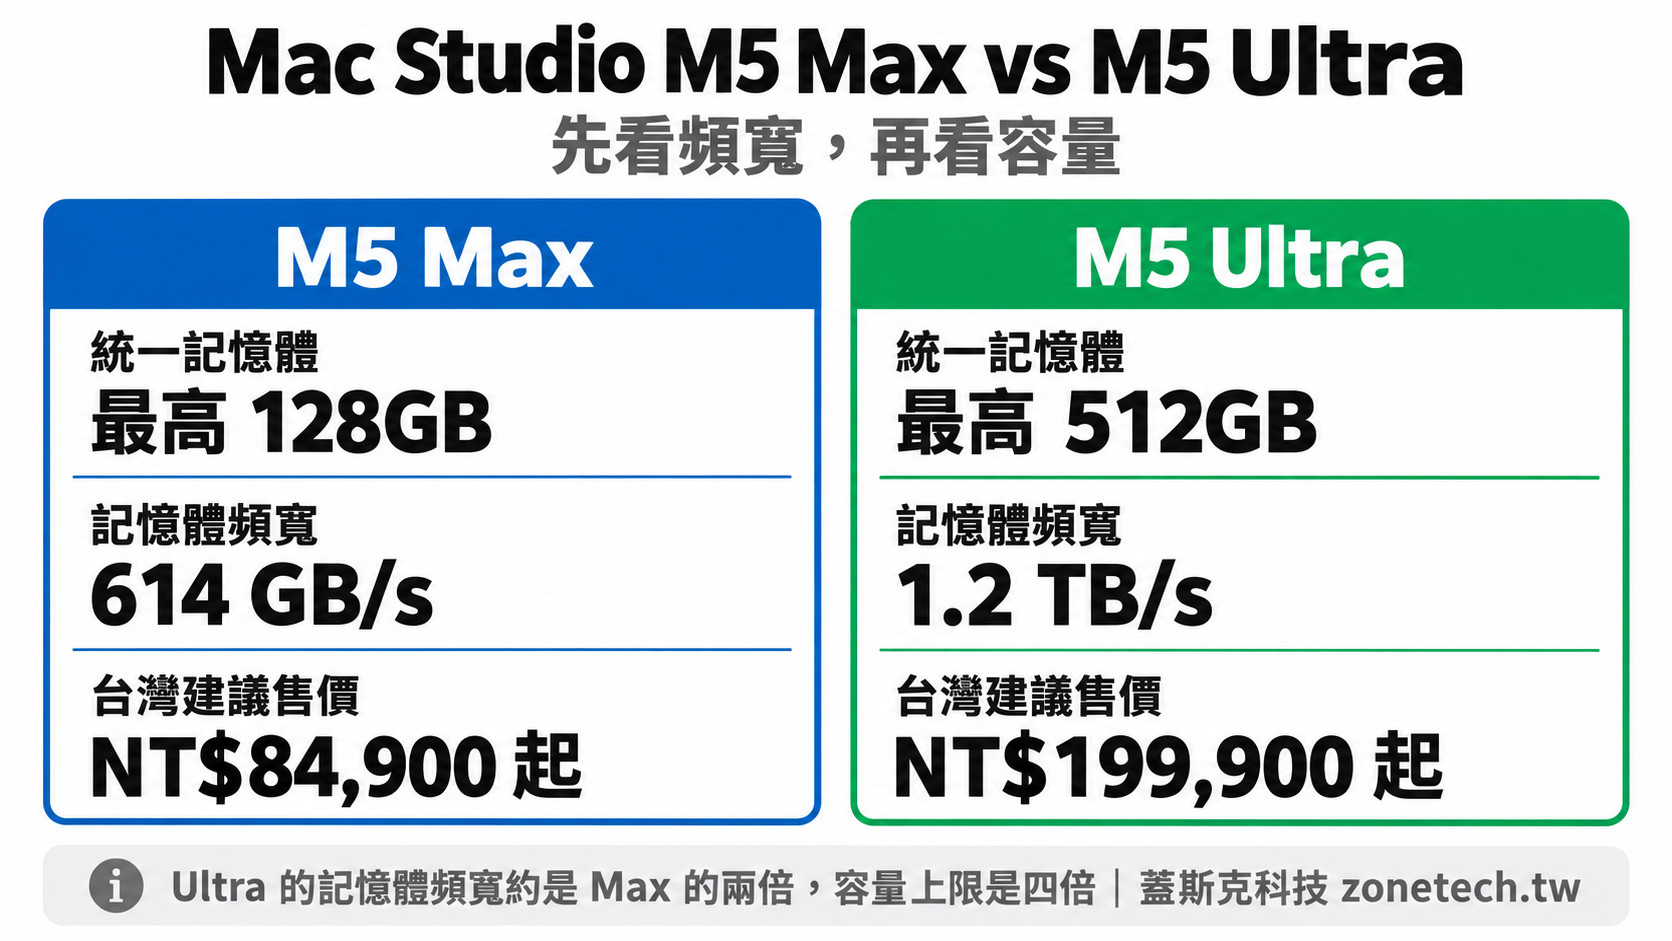
統一記憶體是 CPU 與 GPU 共用的同一池記憶體,模型權重不必在系統記憶體與顯示卡記憶體之間搬移。Mac 跑大模型的優勢來自這個架構:一台 128GB 的 Mac 可以直接載入 32GB 顯示卡塞不下的模型。載入之後跑多快,則由記憶體頻寬決定。
| 機種 | CPU/GPU | 最高統一記憶體 | 記憶體頻寬 | 台灣建議售價 | 適用情境 |
|---|---|---|---|---|---|
| Mac Studio M5 Max | 18 核心 CPU、最高 40 核心 GPU | 128GB | 614 GB/s | NT$84,900 起(128GB 選配價 [需確認 Apple 官網]) | 單人開發、30B 級模型、已在 Apple 生態系 |
| Mac Studio M5 Ultra | 最高 36 核心 CPU、最高 80 核心 GPU(起價機型為 30 核心 CPU、64 核心 GPU、96GB) | 512GB(512GB 版本 10 月底出貨) | 1.2 TB/s | NT$199,900 起 | 單人跑 100B 以上的 MoE 模型 |
| 對照:DGX Spark | GB10 超級晶片 | 128GB | 273 GB/s | 見母文 | CUDA 生態、原生 FP4 運算 |
| 對照:RTX 5090 自組 | 獨立顯卡 | 32GB 顯存 | 1,792 GB/s | 見母文 | 模型規模已確定、要衝速度 |
資料來源:Apple Newsroom,2026-08-25;台灣售價依 T客邦與蘋果仁報導;DGX Spark 與 RTX 5090 規格見〈地端 LLM 主機大車拼〉
Apple 在新聞稿裡對 M5 Ultra 的 AI 效能是這樣描述的:
M5 Ultra 的峰值 AI 運算效能最高可達 M3 Ultra 的 4.3 倍。
Apple Newsroom,2026 年 8 月 25 日,註腳標示為 Apple 於 2026 年 7 月的內部測試(原文為英文,蓋斯克翻譯)
社群文章常引用成「4.5 倍」,官方新聞稿寫的是 4.3 倍。更重要的是「峰值 AI 運算」這幾個字:它描述的是 GPU 算力,對應的是大模型推論裡讀入輸入的階段,對逐字輸出的速度幫助有限。下一節用實測數字說明這個差別。
二、M5 Max 跑大模型實際多快?社群實測整理
逐字輸出的速度幾乎跟著記憶體頻寬等比例變化;量化位元數與投機解碼,才是同一台 Mac 上能拉開一倍差距的變數。
一個好懂的比喻:大模型推論像餐廳出菜。prefill 是備料,一次把整張訂單的材料切好,靠的是廚房人手,也就是 GPU 算力;decode 是出餐,一次只能端一道菜出去,快慢取決於廚房到外場的走廊有多寬,也就是記憶體頻寬。M5 的 Neural Accelerator 等於多請了幾位切菜師傅,備料明顯變快,走廊寬度卻沒有改變。
以下數字全部來自知乎社群公開實測,Apple 官方跑分與蓋斯克自有測試都不在其中。模型版本、量化格式、推理框架不同,數字就會不同,請當成量級參考:
| 平台 | 模型與設定 | decode(逐字輸出) | prefill(讀入輸入) | 來源 |
|---|---|---|---|---|
| M5 Max,40 核心 GPU | Qwen3.8-27B,MLX 8bit,未開投機解碼 | 約 17.8 tokens/s | 未提供 | 史蒂夫,2026-08-26 |
| M3 Ultra,60 核心 GPU(819 GB/s) | Qwen3.8-27B,oMLX 8bit,短上下文/32K | 約 22.8/20.3 tokens/s | 未提供 | 同上 |
| M5 Max 128GB | Qwen3.8-27B,Ollama 4bit | 約 25 tokens/s | 未提供 | 霖落小屋,2026-08-21 |
| M5 Max 128GB | DeepSeek V4 Flash 0731,q2/q4 量化 | 約 40 tokens/s | 300–700 tokens/s(依上下文長度) | Chaos,2026-09-03 |
| M5 Max 128GB | Qwen3.8-Flash-Next,IQ4_XS,200K 輸入,llama.cpp 調校後 | 約 50 tokens/s(調校前的 2.8 倍) | 較調校前提升 85% | 老杨,2026-08-28 |
前兩列放在一起看最有意思。M3 Ultra 的頻寬是 819 GB/s,M5 Max 是 614 GB/s,兩者比例約 1.33;同一個模型的輸出速度 22.8 對 17.8,比例約 1.28。新一代晶片跑輸舊一代,原因就是 decode 階段 GPU 大多在等資料從記憶體搬過來。照同一個比例推算,頻寬 1.2 TB/s 的 M5 Ultra 跑這個 27B 8bit 模型大約會落在 33–35 tokens/s,這是依頻寬比例的推估,實際數字要等社群實測。
看到很高的 tokens/s,先問三件事
量化是幾 bit、有沒有開 MTP 投機解碼、上下文多長。同一篇社群實測指出,Qwen3.8-27B 在 RTX 5090 上開不開 MTP,速度從 66 跳到 121 tokens/s;M5 Max 同一個模型從 4bit 未加速的 25 tokens/s,到最佳化 4bit 加 MTP 的 50–60 tokens/s,也是一倍的落差。沒有寫明這三件事的數字,無法拿來比較機器。
三、M5 真正的升級在 prefill:Neural Accelerator 幫了什麼
M5 每個 GPU 核心都內建 Neural Accelerator,讓讀入長輸入的 prefill 快兩倍以上;decode 幾乎不受影響,而且推理框架要支援新的加速路徑才吃得到。
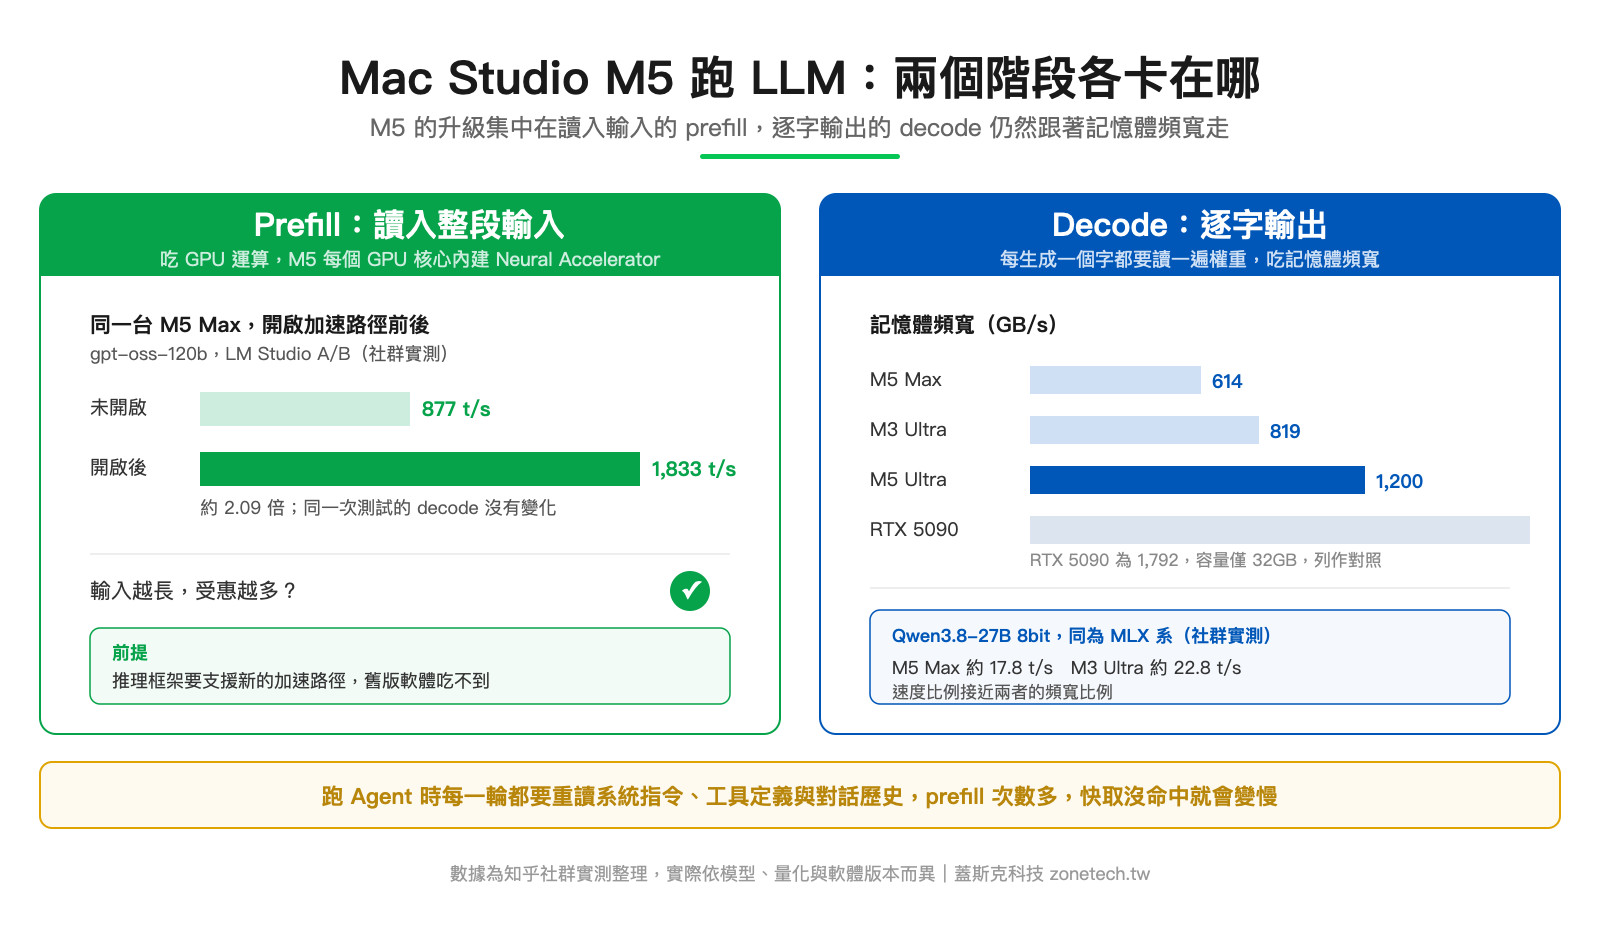
三組彼此獨立的數據都指向同一個結論:
- 學術論文:BaseRT 論文(arXiv 2607.19438,2026-07-21)在 M5 Pro 上測了 15 組模型配置,prefill 吞吐量最高比 llama.cpp 快 6.4 倍、比 MLX 快 3.9 倍,MoE 模型的提升最多;decode 最多只領先 llama.cpp 1.75 倍、MLX 1.33 倍。
- 同機開關對照:晏知微 2026-08-31 整理的 LM Studio 對照測試,在同一台 M5 Max 上切換加速路徑,gpt-oss-120b 的 prefill 從 877 提升到 1,833 tokens/s(2.09 倍),Step-3.7-Flash 從 342 提升到 833 tokens/s(2.44 倍),decode 完全沒變。
- 跨世代對照:郝天 2026-03-21 整理的社群數據中,M5 Max 跑 Qwen3-Coder-Next 8bit 的 prompt processing 峰值達 4,468 tokens/s,M4 Max 為 1,855、M3 Ultra 為 2,959。
推理框架的選擇也會跟著上下文長度改變。一份轉述自國外的 M4 Max 對照測試顯示,短上下文用 MLX 搭配投機解碼,輸出速度約快 1.7–1.86 倍;上下文拉到 100K 以上,llama.cpp 反而較快;200K 以上 MLX 的 prefill 與 decode 都下降明顯。日常對話與短任務用 MLX,長文件與大型程式碼庫用 llama.cpp,是目前社群比較一致的做法。
四、為什麼 Mac 聊天夠快,跑 Agent 卻慢?
Agent 每一輪都要重新讀入系統指令、工具定義與累積的對話歷史,prefill 的次數與長度遠多於聊天;快取沒有命中時,每一輪都在重算同一段內容。
一般聊天的輸入短、輸出長,體感幾乎全由 decode 決定,Mac 在聊天情境表現不錯。程式 Agent 的輸入動輒數萬 token,包含整份專案規則、工具說明、讀進來的程式碼與錯誤訊息,模型每做一步都要重讀一次。社群一篇文章的標題直接點出這個落差:「聊天真香、Agent 卻沒那麼爽」。
同一篇 M5 Ultra 實測整理引用的一組 Agent 編碼對照很值得參考:本地最佳組合雖然任務全數通過,完成時間是 975 秒,託管的前沿模型只要 203 秒,慢了約 4.8 倍。文中也記錄到一個常見狀況:KV 快取完全沒有命中,每一輪都在 40K 上下文下全量重新 prefill。這種狀況發生時,換更貴的機器改善有限,要先修設定。
李小肥的YY 2026-09-11 整理了一組把兩個階段拆開的測試,用 Llama-3.1 8B、輸入 8,192 token、輸出 32 token:DGX Spark 單機 prefill 1.47 秒、生成 2.87 秒;M3 Ultra Mac Studio 單機 prefill 5.57 秒、生成 0.85 秒;讓 Spark 負責 prefill、Mac 負責生成,總時間降到 2.32 秒,比 Mac 單機快 2.8 倍。這種分離式架構仍屬實驗性質,但它清楚說明了 Mac 的長處在後半段。M5 世代的 prefill 已大幅改善,這個差距會縮小。
在 Mac 上跑 Agent,下面幾個設定比升級機器更優先:
| 設定項目 | 為什麼重要 | 做法與代價 | 適用情境 |
|---|---|---|---|
| 確認前綴快取有命中 | 系統指令與工具定義每輪相同,命中快取就不必重算 | 觀察框架日誌的快取命中率;避免在提示詞開頭放時間戳這類每次都變的內容 | 所有 Agent 任務 |
| 不要用 parallel 參數把上下文切碎 | 社群實測中,llama.cpp 設 --parallel 4 會讓 131K 上下文被平分成每個 slot 只剩 32K | 單人使用時設為 1,確保 Agent 拿到完整上下文 | 需要 128K 以上上下文的 Agent |
| KV 快取量化 | 長上下文時 KV 快取會吃掉大量記憶體 | 社群在一台 64GB 舊款 Mac 上實測,q8 省約 4.7GB、速度降約 30%;q4 省更多、速度降約 41% | 記憶體不足時才用 |
| 投機解碼 | 讓小草稿頭先猜多個 token,主模型一次驗證 | 支援 MTP 的模型開啟後,輸出速度常見提升一倍左右,會多吃一些記憶體 | 單人、低並發 |
| 散熱與效能模式 | 長時間高負載會降頻,數字看起來像「上下文一長就斷崖」 | 保持通風,選用框架的高效能模式,長任務前先確認溫度 | 連續數小時的 Agent 任務 |
資料來源:老杨,2026-08-28;邵奈一,2026-08-19
五、M5 Ultra 256GB、512GB 能跑多大的模型?
256GB 能單機裝下 DeepSeek-V4-Flash 的 4-bit 等級量化版,512GB 才碰得到 200B 以上更大模型;容量加大讓模型塞得進去,輸出速度還是看頻寬。
| 統一記憶體 | 社群實測或推估能跑的模型 | 要注意 |
|---|---|---|
| 64GB | 27B 級模型 4–8bit;社群常見說法是跑本地程式 Agent 的起點 | 長上下文 Agent 會很快吃滿記憶體 |
| 128GB(M5 Max 上限) | DeepSeek V4 Flash 0731 的 q2/q4 量化、Qwen3.8-Flash-Next IQ4_XS(約 87GB) | 超低位元量化會影響品質;96GB 與 128GB 被部分社群認為是尷尬尺寸 |
| 256GB | DeepSeek-V4-Flash MXFP4 完整版(約 156GB),社群實測 200K 上下文峰值約 172GB | M5 Ultra 256GB 的 DeepSeek V4 Flash 速度目前是推估值 |
| 512GB(10 月底出貨) | 社群整理指出騰訊 Hy4-preview 最小量化約 213GB,需要 512GB 機型 | 容量翻倍,decode 速度不會跟著翻倍 |
資料來源:晏知微,2026-08-31;Chaos,2026-09-03;HiroshiYa,2026-08-27
擁有 M5 Max 128GB 的社群用戶 Chaos 對 M5 Ultra 256GB 做了推估:跑完整的 MXFP4 版 DeepSeek V4 Flash,prefill 約 600–1,200 tokens/s、decode 約 80 tokens/s。他也列了同價位的對手:兩台 DGX Spark 價格相近,載入速度可到約 1,700 但輸出約 40;兩張 RTX PRO 6000 載入 3,000–4,000、輸出 60–70,價格約高一倍。這組比較把三條路線的取捨講得很清楚。
用多台 Mac 串接擴充容量也有人做過。社群轉述的一個例子是四台 Mac Studio 以 Thunderbolt 5 串成約 1.5TB 記憶體跑 671B 模型,單機約 21.1 tokens/s,四台串起來約 31 tokens/s。容量可以疊加,速度卻只提升不到一半。另外 HiroshiYa 指出,M5 仍不支援 FP4、FP8 原生運算,這是 Mac 與 DGX Spark 這類平台的差異之一。
六、Mac Studio 可以當團隊共用的 AI 主機嗎?
Mac 的強項是單一使用者;多個請求同時進來時,吞吐與延遲都比獨立顯卡搭配 vLLM 的服務架構弱,社群的看法相當一致。
在知乎「M5 Ultra Mac Studio 值不值得買」的問題底下,反對者最常提的理由就是並發。一則回答形容得很直接:一個人用速度尚可,兩個人就降速,人更多就撐不住。另一位已經買了 M3 Ultra 512GB 的用戶也說,跑 DeepSeek V4 Flash 很愉快,但別指望並發,要並發還是買 RTX PRO 6000 跑 27B 模型。
原因跟推理框架有關。Mac 上主流的 MLX 與 llama.cpp 以單機、單使用者為主要設計目標,多用戶服務需要的連續批次處理、分頁式 KV 快取管理,在 NVIDIA 平台上的 vLLM、SGLang 更成熟。這個分界線跟〈Ollama 可以上企業生產環境嗎〉講的是同一件事:個人工具與服務化框架的設計目標不同。
團隊要共用,單張專業顯卡能撐幾個人、容量怎麼估,整理在同系列的〈一張 RTX PRO 6000 撐得起幾個人?〉。
七、該選 M5 Max、M5 Ultra,還是別買 Mac?
先確認使用人數與主要任務:單人、短任務選 Mac 很合理;多人共用或以長上下文 Agent 為主,Mac 通常排不上第一順位。
| 你的情境 | 建議方向 | 理由 |
|---|---|---|
| 單人、已在 Apple 生態系、主要跑 30B 以下模型 | M5 Max 64GB–128GB | 安靜、低功耗、日常泛用;27B 級模型搭配投機解碼有實用速度 |
| 單人、需要本機跑 100B 以上 MoE 或 DeepSeek V4 Flash | M5 Ultra 256GB | 容量足夠單機載入,頻寬是 M5 Max 的兩倍 |
| 以長上下文程式 Agent 為主 | 先驗證 prefill 與快取設定,再比較 prefill 更強的平台 | Agent 的瓶頸在 prefill 次數,單看 decode 速度會誤判 |
| 5 人以上共用、需要穩定吞吐 | 不建議以 Mac 為主力,改看獨立顯卡加 vLLM | 社群實測與經驗都顯示 Mac 並發表現弱 |
| 還不確定要買哪一台 | 先租賃試用,用實際工作量決定 | 硬體與記憶體價格仍在波動,二手折價也快 |
不確定要不要一次買斷,可以參考蓋斯克的設備租賃方案,先用實際工作量試一段時間。地端與雲端 API 兩條路線整體划不划算,〈地端 LLM 建置完整指南〉有完整的成本比較;模型需要多少記憶體,可以用〈LLM 主機規格怎麼抓〉的對照表先估算。
八、蓋斯克怎麼評估
蓋斯克科技目前沒有 Mac Studio M5 的自有實測,本篇所有速度數字都來自上方註明的社群公開資料。[需提供蓋斯克 Mac Studio 實測數據或客戶導入案例:機種與記憶體、模型與量化、使用人數、實測 decode/prefill,以及導入前後的變化。若暫無,發佈時可刪除本節。]
結論:Mac 讓大模型跑得起來,團隊用得順要另外規劃
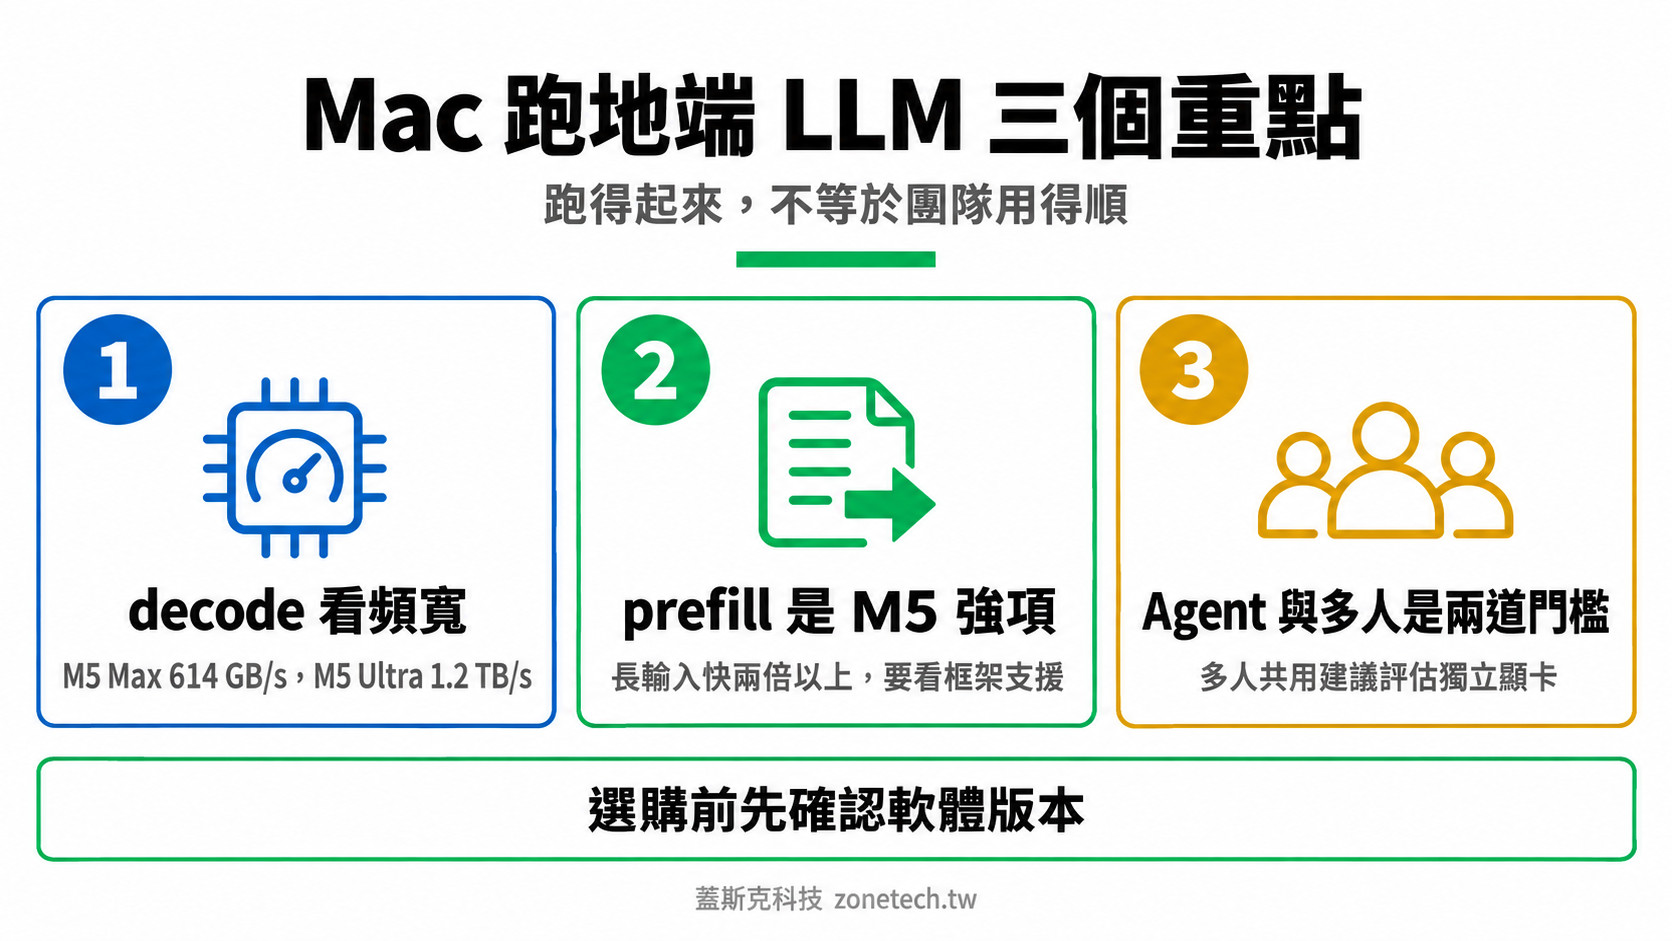
- decode 看頻寬:M5 Max 614 GB/s、M5 Ultra 1.2 TB/s,同一個模型的輸出速度大致照這個比例走,新晶片名稱不代表輸出一定更快。
- prefill 是 M5 的強項:Neural Accelerator 讓讀入長輸入快兩倍以上,前提是推理框架有支援,選購前先確認你要用的軟體版本。
- Agent 與多人是兩道門檻:Agent 要先把快取與上下文設定做對;多人共用則建議直接評估獨立顯卡的服務架構。
立即開始:你的地端 LLM 主機值得一次選對
蓋斯克科技協助台灣中小企業評估地端 AI 基礎建設,從單機開發環境到多人共用的生產架構,依實際使用情境給建議,不先推銷特定機種。
我們提供:
- 依你的使用人數、常用模型與上下文長度,判斷 Mac 還是獨立顯卡較合適
- 2026 年市場報價區間與硬體規格對照,避免用過時資訊做決策
- 透明報價,無隱藏費用
- 設備租賃與採購兩種路線並陳,先試用再決定
想先用實際工作量試試 Mac 或其他地端 LLM 主機?
蓋斯克科技提供AI 導入評估服務,先確認需求規模,再決定要不要投資硬體。
AI導入評估 免費預約諮詢電話:02-2717-1019 LINE:@zonetech
關於作者
Gask Hung|蓋斯克科技創辦人,專注台灣中小企業 IT:企業 Wi-Fi、4K 剪輯系統、IT 委外與設備租賃,近期投入地端 LLM 導入評估。完整作者介紹
延伸閱讀:地端 LLM 主機大車拼|一張 RTX PRO 6000 撐得起幾個人?|設備租賃服務