作者:黃俊凱 Gask Hung|發布:2026-09-15|最後更新:2026-09-15
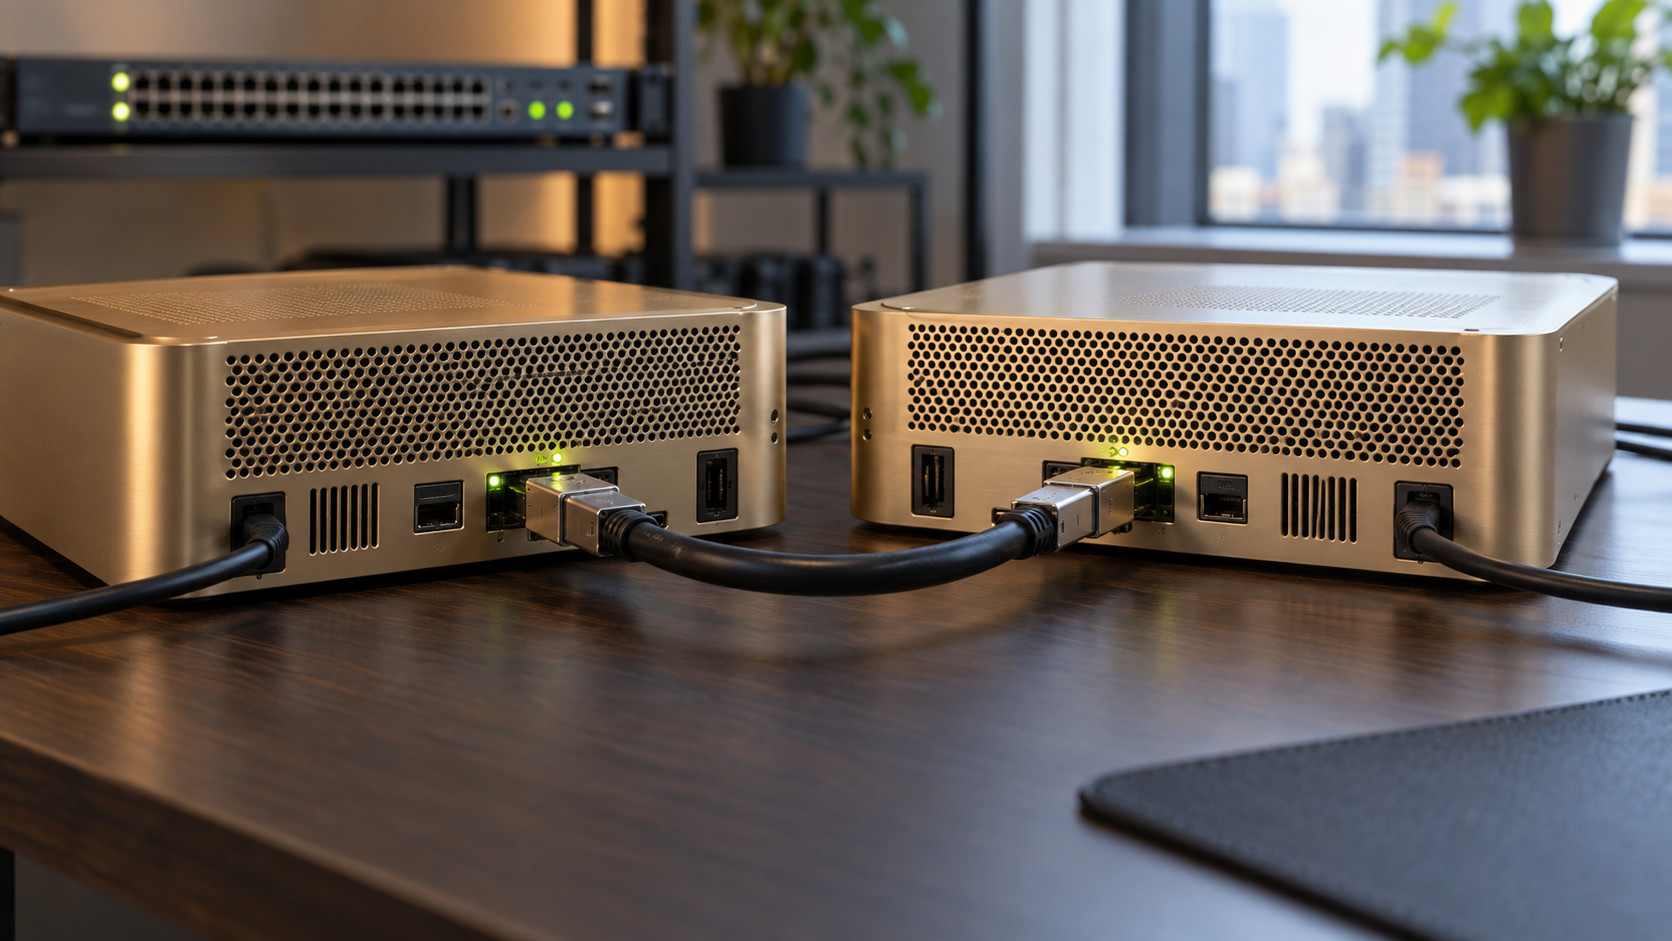
兩台 DGX Spark 只要一條 QSFP 線直連,就能跑出接近 200 Gb/s 的頻寬,真正決定速度的是 IP 設定。DGX Spark 背面的兩個 QSFP 埠由 ConnectX-7 網卡提供,每個埠在 Linux 裡會拆成兩個網路介面,兩個介面都要設 IP、而且放在不同網段,流量才會同時走兩條 PCIe 路徑。麗臺科技實測兩台直連的 RDMA 總頻寬約 196 Gb/s。三台可以接成環狀,四台以上建議接 200G 交換器。
📋 本文重點摘要
- 兩個實體 QSFP 埠會看到四個介面,這是 Socket Direct 架構的正常現象。
- 一條線就能接近 200G;接兩條線總頻寬不會翻倍,只是四個介面都要設 IP。
- 同一條線上的兩個介面必須分屬不同網段,放同一網段會讓流量卡在單一路徑。
- 實測數字:單一路徑約 92 到 109 Gb/s,兩路合計約 185 到 196 Gb/s,經交換器 195.7 Gb/s。
- 接交換器三大卡點:自動協商失敗、巨型封包被丟、叢集流量沒跟管理網路隔離。
👤 適合閱讀對象
- 剛買第二台 DGX Spark 的 AI 工程師:線接上了,
ibdev2netdev卻跑出四個介面,不確定 IP 要設在哪裡。 - 規劃 4 台以上叢集的技術主管:要決定用直連還是買交換器,想知道交換器會不會拖慢速度。
- 負責公司 AI 主機的 IT 人員:擔心 200G 叢集網路跟辦公室網路混在一起,想先搞清楚要怎麼隔離。
DGX Spark 已經到貨、網路卻接不起來?加 LINE 傳 ibdev2netdev 的輸出截圖與你們的台數,我們先幫你看設定卡在哪 → 加 LINE 諮詢
一、DGX Spark 的 ConnectX-7 是什麼?為什麼兩個埠會看到四個網路介面
ConnectX-7 是 DGX Spark 內建的高速網卡,負責機器之間的 200G 互連;兩個 QSFP 埠會變成四個介面,是因為網卡用兩條 PCIe 路徑接到主晶片。依 NVIDIA 官方使用手冊,這張網卡透過兩條獨立的 PCIe Gen5 x4 連到 GB10 晶片,每個 QSFP 埠因此有兩個 PCIe 位址,Linux 會替每個位址各建一個乙太網路介面與一個 RoCE 裝置。
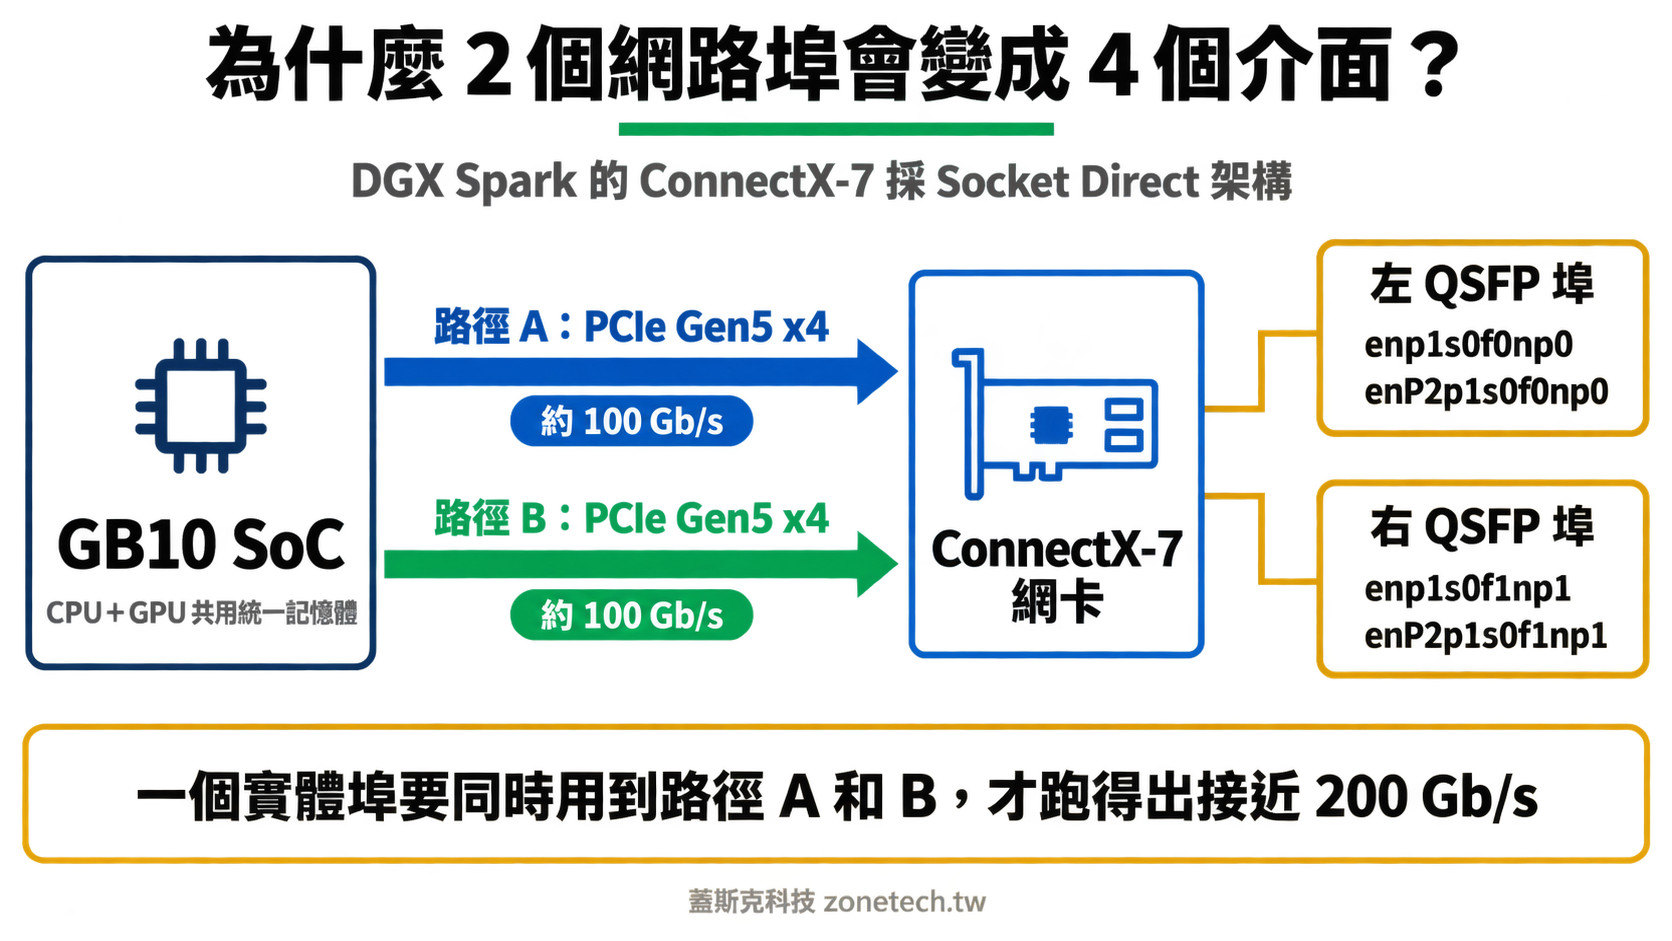
一個好懂的比喻:QSFP 埠像一座收費站的出口,外面是一條 200 車道的高速公路,但收費站後面只接了兩條各 100 車道的匝道。只開一條匝道,高速公路再寬也只跑得出一半的車流;兩條匝道同時開,才能把整條路塞滿。
麗臺科技的文章把這兩條匝道稱為路徑 A 與路徑 B。GB10 無法給單一裝置超過 x4 寬度的 PCIe 通道,每條 x4 只撐得起約 100 Gb/s,所以網卡啟用 Socket Direct 模式,把兩條 x4 聚合起來達到 200 Gb/s。下表是 NVIDIA 手冊列出的完整對照,所有 DGX Spark 的介面名稱都一樣:
| QSFP 埠 | PCIe 路徑 | 乙太網路介面 | RoCE 裝置 |
|---|---|---|---|
| 左埠(靠近 RJ-45 網路孔) | 路徑 A | enp1s0f0np0 | rocep1s0f0 |
| 左埠(靠近 RJ-45 網路孔) | 路徑 B | enP2p1s0f0np0 | roceP2p1s0f0 |
| 右埠 | 路徑 A | enp1s0f1np1 | rocep1s0f1 |
| 右埠 | 路徑 B | enP2p1s0f1np1 | roceP2p1s0f1 |
名稱裡有大寫 P2 的是路徑 B,結尾 np0 是左埠、np1 是右埠。X 使用者 @takuz0_ 在 2026 年 8 月的貼文補充了背後原因:RoCE v2 的 RDMA 位址是由 IP 產生的,路徑 A 和 B 是兩個獨立的 PCIe 功能,各有自己的位址表,只替 A 設 IP,B 就不會有 RDMA 位址,所有流量只能擠在 A。他實測這種情況卡在約 110 Gb/s。
二、兩台、三台、四台以上怎麼接?直連、環狀與交換器
兩台用一條線直連,三台接成環狀,四台以上接 200G 交換器。每台只有兩個 QSFP 埠,四台要全部互連需要每台三個埠,所以四台以上用直連就接不起來了。NVIDIA 目前針對這三種接法各有一份官方設定教學,官方的 NVIDIA Sync 叢集助手則支援直連最多三台、經交換器最多四台。
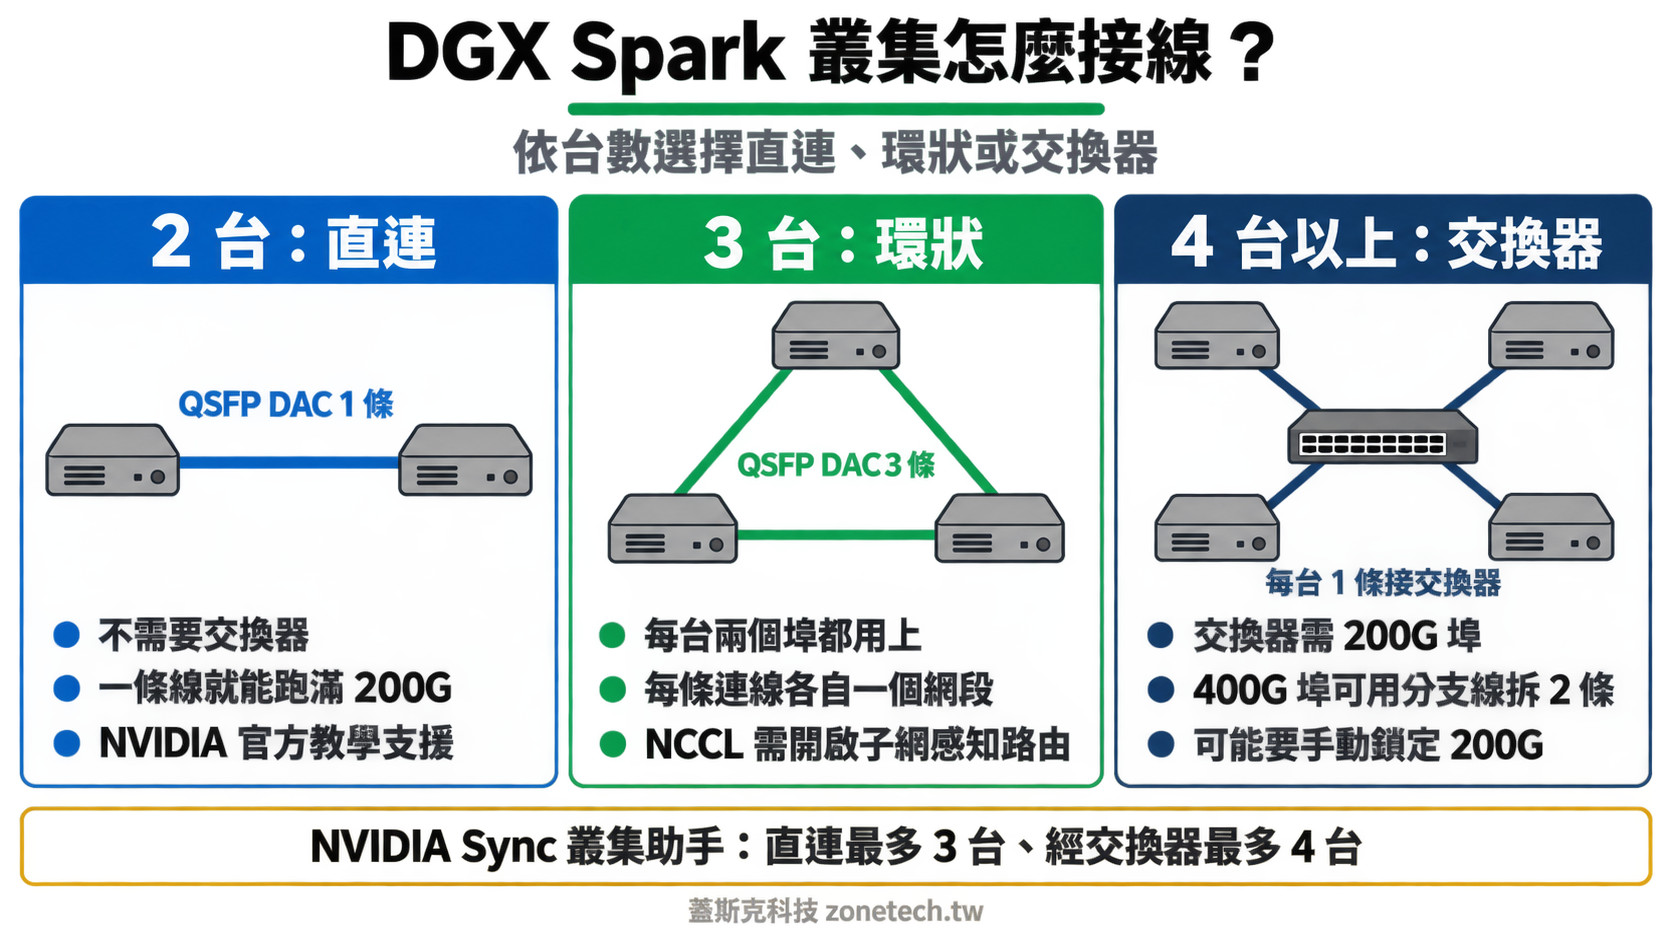
| 台數 | 接法 | 需要的線材與設備 | 設定重點 | 適用情境 |
|---|---|---|---|---|
| 2 台 | 直連 | QSFP 線 1 條 | 兩台接同一個實體埠,兩個介面設不同網段 | 跑 256GB 記憶體裝得下的模型 |
| 3 台 | 環狀 | QSFP 線 3 條 | 每台四個介面都要設 IP;NCCL 開啟 NCCL_IB_SUBNET_AWARE_ROUTING=1 | 不想買交換器、又需要超過兩台的記憶體 |
| 4 台以上 | 交換器 | 200G 交換器+每台 1 條線 | 交換器埠鎖定 200G、所有埠放同一個 L2 網域 | 要跑 TP=4 以上或經常切換配置 |
線材怎麼選
NVIDIA 手冊要求使用至少 200 Gb/s 的 QSFP 線,更高規格的線沒有好處,因為埠本身上限就是 200 Gb/s。官方認可的線材有 Amphenol NJAAKK-N911(QSFP 轉 QSFP112,40 公分)、同系列 50 公分的 NJAAKK0006,以及 Luxshare LMTQF022-SD-R(QSFP112 400G DAC,40 公分)。插線時把拉環朝上、輕推到底,推不進去不要硬塞,方向或角度不對硬塞會損壞連接埠。
兩台之間多接一條線不會變成 400G。NVIDIA 兩台直連教學寫明「一條 QSFP 線就能達到完整頻寬」,接兩條線時四個介面都要設 IP 才能拿到完整頻寬。Reddit 一篇雙機與 Mac Studio 比較文的熱門留言也直接點出「兩台之間只需要一條線」。接交換器時更要注意,16 台叢集的建置者 Kurcide 在留言中提醒,每台接兩條線進交換器反而會拖累整個網路。
三、兩台直連怎麼設定?IP 規劃與 netplan 步驟
兩台直連的設定只有四步:統一使用者名稱、接線確認介面狀態、用 netplan 設定兩個網段的 IP、設定免密碼 SSH。以下步驟與 IP 範例取自 NVIDIA 官方 Connect Two Sparks 教學(最後更新 2026-07-21),官方預估含驗證約需一小時。
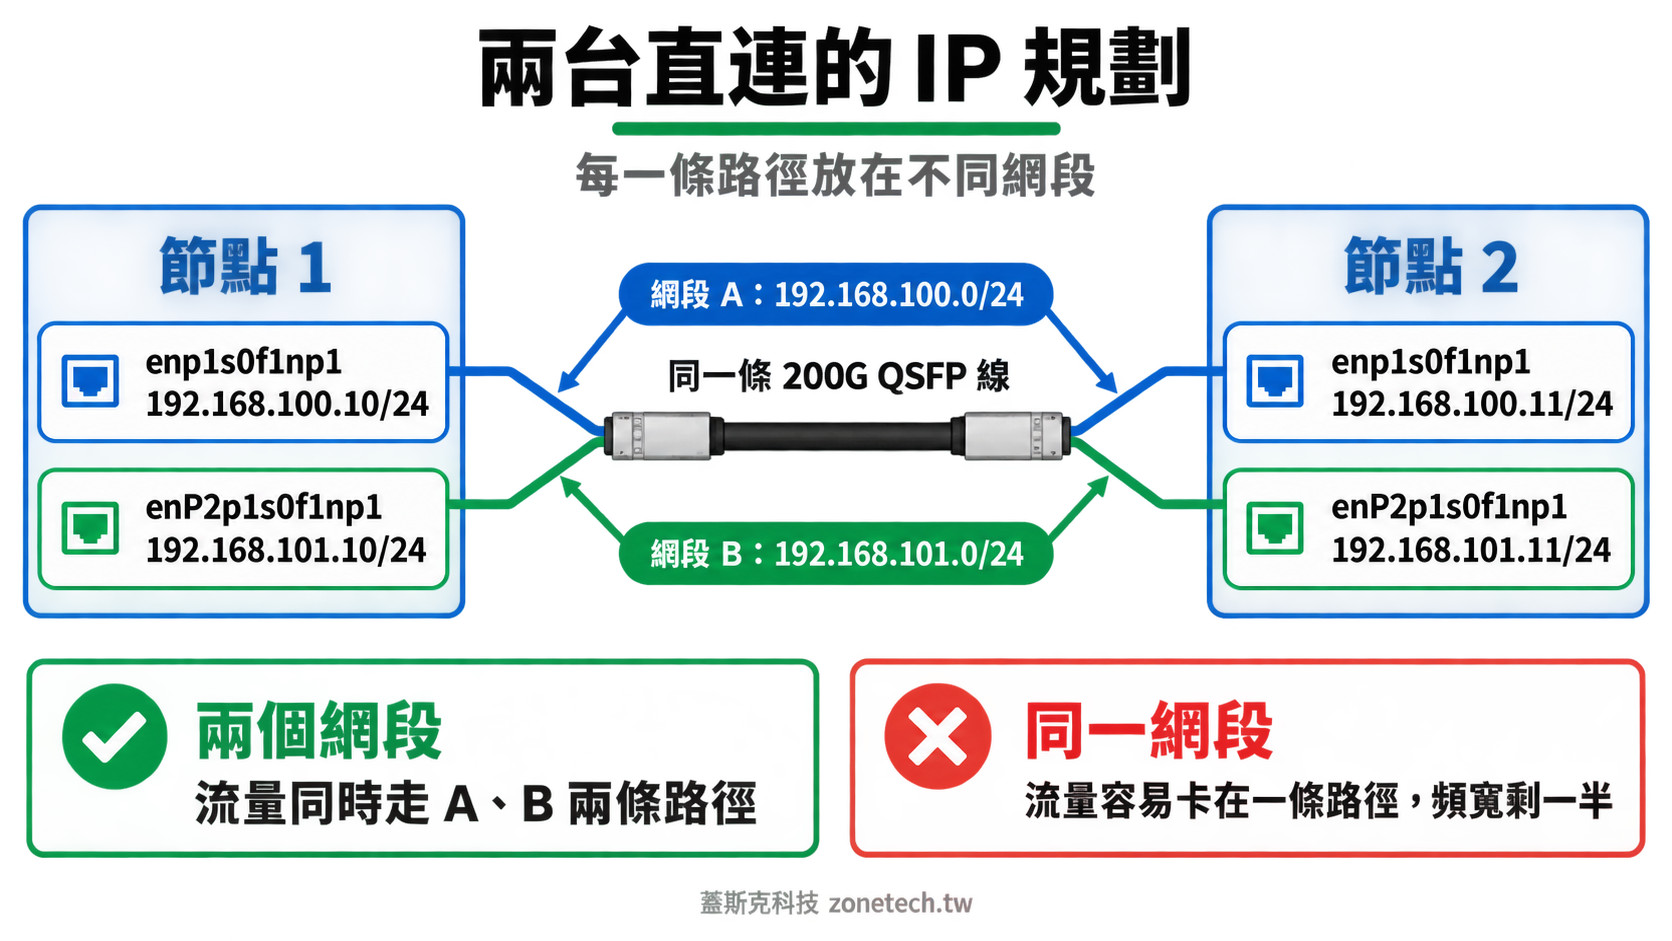
步驟 1:兩台使用相同的使用者名稱。兩台各執行 whoami,名稱不同就建立同名帳號,後續 SSH 與分散式工作才不會卡住。
步驟 2:接線並確認介面狀態。兩台要接在同一個實體埠,例如都用右埠,避免 NCCL 測試出錯。接好後執行 ibdev2netdev,顯示 (Up) 的就是要設定的介面。如果全部顯示 Down,官方建議先檢查線材、重新開機再試。
$ ibdev2netdev
roceP2p1s0f0 port 1 ==> enP2p1s0f0np0 (Down)
roceP2p1s0f1 port 1 ==> enP2p1s0f1np1 (Up)
rocep1s0f0 port 1 ==> enp1s0f0np0 (Down)
rocep1s0f1 port 1 ==> enp1s0f1np1 (Up)
步驟 3:用 netplan 設定 IP。兩個 Up 的介面分別放在 192.168.100.0/24 與 192.168.101.0/24。節點 1 的設定如下,節點 2 把結尾的 .10 改成 .11:
sudo tee /etc/netplan/40-cx7.yaml > /dev/null <<EOF
network:
  version: 2
  ethernets:
    enp1s0f1np1:
      addresses:
        - 192.168.100.10/24
      dhcp4: no
    enP2p1s0f1np1:
      addresses:
        - 192.168.101.10/24
      dhcp4: no
EOF

sudo chmod 600 /etc/netplan/40-cx7.yaml
sudo netplan apply
兩個介面一定要分屬不同網段。NVIDIA 交換器教學特別註明,把兩個介面放在同一個網段會造成路由混亂與 NCCL 通訊失敗。也可以用 ip addr add 直接指定 IP,但官方提醒這種做法重開機後設定就會消失,正式環境建議用 netplan。
步驟 4:設定免密碼 SSH 並驗證。官方提供 discover-sparks 腳本自動找到另一台並完成 SSH 設定;也可以手動用 ssh-copy-id 交換金鑰,再執行 ssh 192.168.100.11 hostname 確認連得到。要還原設定,兩台各刪除 /etc/netplan/40-cx7.yaml 後再執行一次 sudo netplan apply。
麗臺科技的測試做得更徹底:兩條 QSFP 線都接上,四個介面各自一個網段(192.168.10.0/24 到 192.168.13.0/24),方便分別量測每一條路徑。如果只是要跑推論,照官方一條線、兩個網段的設定就夠了。
照步驟設了,頻寬還是只有一半?
LINE 傳 ibdev2netdev、ip -br a 的輸出與測速結果,我們協助判斷是線材、網段還是 NCCL 設定的問題,不用先約不用先付錢。
四、DGX Spark 雙機實際跑得出多少頻寬?
三份獨立實測的結果一致:單一路徑約 92 到 109 Gb/s,兩條路徑合計約 185 到 196 Gb/s,已經接近 200G 的物理上限。麗臺科技用 perftest 套件的 ib_write_bw 分別量測每條路徑,再同時開啟多條,確認聚合頻寬。
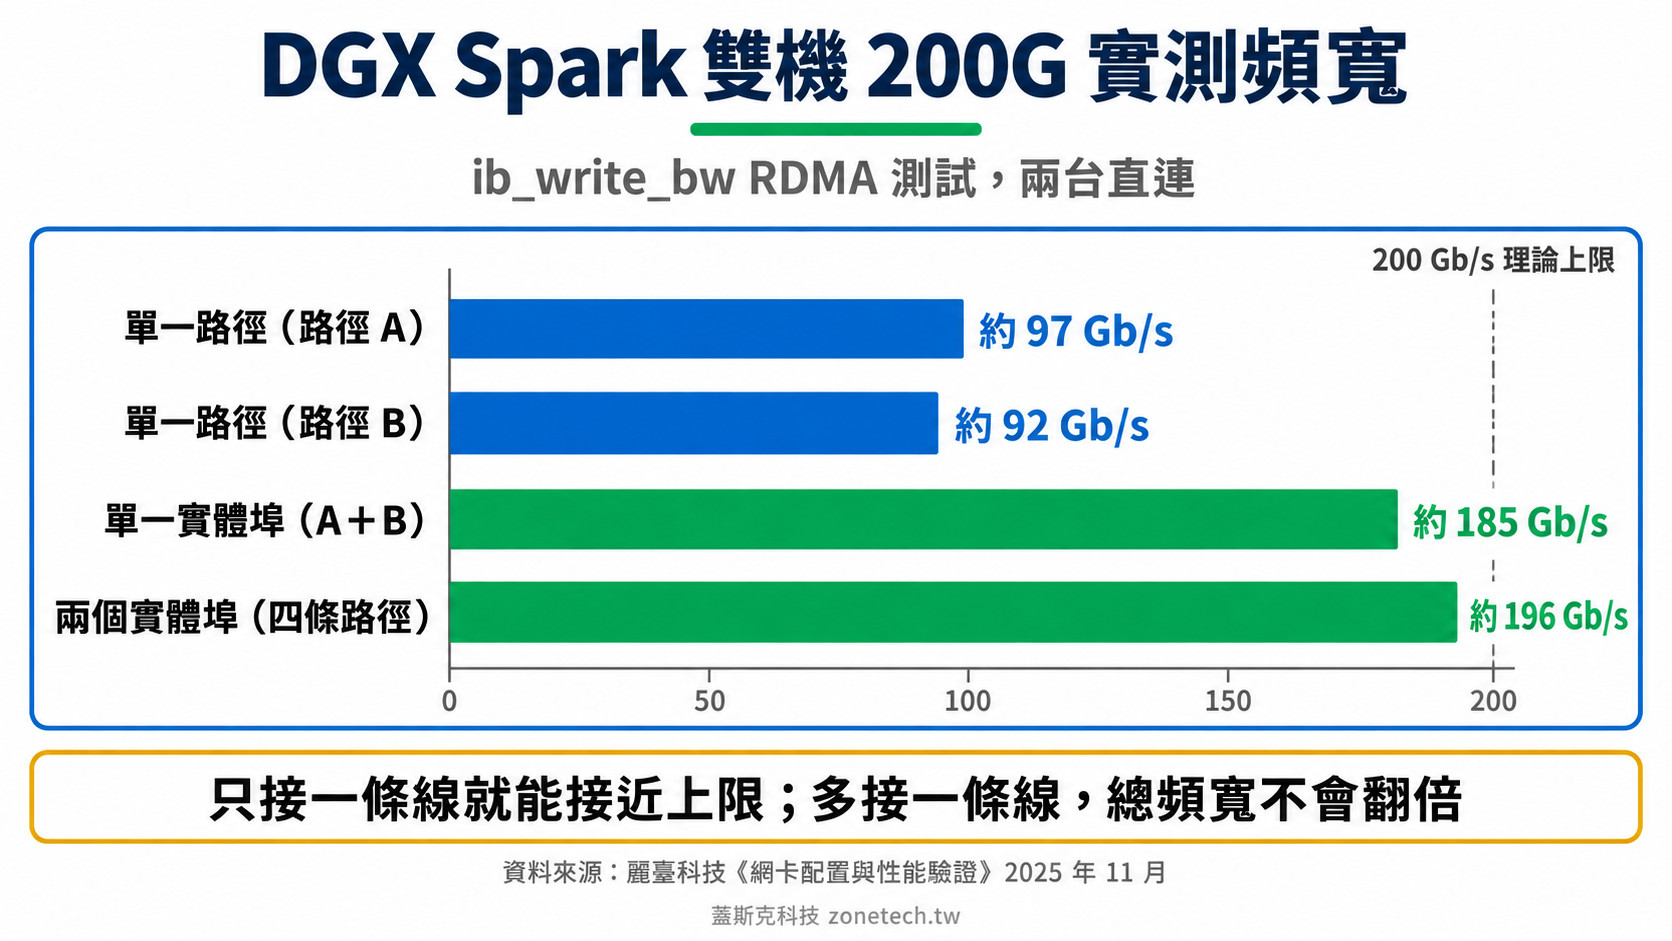
| 測試項目 | 麗臺科技(2025-11) | nacyot 建置紀錄(2026-08) | Reddit Kurcide 16 台叢集(2026-05) |
|---|---|---|---|
| 單一路徑 RDMA | 路徑 A 約 97、路徑 B 約 92 Gb/s | 108.3 Gb/s(直連)、109.2 Gb/s(經交換器) | 每條路徑 100 到 111 Gb/s |
| 兩條路徑合計 | 單一實體埠約 185 Gb/s | 196.0 Gb/s(直連)、195.7 Gb/s(經交換器) | 合計達到標稱的 200 Gb/s |
| 兩個實體埠四條路徑同時跑 | 總頻寬約 196 Gb/s | 未測 | 未測 |
| 測試工具 | ib_write_bw | ib_send_bw,65536 位元組訊息 | 未說明 |
麗臺的第二組測試很有參考價值:物理埠 1 的兩條路徑持續跑的同時,再開啟物理埠 2 的兩條路徑,四條路徑的頻寬被平均分攤,總量維持在約 196 Gb/s。這證明多接一條線,總頻寬不會增加,上限卡在網卡本身。
NCCL 通訊測試:注意 GB/s 與 Gb/s 的差別
跑分散式推論或訓練時,真正用到的是 NCCL。麗臺依官方文件編譯 NCCL v2.28.3-1 與 nccl-tests 後量測:只用單一路徑時,all_gather 平均匯流排頻寬 12.04 GB/s;同一個實體埠開兩條路徑,all_gather 提升到 22.68 GB/s;all_reduce 在 512MB 訊息量下達到 18.02 GB/s。
讀這組數字要特別注意單位。nccl-tests 回報的 GB/s 是「每秒 GB」,網路規格常寫的 Gb/s 是「每秒 Gb」,兩者差 8 倍。18.02 GB/s 換算約 144 Gb/s,並沒有超過 200G 的上限。社群討論常把兩種單位混在一起比較,看到數字差很多時,先確認單位再下結論。
另一個常被忽略的地方是 NCCL 會悄悄退回 TCP。雙機跑出每秒 181 token 的分享文(241 讚)特別提醒,要在 NCCL 日誌裡確認出現 Using network IB;RDMA 沒成功時 NCCL 會改走 TCP,而且不會報錯,速度大約只剩一半。開啟方式是執行時加上 NCCL_DEBUG=INFO。
五、四台以上接交換器要注意什麼?
設定正確的 200G 交換器幾乎不會拖慢速度,實測經交換器 195.7 Gb/s、直連 196.0 Gb/s;會出問題的是交換器端的預設值。NVIDIA 官方交換器教學要求交換器至少有 4 個 200Gbps 的 QSFP56-DD 埠,400G 埠可以用分支線拆成兩個 200G 埠,每台 DGX Spark 只接一條線,建議所有節點都接同一個實體埠。
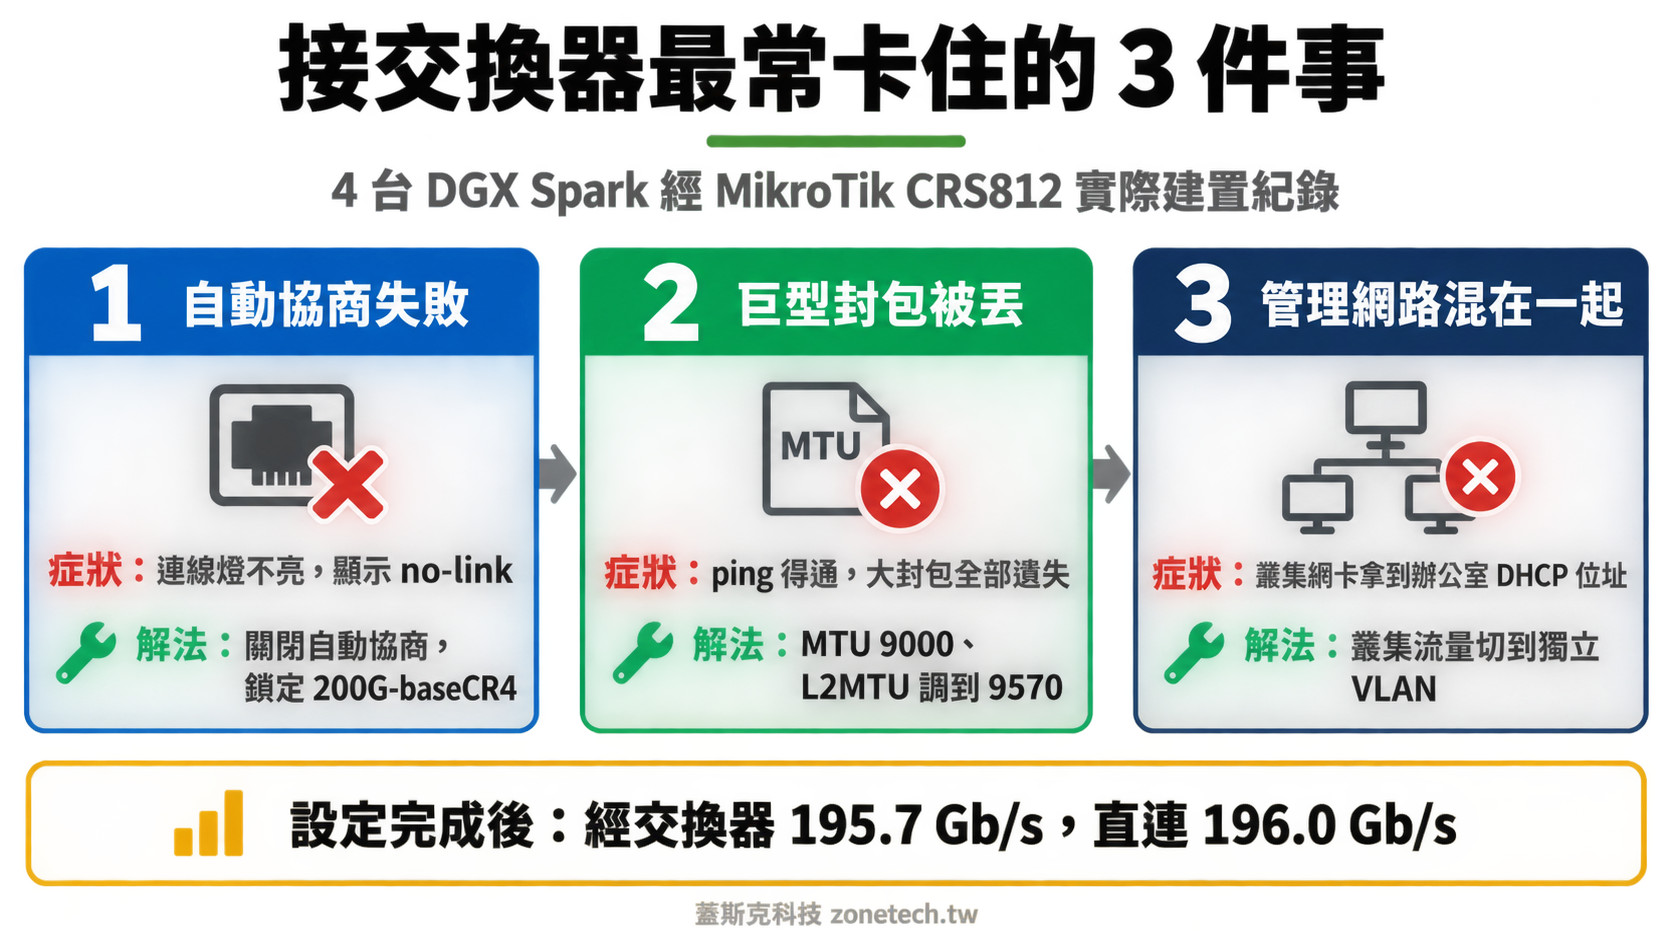
韓國工程師 nacyot 在 2026 年 8 月發布的四台交換器建置紀錄,把踩過的坑寫得很完整。他用 MikroTik CRS812-8DS-2DQ-2DDQ(文中記載定價 US$1,295),把兩個 400G 埠各用一條分支 DAC 拆成兩條 200G,兩條線就接滿四台。剛接好時四台全部顯示 no-link,之後依序解決三個問題:
- 自動協商失敗:這個組合的 PAM4 DAC 線協商不起來,在交換器端關閉自動協商、強制指定
200G-baseCR4後幾秒內就連上。NVIDIA 官方教學也提到同樣狀況,建議在每台執行ethtool確認速度顯示 200000Mb/s。 - 巨型封包被丟:連線後一般 ping 正常,但 RDMA 用的 8972 位元組封包全部遺失,原因是交換器埠預設 L2MTU 只有 1584,調成 MTU 9000、L2MTU 9570 後恢復。這種問題不會報錯,只會表現成「連線正常但頻寬怪怪的」。
- 叢集與管理網路沒隔離:RouterOS 出廠預設把所有埠放在同一個 bridge,結果叢集網卡拿到了家裡網路的 DHCP 位址。他把 200G 叢集流量切到獨立 VLAN、管理流量走另一個有標記的 VLAN。
第三點跟 NVIDIA 教學的建議方向一致:管理與上網流量走 DGX Spark 的 10GbE 網路孔或 Wi-Fi,跟 ConnectX-7 的叢集網路分開,避免 200G 頻寬被非運算流量佔用。nacyot 另外分享一個遠端改設定的保險做法:開啟 VLAN 過濾前先設一個三分鐘後自動關閉過濾的排程,設錯斷線會自動復原,確認連得上再刪掉排程。
社群實際用過的交換器
| 交換器 | 接法 | 規模 | 來源與重點 |
|---|---|---|---|
| MikroTik CRS812-8DS-2DQ-2DDQ | 2 個 400G 埠各拆 2 條 200G,另有 2 個 200G 埠 | 4 台,可再加 2 台 | nacyot 建置紀錄;X @TechMDAI 用同型號設定 PFC、ECN 與巨型封包,各節點間約 196 Gb/s |
| MikroTik CRS804-4DDQ | 4 個 400G 埠各拆 2 條 200G | 最多 8 台跑滿 200G | X @TheAhmadOsman(2026-02);Reddit 4 台 GLM-5.2 叢集也用這台,作者提醒線材品質很重要 |
| FS N8510(24 埠 200G QSFP56) | 每台 1 條 QSFP56 DAC | 16 台 | Reddit Kurcide 16 台叢集,自述交換器約 US$13,000、線材約 US$2,000 |
交換器不只是為了台數。nacyot 的分析指出,四台跑 TP=2 兩組或 TP=2 加 PP=2,理論上用直連線材也接得起來,但每換一種配置就要重新插線、重新規劃網段、重新驗證連線;有交換器之後,切換配置變成遠端改軟體設定就好。四台要跑 TP=4,每一層運算都需要四台互相通訊,這時就一定要交換器。
六、DGX Spark 叢集網路常見問題排除
頻寬只有一半、連線燈不亮、推論速度掉一半,是社群最常回報的三種狀況,多數跟網段、交換器設定或 NCCL 退回 TCP 有關。
| 症狀 | 常見原因 | 解決方向 | 蓋斯克怎麼做 |
|---|---|---|---|
ibdev2netdev 全部顯示 Down | 線材沒插到底或方向錯誤 | 拉環朝上重新插好,重新開機 | 現場確認線材型號與插接方向 |
| 頻寬卡在約 100 到 110 Gb/s | 只有一個介面有 IP,或兩個介面在同一網段 | 兩個介面各設不同網段的 IP | 協助規劃叢集 IP 與網段表 |
| 接交換器後 no-link | 自動協商失敗 | 交換器端關閉自動協商、鎖定 200G-baseCR4 | 協助設定交換器埠速度與 FEC |
| ping 得通但頻寬很低 | 交換器 MTU 太小,巨型封包被丟 | 交換器 MTU 9000、L2MTU 調高 | 協助設定 MTU 並做全節點巨型封包測試 |
| 多機推論速度只有預期一半 | NCCL 沒走 RDMA,悄悄退回 TCP | 用 NCCL_DEBUG=INFO 確認 Using network IB | 協助檢查 NCCL 環境變數與日誌 |
| 連線正常但頻寬只有十幾 Gb/s | nacyot 遇過的電源殘留狀態問題 | 完全斷電放電後重新開機 | 協助逐項排除硬體與設定因素 |
最後一列是 nacyot 在直連階段遇到的狀況:連線明明協商在 200G,實際只有 13 Gb/s,最後把機器完全斷電放電後才恢復。這類問題不在任何官方文件裡,遇到時值得先試。
七、官方文件與社群說法不一樣的地方
社群討論裡有幾個流傳很廣的說法跟 NVIDIA 官方文件不一致,照錯的說法設定會白花時間。下表整理蓋斯克比對時找到的四處差異。
| 項目 | 社群常見說法 | 官方文件或實測 | 蓋斯克的判讀 |
|---|---|---|---|
| 網卡能不能切 InfiniBand 模式 | Reddit 留言建議改用 InfiniBand 效能更好 | NVIDIA 手冊註明 QSFP 埠只支援乙太網路設定 | 以乙太網路加 RoCE 為準,不必嘗試切換 |
| 接兩條線會不會變 400G | 直覺認為兩個埠頻寬加倍 | 麗臺實測四條路徑總量仍約 196 Gb/s;官方寫明一條線即達完整頻寬 | 兩台直連接一條線就好 |
| ConnectX-7 的速度 | 2026 年 1 月的 Reddit 貼文寫「兩個 100Gbps 埠」 | NVIDIA 手冊:每個埠最高 200 Gb/s,由兩條約 100 Gb/s 的路徑組成 | 100Gbps 是單一路徑的數字,不是單埠 |
| 三台能不能不用交換器 | 早期說法是官方只支援兩台 | 官方已發布三台環狀教學與叢集助手(直連最多三台) | 三台環狀已有官方做法 |
八、叢集網路用 100G 會不會拖慢 AI 推論?
社群目前唯一公開的比較顯示,從 200G 降到 100G 對生成速度影響很小,但會拖慢讀取長提示的 prefill 階段。這份數據只有單一來源,引用時要保守看待。
Reddit r/LocalLLaMA 使用者 ciprianveg 在 2026 年 8 月的16 台 ASUS GX10 叢集貼文(1,049 讚)表示,他用 MikroTik CRS804-4DDQ 搭配 400G 轉 4 條 100G 的分支線,實測從 200G 降到 100G,token 生成速度只差約 2%,prefill 速度則下降約 20%;他在留言中補充,8 台跑 GLM-5.2 時差異不到 1%。同一串留言中,16 台叢集建置者 Kurcide 則認為這台交換器頻寬撐不起 16 台叢集的完整速度。
對企業的意義是:如果主要用途是聊天、短問答,100G 的影響有限;如果常丟長文件做摘要、跑需要讀大量程式碼的 AI Agent,prefill 時間佔比高,200G 比較值得。一台、兩台還是四台該怎麼選,可以參考DGX Spark 1x vs 2x 效能對決;更大規模的交換器與線材配置,可以看16 台 DGX Spark 叢集建置案例。
DGX Spark 只是地端 AI 主機的其中一種選擇。公司還在評估要用 DGX Spark、Mac Studio 還是 GPU 伺服器,可以先看地端 LLM 主機大車拼比較規格與價格,再回到地端 LLM 建置完整指南確認硬體、模型、部署框架的決策順序。
結論
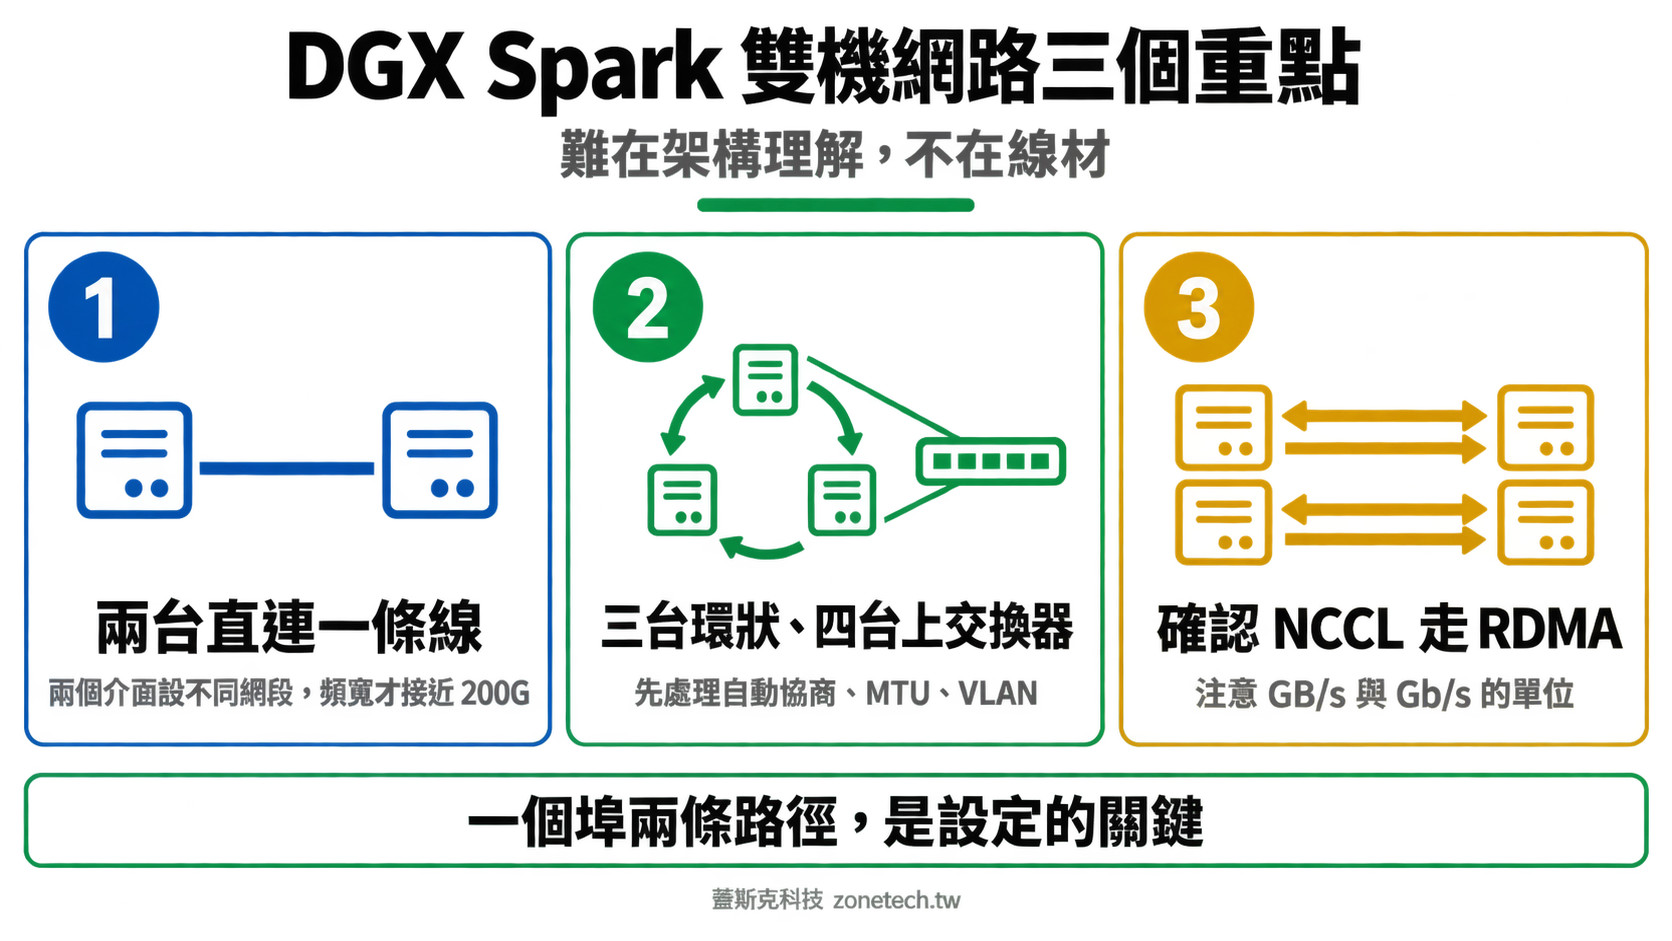
DGX Spark 的 200G 叢集網路,難在理解一個埠兩條路徑的架構,不在線材與設備。三個重點帶走:第一,兩台直連一條線就夠,兩個介面設不同網段的 IP,頻寬才會接近 200G。第二,三台照官方環狀教學接,四台以上接 200G 交換器,並先處理自動協商、MTU 與 VLAN 隔離三個預設值。第三,跑分散式推論時確認 NCCL 真的走 RDMA,看到數字差很多先確認 GB/s 和 Gb/s 的單位。
立即開始:讓你的 DGX Spark 叢集跑滿 200G
蓋斯克科技協助台灣企業規劃地端 AI 主機、叢集網路與網段隔離,從兩台直連到接交換器的多台叢集都能協助評估。
我們提供:
- 依台數與模型需求,建議直連、環狀或交換器架構
- 叢集 IP 網段規劃、netplan 設定與頻寬驗證
- 200G 交換器選型、MTU 與 VLAN 設定
- 叢集網路與辦公室網路的隔離與防火牆規則
買了兩台以上 DGX Spark,卻不確定網路有沒有跑滿?
蓋斯克科技專注台灣中小企業 IT 基礎建設,協助企業把地端 AI 主機接進公司網路,跑得快、分得清、管得住。
預約 AI 主機網路評估 免費預約諮詢電話:02-2717-1019 LINE:@zonetech
關於作者
黃俊凱 Gask Hung|蓋斯克科技創辦人,曾任 D-Link 網路研發工程師、QNAP 雲端儲存應用工程師/專案經理,近期投入地端 LLM 導入評估。完整作者介紹
延伸閱讀:DGX Spark 1x vs 2x 效能對決|16 台 DGX Spark 叢集建置案例|AI 防火牆建置指南|AI 主機導入諮詢
參考資料:麗臺科技〈网卡配置与性能验证:当 NVIDIA DGX Spark 遇上 ConnectX-7 200G〉,知乎,2025-11-20|NVIDIA〈DGX Spark User Guide: ConnectX-7 Networking〉,查詢日 2026-09-15|NVIDIA DGX Spark Playbooks:Connect Two Sparks、Connect Three Sparks、Multi Sparks Through a Switch、NCCL for Multiple Sparks|nacyot〈DGX Spark 4대를 스위치로 연결하기〉,2026-08|X:@takuz0_、@TechMDAI、@TheAhmadOsman|Reddit r/LocalLLaMA:16x Spark Cluster (Build Update)、GLM-5.2 on 4x DGX Spark