作者:Gask Hung|發布:2026-10-16|最後更新:2026-10-16
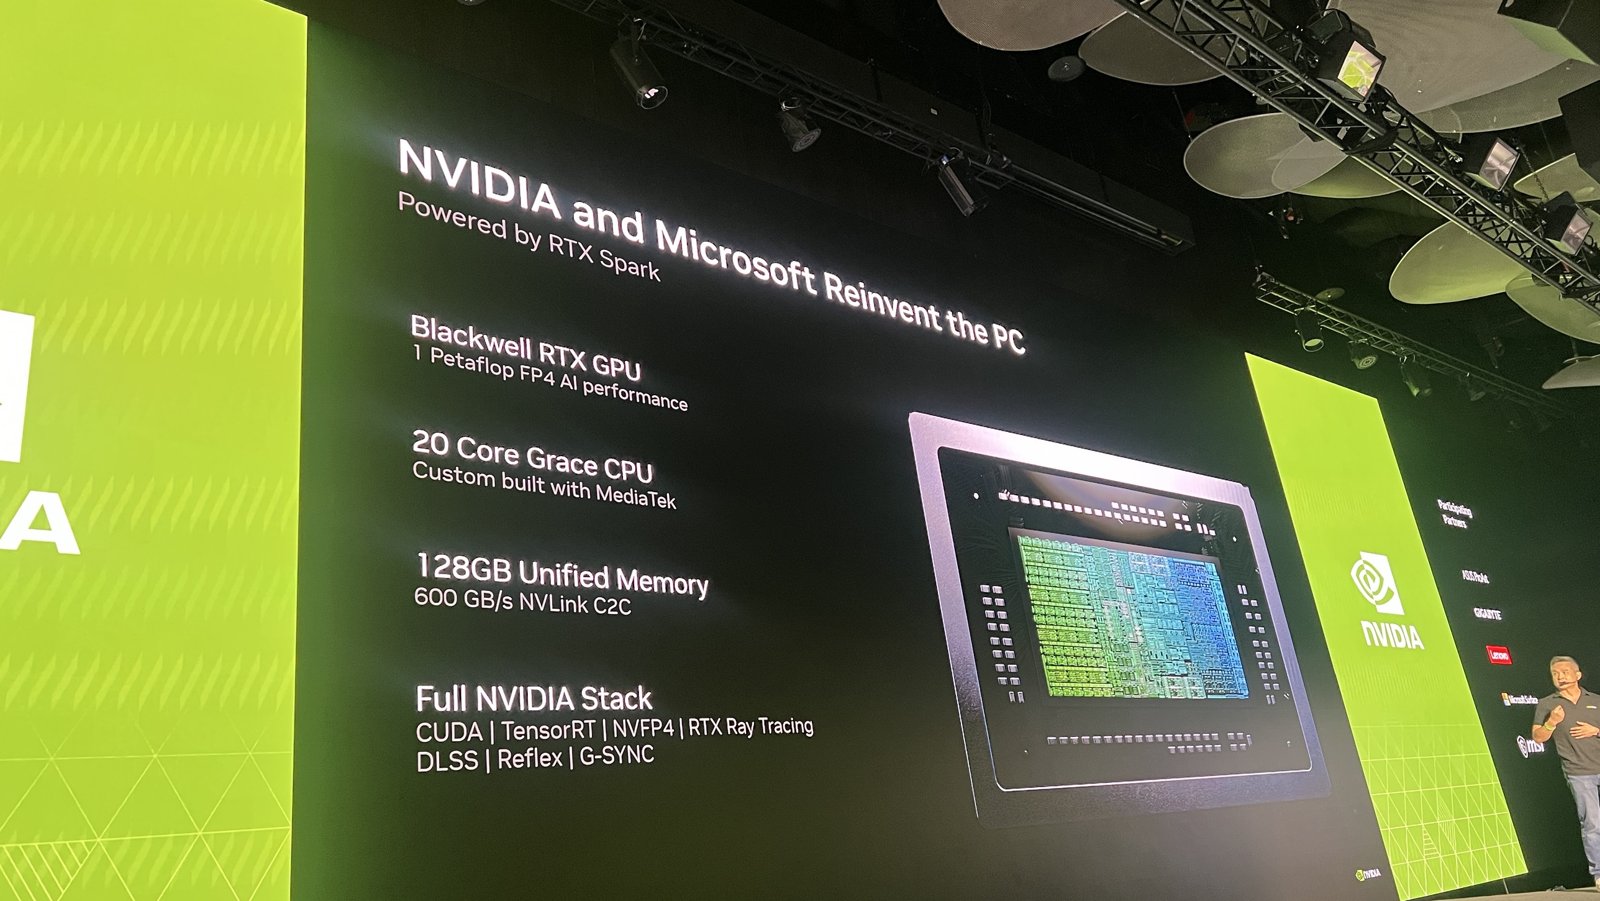
NVIDIA RTX Spark 筆電 10 月 16 日在台灣開賣,頂規 128GB 版在原價屋要價 NT$269,999。很多人看到發表會投影片上的「1 PFLOP」「128GB 統一記憶體」「600 GB/s」,就認定它是「可以帶著走的 DGX Spark」,甚至「頻寬直逼 Mac Studio」。但 600 GB/s 其實是晶片內 CPU 與 GPU 之間的互連頻寬,RTX Spark 真正的記憶體頻寬最高約 300 GB/s——跑地端大模型的吐字速度,跟 DGX Spark 同一級,離 Mac Studio 還很遠。這篇用發表會現場投影片、官方規格、台灣實際售價,加上 X、Reddit、PTT、知乎的第一手反應,幫你判斷 RTX Spark 到底適合誰。
RTX Spark 值不值得買,看三件事:(1) 記憶體頻寬約 300 GB/s,與 DGX Spark 同級,長文吐字不快;(2) Agent 工作吃算力,實測 Qwen3.8-27B 比 MacBook Pro M5 Pro 快 2 倍;(3) 台灣售價 NT$139,900 至 NT$269,999。適合隨身跑 AI Agent、創作與遊戲;團隊共用請選 DGX Spark 或 GPU 伺服器。
📋 本文重點摘要
- RTX Spark 是 NVIDIA 與 Microsoft、聯發科合作的 Windows PC 平台,晶片叫 N1X:20 核 Grace CPU+6,144 核 Blackwell GPU,最高 128GB 統一記憶體、1 PFLOP(FP4)。
- 「600 GB/s」是 NVLink-C2C 互連頻寬,不是記憶體頻寬;記憶體頻寬最高約 300 GB/s,決定長文吐字速度;Agent 工作則吃算力,Artificial Analysis 實測 RTX Spark 與 DGX Spark 相近、比 MacBook Pro M5 Pro 快 2 倍。
- 台灣原價屋售價 NT$139,900(MSI 64GB)至 NT$269,999(ASUS ProArt P16 128GB);小型桌機 11 月上市。
- 社群共識:GPU 與 CUDA 生態是賣點,價格、頻寬、Windows on Arm 相容性是三大疑慮。企業多人共用 AI,應優先評估 DGX Spark 或 GPU 伺服器。
👤 適合閱讀對象
- 企業 IT/MIS 主管:老闆看到新聞想幫 AI 團隊換 RTX Spark 筆電,需要一份能拿去開會的規格與預算比較。
- AI 工程師、開發者:目前用 Mac 或雲端 GPU 跑模型,想知道 RTX Spark 的 128GB 能不能取代 DGX Spark 或 Mac Studio。
- 3D/影音創作者:需要 CUDA、RTX 光追,又想要一台能整天拔電使用的輕薄筆電,正在比較 RTX Spark 跟傳統 RTX 5070/5080 筆電。
不確定你們團隊該買 RTX Spark、DGX Spark 還是 Mac Studio?加 LINE 傳你們要跑的模型名稱和使用人數,我們先幫你估算記憶體與預算 → 加 LINE 諮詢
以下先拆解 RTX Spark 的晶片架構與最容易被誤讀的頻寬規格,再做三機比較、台灣售價整理、地端 LLM 實力評估與社群反應,最後給企業一套採購前的判斷流程。
一、NVIDIA RTX Spark 是什麼?N1X 超級晶片一次看懂
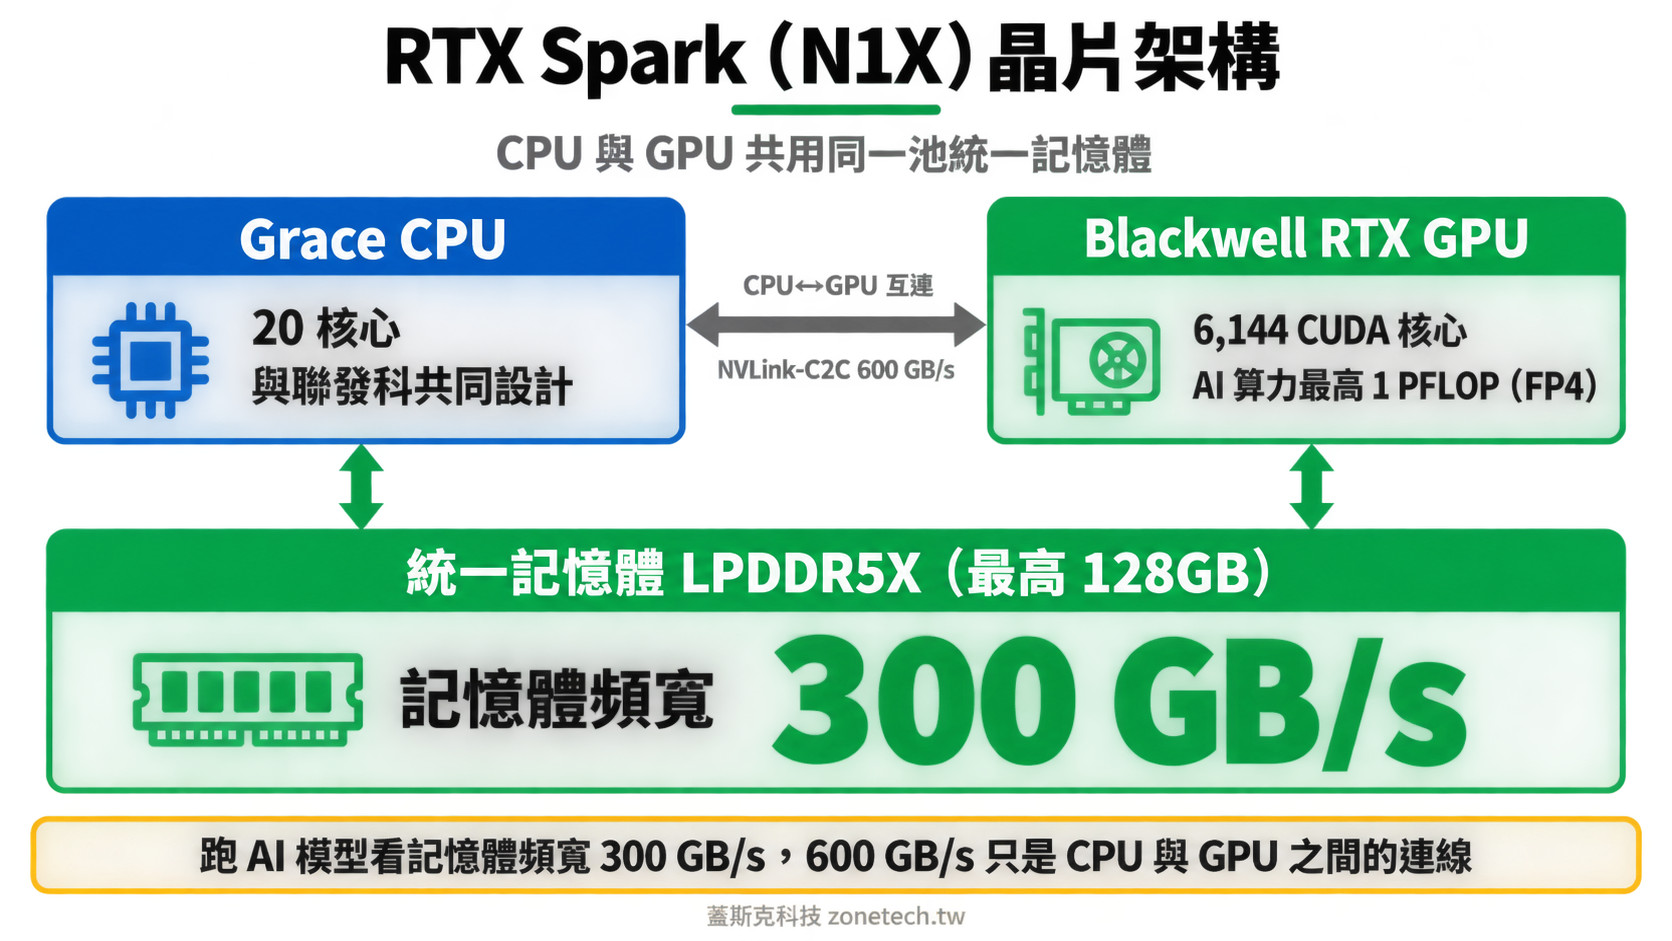
NVIDIA RTX Spark 是 NVIDIA 第一個 Windows PC 平台,把 Arm 架構 CPU、Blackwell GPU 與最高 128GB 統一記憶體封裝成一顆 N1X 晶片。RTX Spark 在 2026 年 5 月 31 日的台北 Computex 首度亮相,10 月 7 日由 NVIDIA 與 Microsoft 在舊金山正式宣布上市,筆電 10 月 16 日開賣,小型桌機 11 月上市(NVIDIA 新聞稿,2026)。
一個好懂的比喻:傳統筆電的 CPU 和獨立顯卡像兩間各自有倉庫的工廠,原料(資料)要用貨車在兩間倉庫之間來回搬,顯卡倉庫只有 8~16GB。RTX Spark 則是把兩間工廠蓋在同一座 128GB 的大倉庫旁邊,大家共用庫存,大模型不用再因為「顯卡倉庫放不下」而被拒於門外。但倉庫大門有多寬(記憶體頻寬),決定了每秒能搬多少貨出來——這正是第二節要談的重點。
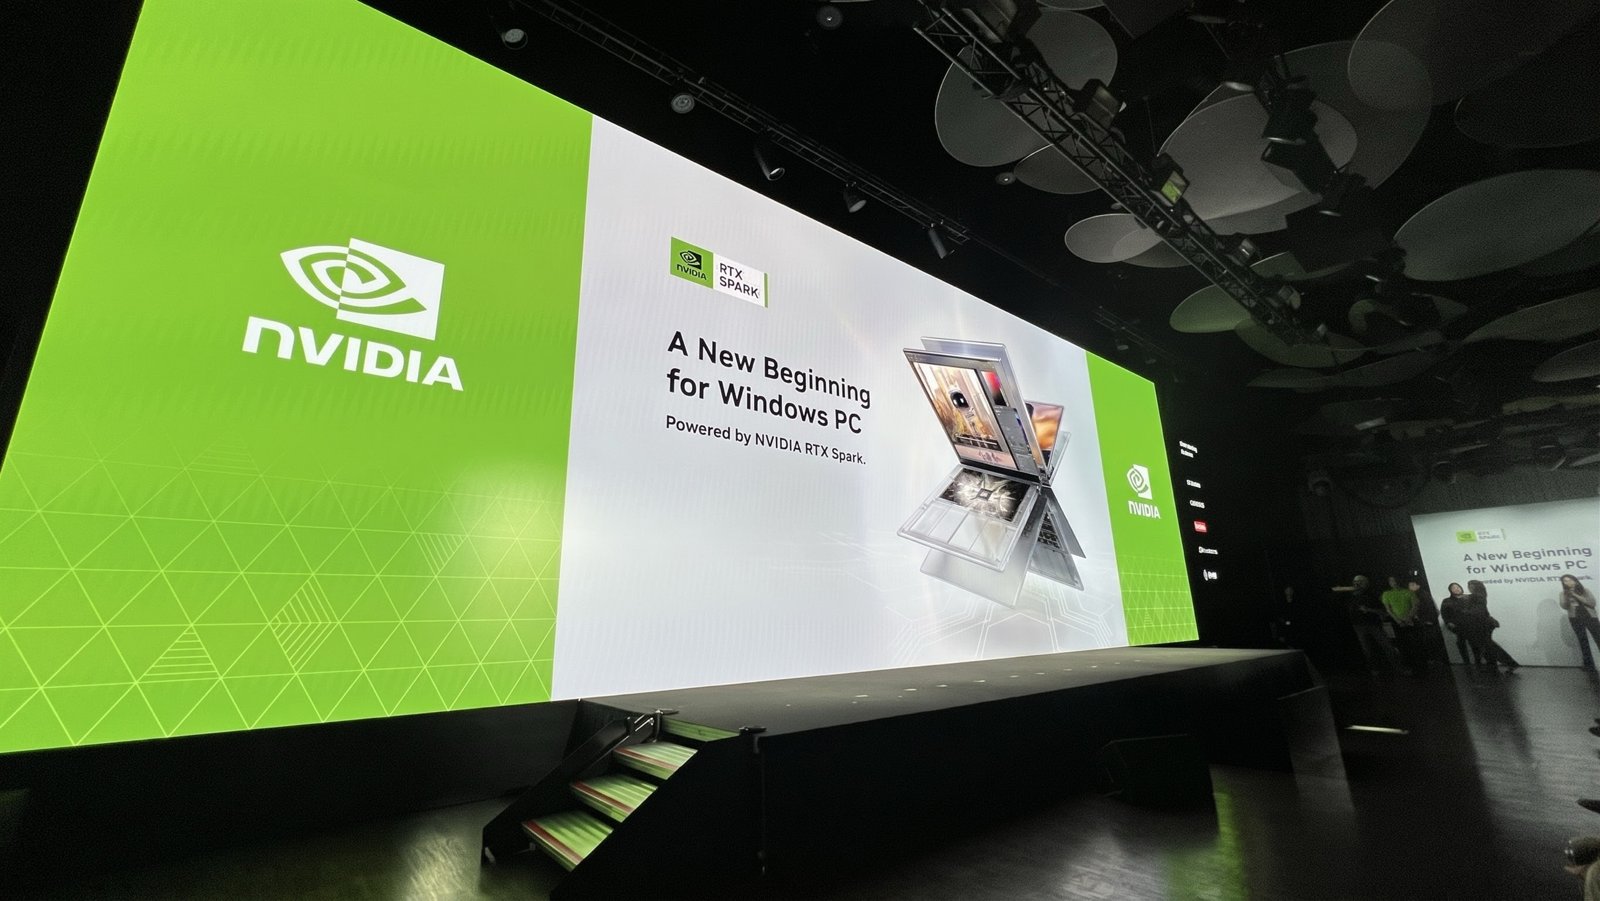
NVIDIA 在發表會投影片把 RTX Spark 定位為「One PC for Creators, Gamers and Agents」(一台給創作者、玩家與 AI Agent 的電腦),四個主軸分別是 N1X 超級晶片、RTX 軟體堆疊、Windows+AI Agent 與輕薄長續航。下表整理 N1X 兩個版本的官方規格:
| 規格 | N1X 高階版 | N1X 次階版 |
|---|---|---|
| CPU | 20 核 Grace(10× Cortex-X925+10× A725),與聯發科共同設計 | 18 核(9× X925+9× A725) |
| GPU | Blackwell RTX,6,144 CUDA 核心 | Blackwell RTX,5,120 CUDA 核心 |
| 統一記憶體 | 最高 128GB LPDDR5X | 24GB 起,官網標示最高 64GB |
| 記憶體頻寬 | 256-bit LPDDR5X-9400,最高約 300 GB/s | |
| CPU↔GPU 互連 | NVLink-C2C 600 GB/s(雙向) | |
| AI 算力 | 最高 1 PFLOP(FP4/NVFP4) | |
| 功耗(TDP) | 筆電 45–80W;小型桌機 140W | |
| 製程 | 台積電 3nm | |
| 軟體堆疊 | CUDA、TensorRT、NVFP4、RTX 光追、DLSS、Reflex、G-SYNC | |
RTX Spark 的 GPU 效能約落在筆電版 RTX 5070 附近。聯合報轉載 mashdigi 的報導指出,在 60W 功耗下,RTX Spark 的能效是「Core Ultra 9 285H+RTX 5070 筆電」組合的 2 倍(聯合新聞網,2026)。Windows Central 實測 Surface Laptop Ultra 頂規機,3DMark Time Spy 跑出 12,771 分,約為 RTX 4070 筆電的等級(Windows Central,2026)。
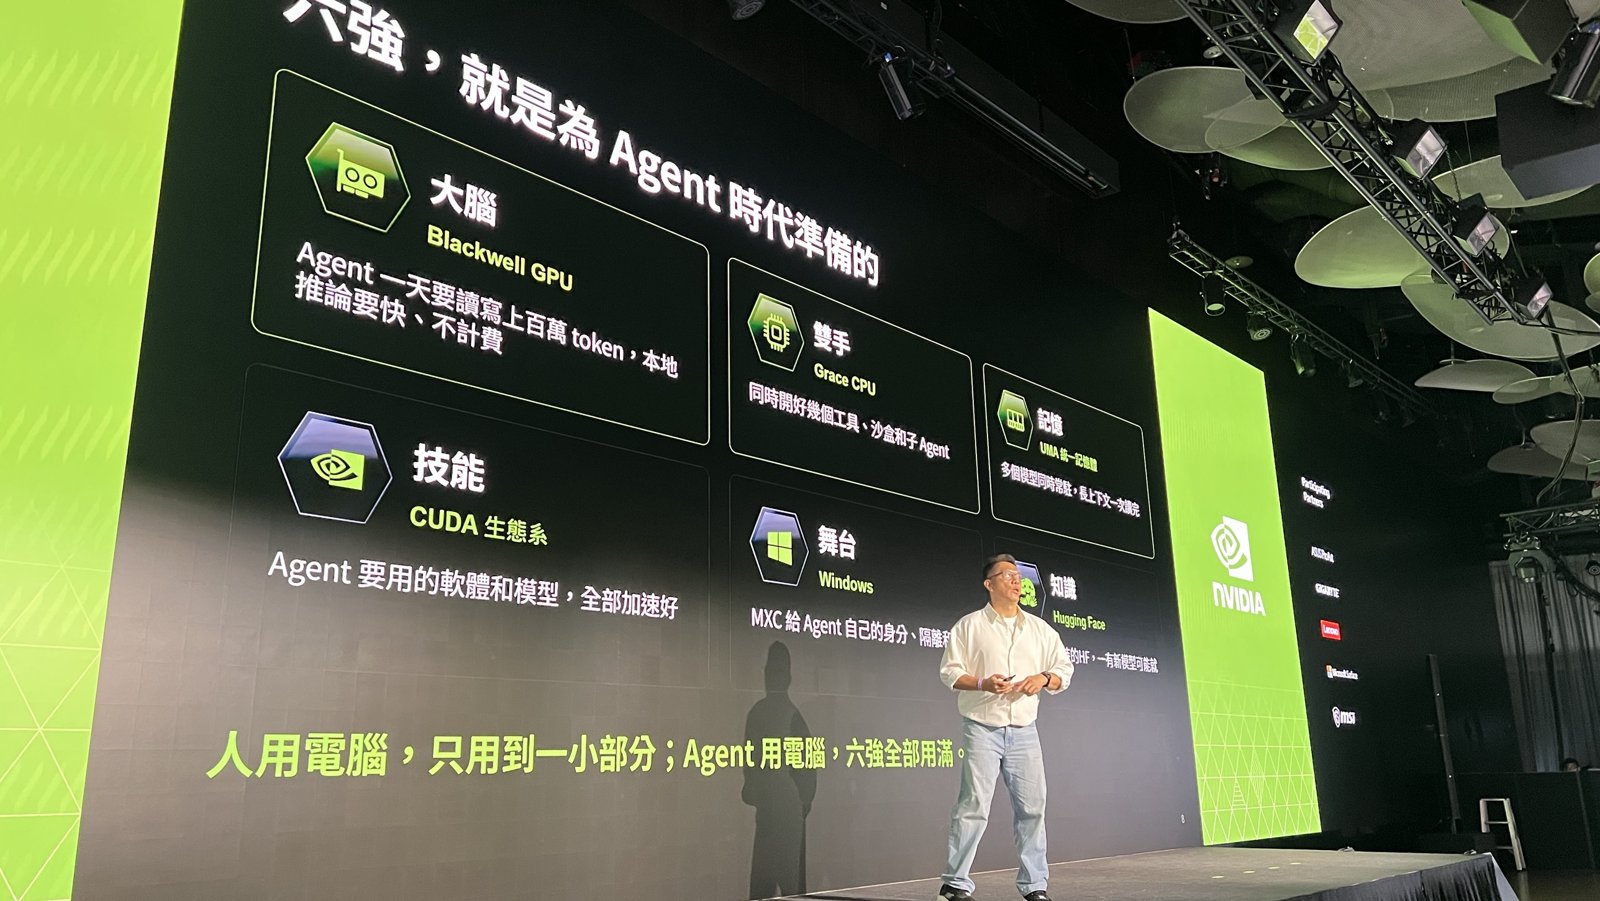
NVIDIA 在台北場活動用「六強」說明 RTX Spark 為什麼是為 AI Agent 設計的:硬三強是大腦(Blackwell GPU,Agent 一天要讀寫上百萬 token,本地推論要快、不計費)、雙手(Grace CPU,同時開好幾個工具、沙盒和子 Agent)、記憶(UMA 統一記憶體,多個模型同時常駐、長上下文一次讀完);軟三強是技能(CUDA 生態系)、舞台(Windows,MXC 給 Agent 自己的身分與隔離)與知識(Hugging Face 上的開源模型)。投影片的結論是:「人用電腦,只用到一小部分;Agent 用電腦,六強全部用滿。」
二、RTX Spark 的 600 GB/s 是記憶體頻寬嗎?最容易誤讀的規格
不是。600 GB/s 是 CPU 與 GPU 之間的 NVLink-C2C 互連頻寬,RTX Spark 的記憶體頻寬最高約 300 GB/s。發表會投影片把「128GB Unified Memory」與「600 GB/s NVLink C2C」寫在同一行,很多人因此讀成「128GB 記憶體、頻寬 600 GB/s」。PTT PC_Shopping 板的討論串裡就有網友這樣解讀,隨即被其他人更正(PTT,2026);Reddit r/MacStudio 也有使用者特別點出同一件事。
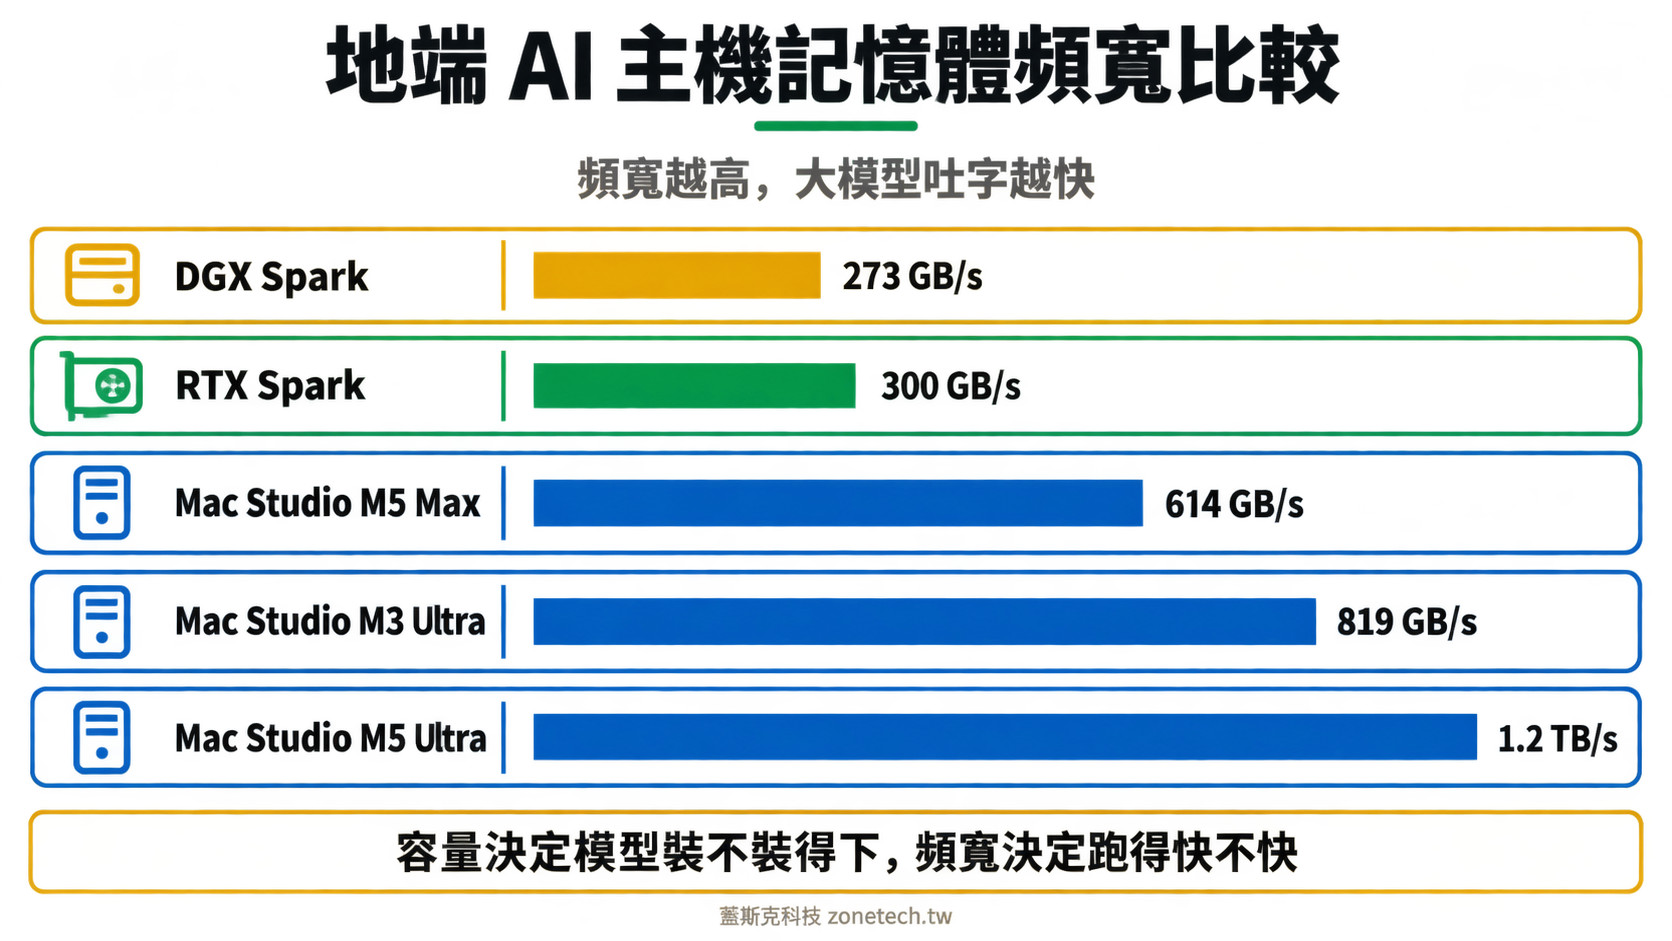
記憶體頻寬是地端 LLM 最關鍵的規格。大型語言模型每吐出一個字(token),都要把整個模型的權重從記憶體讀一遍,所以吐字速度的理論上限大約等於「記憶體頻寬 ÷ 模型大小」。以一個量化成 4-bit、約 15GB 的 27B Dense 模型估算,RTX Spark 的理論上限約每秒 20 個 token,Mac Studio M5 Max(614 GB/s)約 40 個(蓋斯克依頻寬換算的理論估算,實際速度會再打折)。
| 機種 | 記憶體頻寬 | 最大統一記憶體 | 適用情境 |
|---|---|---|---|
| NVIDIA DGX Spark | 273 GB/s | 128GB | CUDA 開發、可多機串接 |
| NVIDIA RTX Spark | 最高約 300 GB/s | 128GB | 隨身 AI+創作+遊戲 |
| Mac Studio M5 Max | 460~614 GB/s | 依配置 | 中型模型推論 |
| Mac Studio M3 Ultra(上一代) | 819 GB/s | 512GB | 超大模型推論 |
| Mac Studio M5 Ultra | 1.2 TB/s | 512GB | 超大模型、高速推論 |
那 600 GB/s 的 NVLink-C2C 有什麼用?NVLink-C2C 讓 CPU 與 GPU 存取彼此資料時不必經過傳統 PCIe 的瓶頸,對需要 CPU 與 GPU 頻繁交換資料的工作(例如影片生成流程、3D 場景載入)有幫助,但不會讓大模型的吐字速度翻倍。如果你想深入了解頻寬、容量與模型大小的換算方式,可以參考蓋斯克整理的 LLM 主機規格怎麼抓:模型參數 × VRAM × 預算對照表。
三、RTX Spark、DGX Spark、Mac Studio 怎麼選?
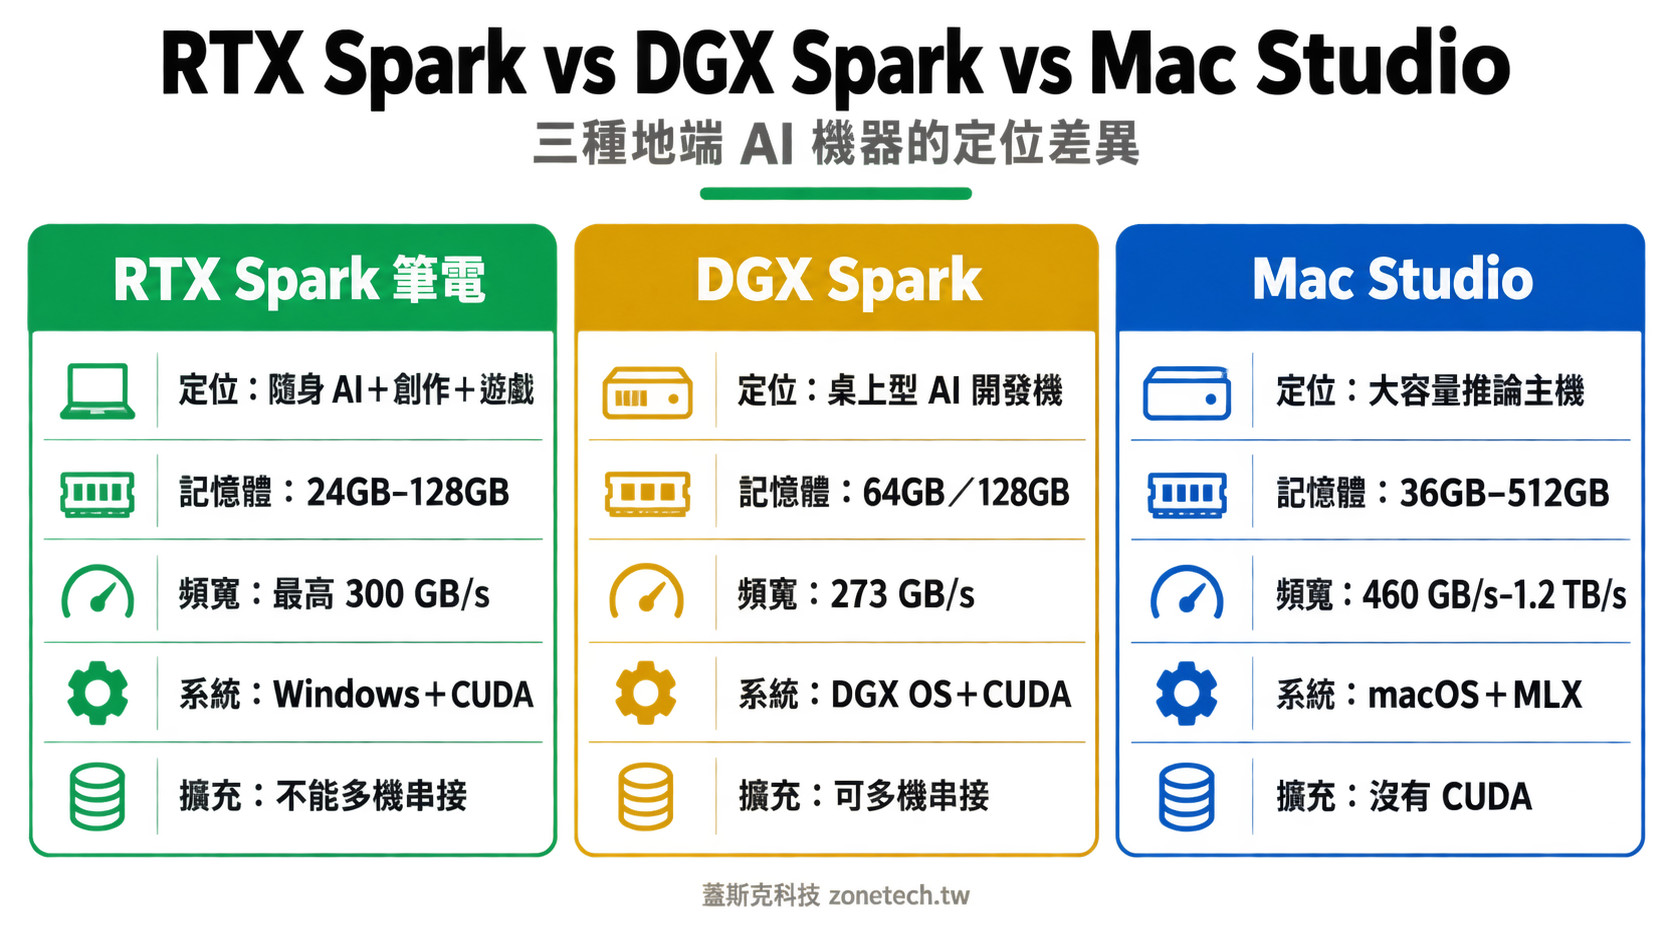
三台機器的差別不在算力,而在使用形態:RTX Spark 是隨身全能機,DGX Spark 是可串接的 CUDA 開發機,Mac Studio 是大容量推論主機。RTX Spark 與 DGX Spark 都標示 1 PFLOP(FP4)算力、都是 20 核 Arm CPU 加 Blackwell GPU,單看晶片規格幾乎是兄弟;真正的分野在作業系統、能不能串接、能不能帶出門。
| 比較項目 | NVIDIA RTX Spark | NVIDIA DGX Spark | Apple Mac Studio(M5) |
|---|---|---|---|
| 裝置形態 | 14~16 吋筆電、小型桌機 | 桌上型迷你主機 | 桌上型迷你主機 |
| 晶片 | N1X(Grace CPU+Blackwell GPU) | GB10 Grace Blackwell | M5 Max/M5 Ultra |
| 統一記憶體 | 24GB~128GB(焊死) | 64GB/128GB(焊死) | 36GB~512GB(焊死) |
| 記憶體頻寬 | 最高約 300 GB/s | 273 GB/s | 460 GB/s~1.2 TB/s |
| AI 算力 | 1 PFLOP(FP4) | 1 PFLOP(FP4) | Apple 未以 FP4 標示 |
| 作業系統/軟體 | Windows on Arm+完整 CUDA | DGX OS(Linux)+CUDA | macOS+MLX/Metal |
| 多機串接 | 無 ConnectX 介面,不能串 | ConnectX-7 200G,可 2 台以上串接 | Thunderbolt 叢集(非 CUDA) |
| 遊戲與創作 | RTX 光追、DLSS、多數反作弊已支援 | 不適合 | Mac 遊戲生態有限 |
| 功耗 | 筆電 45~80W、桌機 140W | GB10 TDP 140W | 依配置 |
| 適用情境 | 個人隨身開發、展示、創作+遊戲 | 團隊 CUDA 開發、微調、小型叢集 | 單機跑最大模型、重視吐字速度 |
何時選 RTX Spark
RTX Spark 適合「一台電腦要同時做 AI 開發、影音或 3D 創作、偶爾玩遊戲,而且要帶著走」的人。RTX Spark 是目前唯一能在 Windows 輕薄筆電上原生跑 CUDA、又有 128GB 統一記憶體的選擇;業務簡報要現場跑 AI Demo、顧問到客戶端做 PoC,都是它的強項。
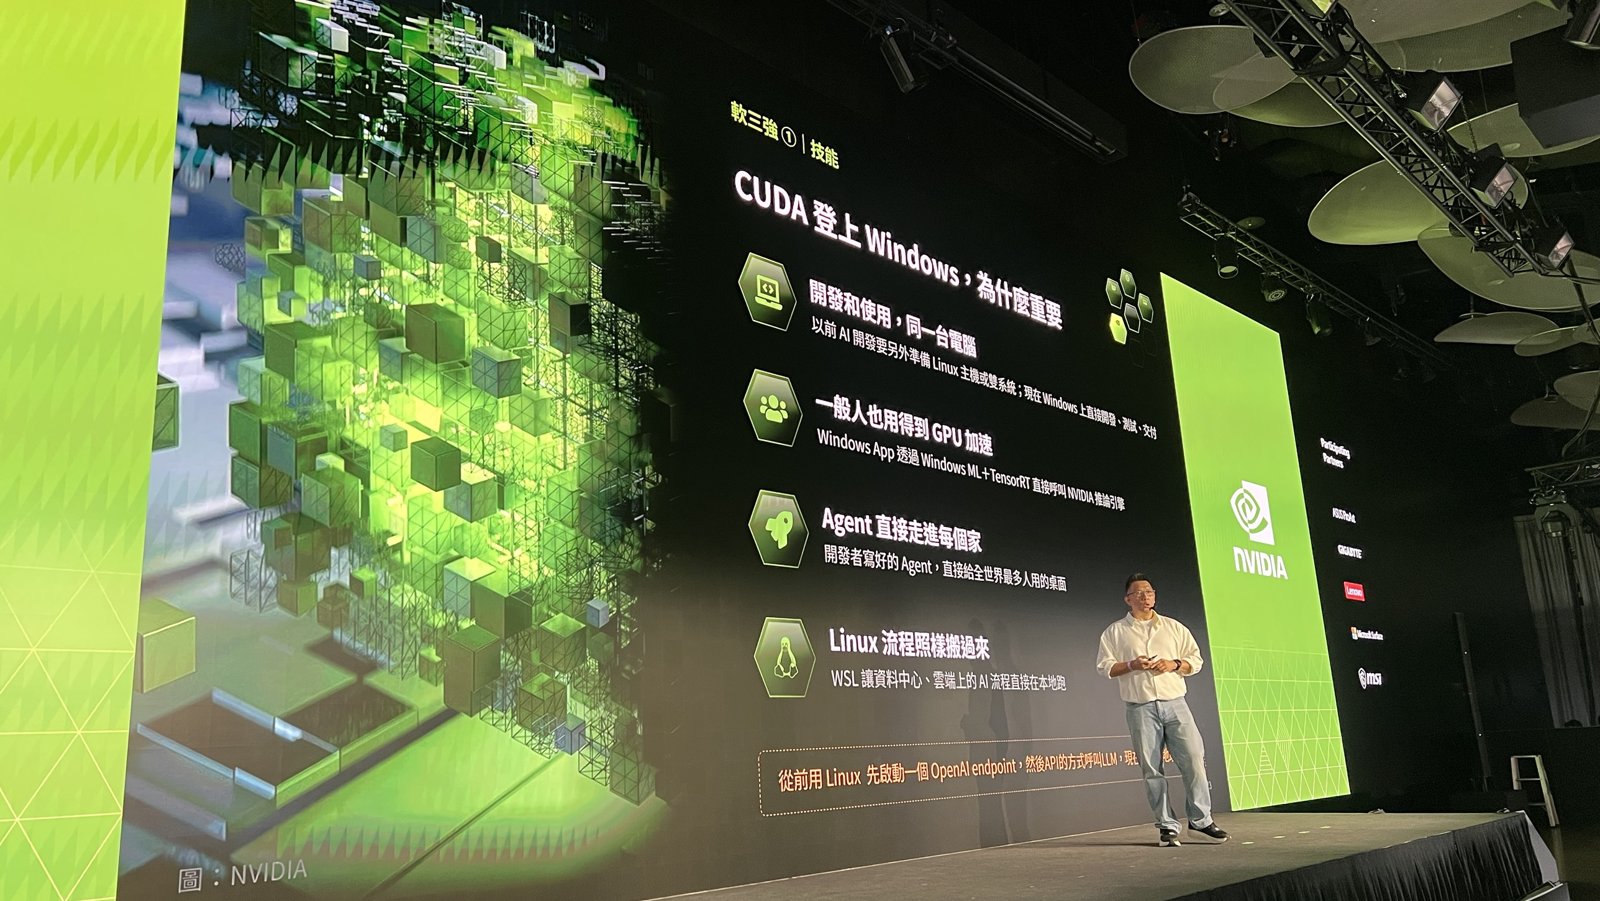
CUDA 原生登上 Windows 也改變了開發流程。NVIDIA 在台北場活動列出四個重點:以前 AI 開發要另外準備 Linux 主機或雙系統,現在 Windows 上直接開發、測試、交付;一般 Windows App 透過 Windows ML+TensorRT 就能呼叫 NVIDIA 推論引擎;開發者寫好的 Agent 可以直接交給最多人用的桌面;資料中心與雲端上的 Linux AI 流程則透過 WSL 照樣搬到本機執行。
何時選 DGX Spark
DGX Spark 適合放在辦公室給團隊共用的 CUDA 開發與微調工作。DGX Spark 有 ConnectX-7 網路,兩台可以串接成 256GB,跑單機放不下的模型;RTX Spark 沒有這個介面,Reddit r/llamacpp 有網友直言「沒有 CX7,單機 RTX Spark 意義不大」。DGX Spark 的串接做法可參考 DGX Spark 1x vs 2x 效能對決。
何時選 Mac Studio
Mac Studio 適合「不需要 CUDA、只想把最大的模型塞進一台機器,而且要吐字快」的需求。Mac Studio M5 Ultra 的 1.2 TB/s 頻寬是 RTX Spark 的 4 倍,最高 512GB 記憶體也遠大於 128GB。不過要注意,Microsoft 宣稱 RTX Spark 筆電對比 M5 Pro 的 16 吋 MacBook Pro,首個 token 回應速度快 2.1 倍、AI 圖片生成快 4.3 倍、AI 影片生成快 6.2 倍(智東西整理微軟公布數據,2026)。這些是原廠數據,而且比的是「讀完提示詞」與「生成圖片影片」這類吃算力的工作,正是 RTX Spark 1 PFLOP 的強項;長篇文字的吐字速度則仍由記憶體頻寬決定,Mac Studio 依然佔優;第五節會用 Artificial Analysis 的實測說明這兩種工作的差別。完整的 Mac 與 DGX 比較,請看 DGX Spark vs Mac Studio 怎麼選。
四、RTX Spark 台灣售價多少?機型與價格整理
RTX Spark 筆電台灣售價 NT$139,900 起,128GB 頂規機落在 NT$239,900~NT$269,999。原價屋 10 月 8 日至 13 日開放預購,10 月 16 日晚上在松菸舉辦現場交機,10 月 17 日起門市取貨或宅配。原價屋上架的機型全部是 20 核/6,144 GPU 核心的高階版(原價屋 RTX Spark 專頁,2026)。
| 機型 | 記憶體/SSD | 重量 | 台灣售價(原價屋) |
|---|---|---|---|
| MSI Prestige N16 Flip AI+ | 64GB/1TB | 1.9kg | NT$139,900 |
| Lenovo Yoga Pro 9 | 64GB/1TB | 1.65kg | NT$159,990 |
| MSI Prestige N16 Flip AI+ | 128GB/2TB | 1.9kg | NT$239,900 |
| ASUS ProArt P14 | 128GB/1TB | 1.48kg | NT$249,999 |
| ASUS ProArt P16 | 128GB/2TB | 1.77kg | NT$269,999 |
美國方面,RTX Spark 筆電從 US$2,599.99 起跳(Surface Laptop Ultra 與 ASUS ProArt P14 的 18 核/24GB 入門款),Surface 128GB 頂規 US$5,899.99;小型桌機 Surface RTX Spark Dev Box(20 核、128GB、2TB)定價 US$5,999.99,11 月出貨。ASUS ProArt GR1X 與 MSI EdgeMesa 等桌機台灣售價目前尚未公布(The Gadgeteer,2026)。
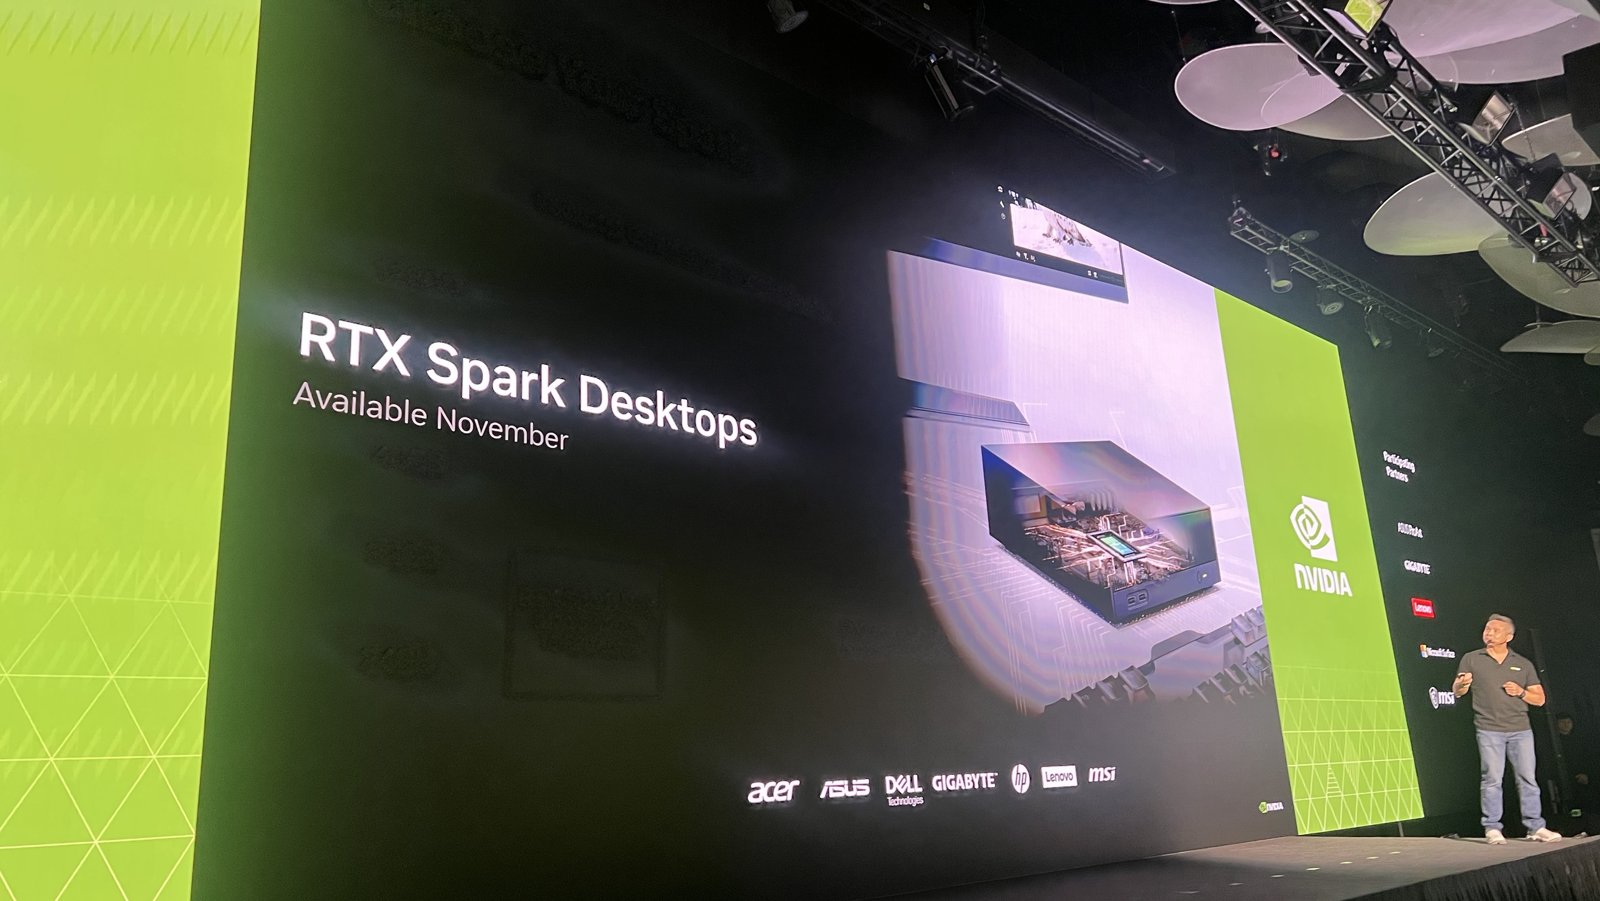
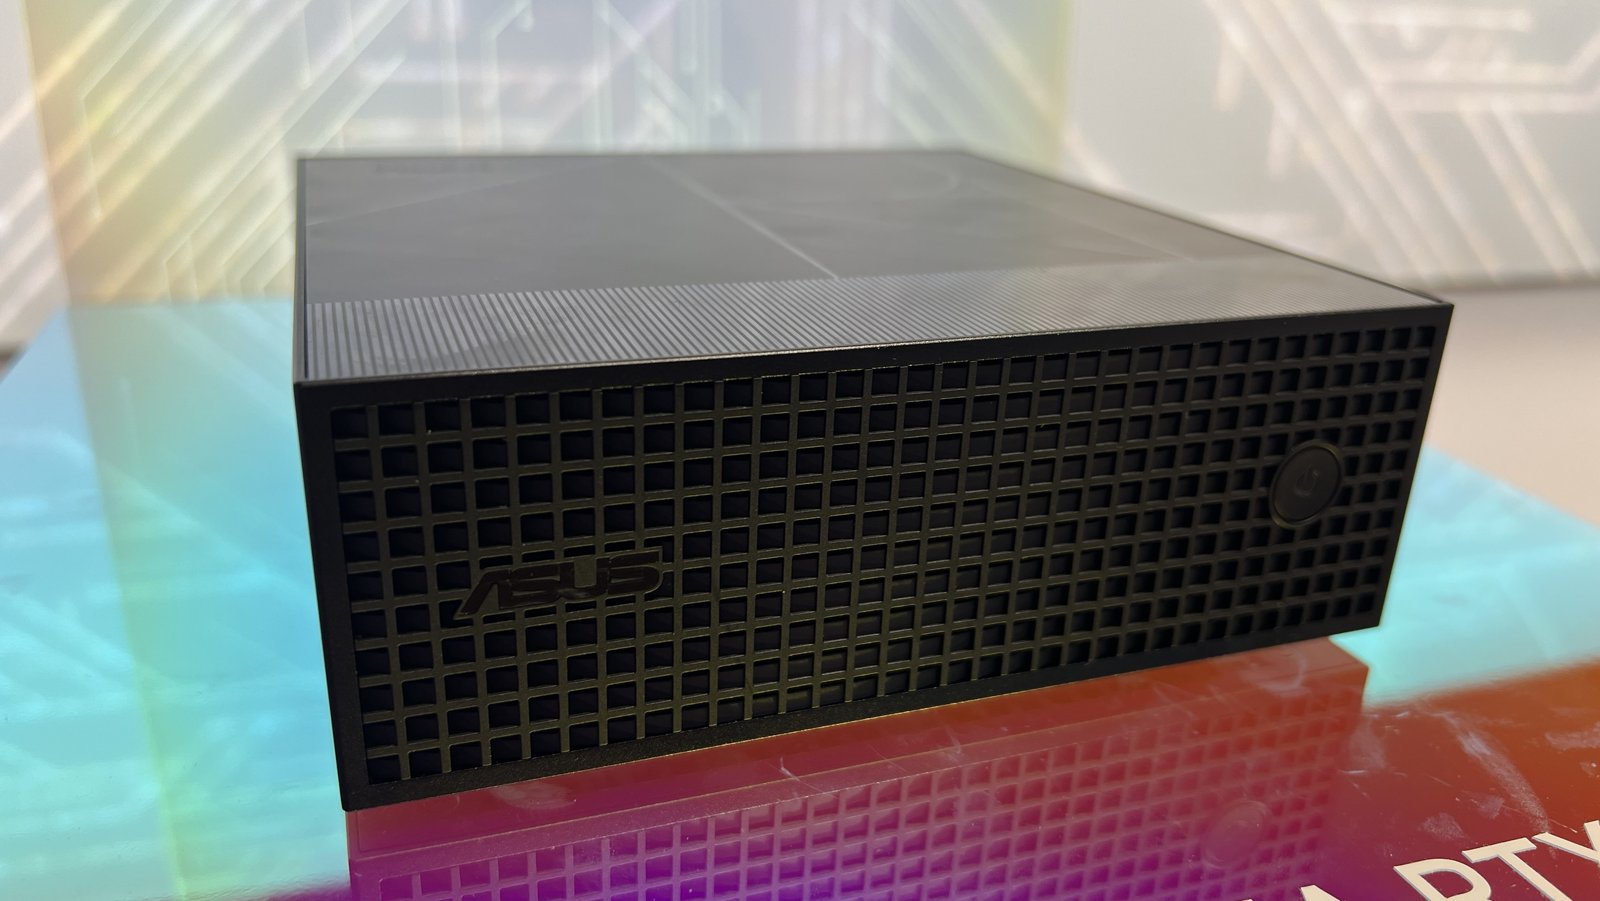
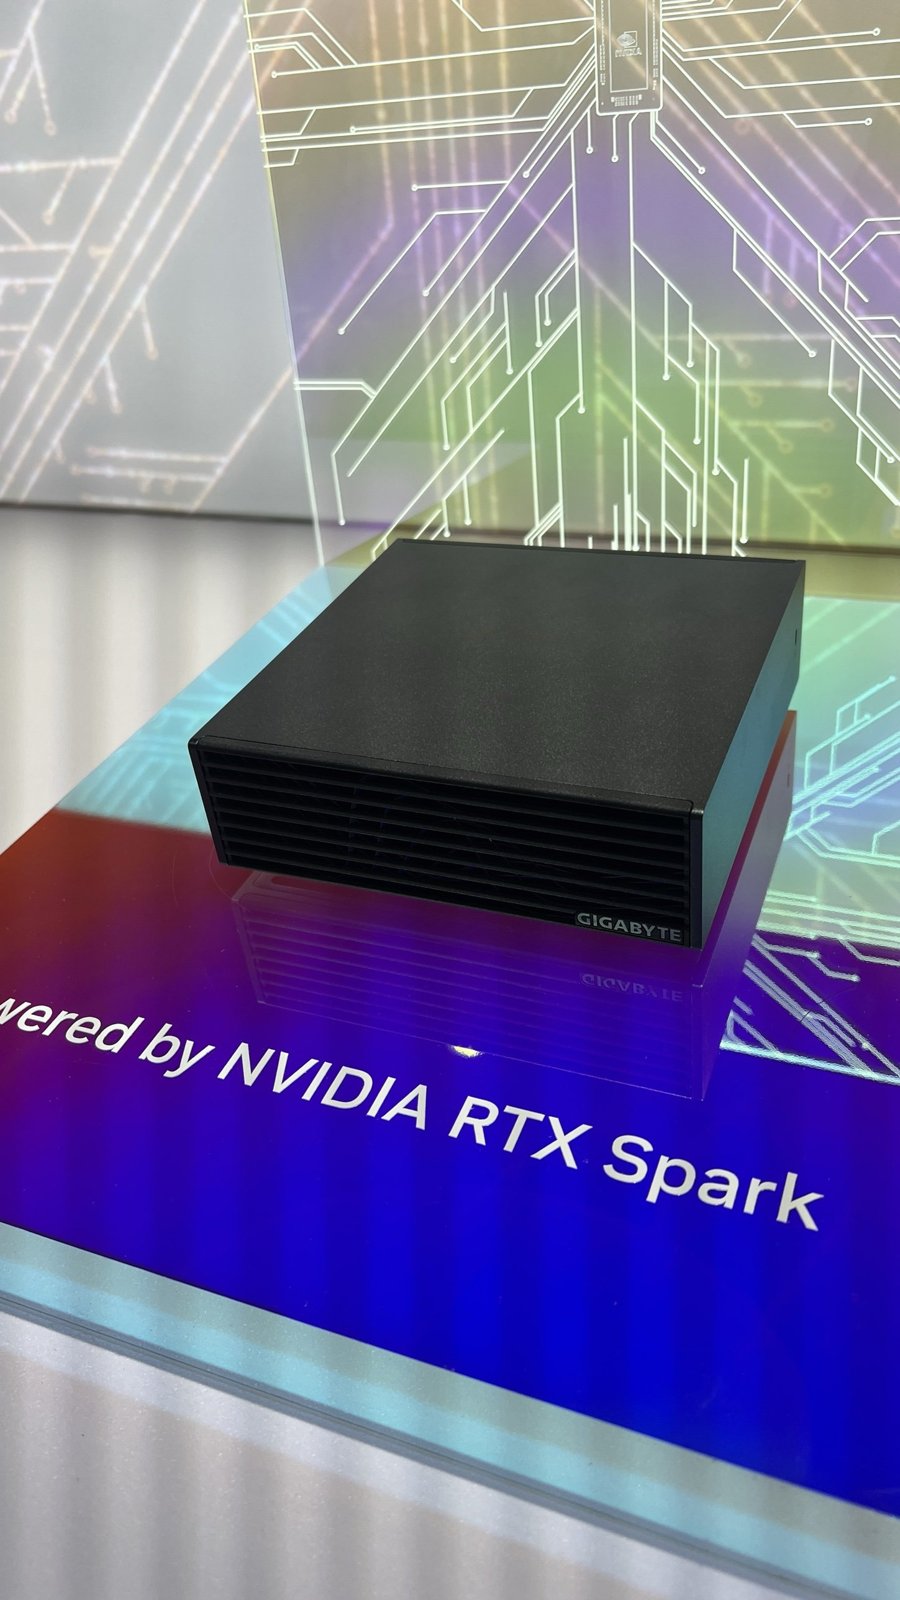
台北場活動現場也展出了 ASUS 與 GIGABYTE 的 RTX Spark 小型桌機實機,機身大小約與一般迷你 PC 相當。小型桌機的 TDP 為 140W,比筆電的 45–80W 更能讓 GPU 跑滿,適合放在辦公室當常駐的 AI Agent 主機;兩款機型的台灣售價截至發稿前尚未公布。
拿來對照的兩台:Mac Studio 在 Apple 台灣官網售價為 M5 Max(36GB)NT$84,900 起、M5 Ultra(96GB)NT$199,900 起;DGX Spark 在 2026 年 3 月由 US$3,999 調漲至 US$4,699,台灣售價約 NT$15 萬上下(T 客邦,2026)。DGX Spark 的台灣通路與採購注意事項,蓋斯克整理在 DGX Spark 台灣完整購買指南。
五、RTX Spark 能跑多大的地端 LLM?
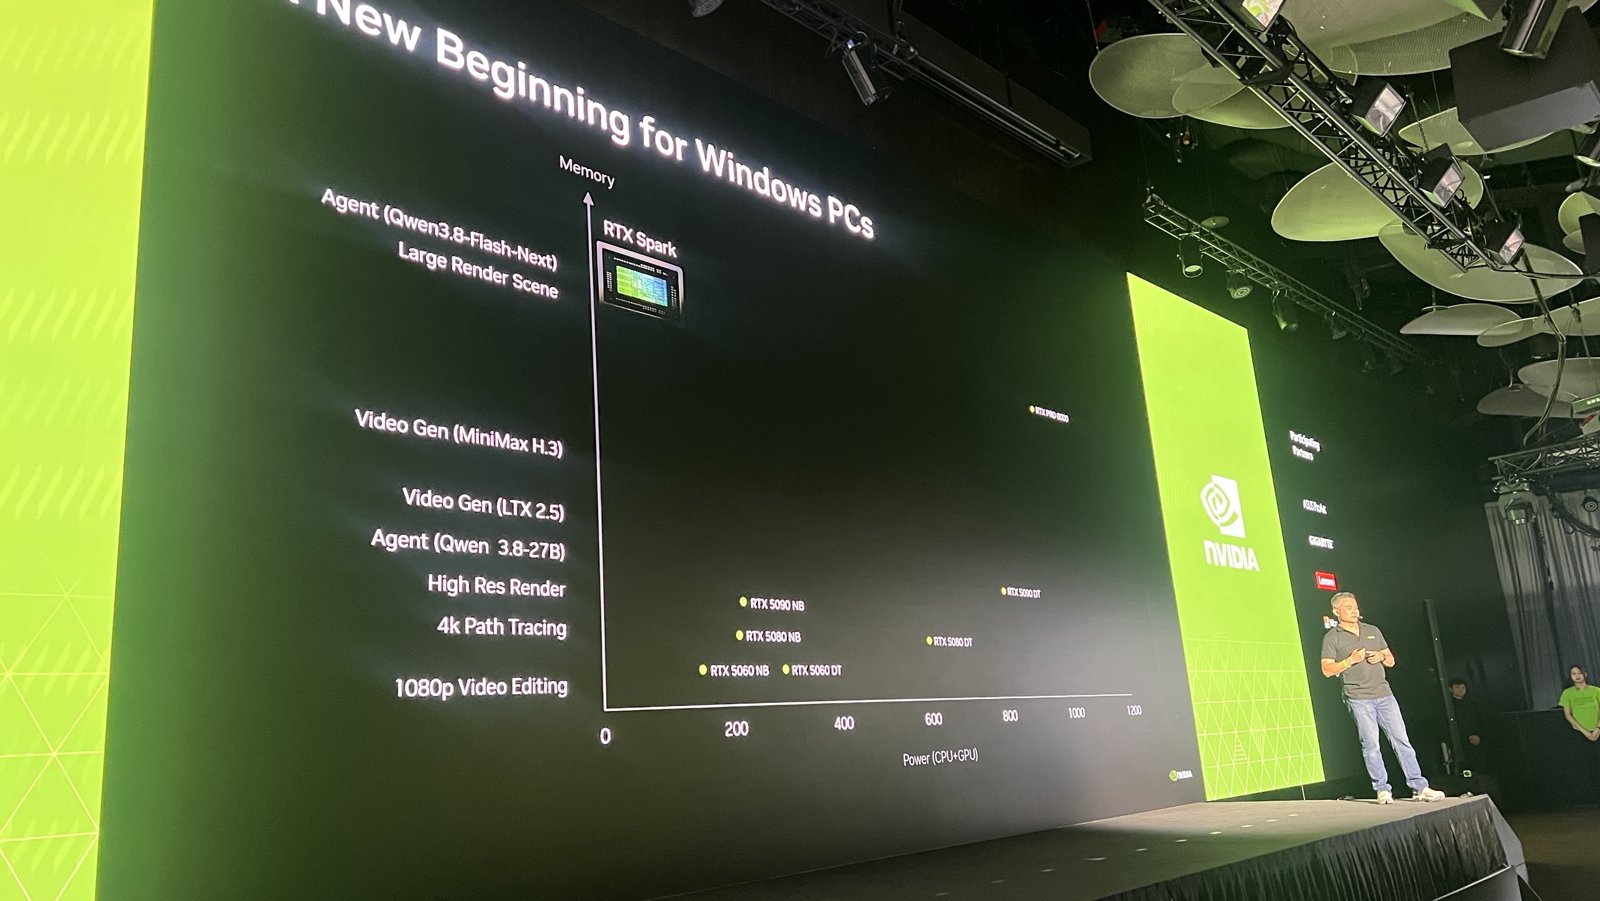
128GB 的 RTX Spark 裝得下百億級參數的 MoE 模型,但跑 Dense 大模型會受限於 300 GB/s 頻寬,速度只能算堪用。NVIDIA 在發表會用一張「記憶體 × 功耗」圖說明 RTX Spark 的定位:傳統 RTX 5060~5090 筆電與桌機顯卡的 VRAM 只夠做 1080p 剪輯、4K 路徑追蹤與高解析算圖;RTX Spark 因為有大容量統一記憶體,能往上跑 Qwen3.8-27B Agent、LTX 2.5 與 MiniMax H.3 影片生成,最頂端是 Qwen3.8-Flash-Next 這類 Agent 模型與大型算圖場景。
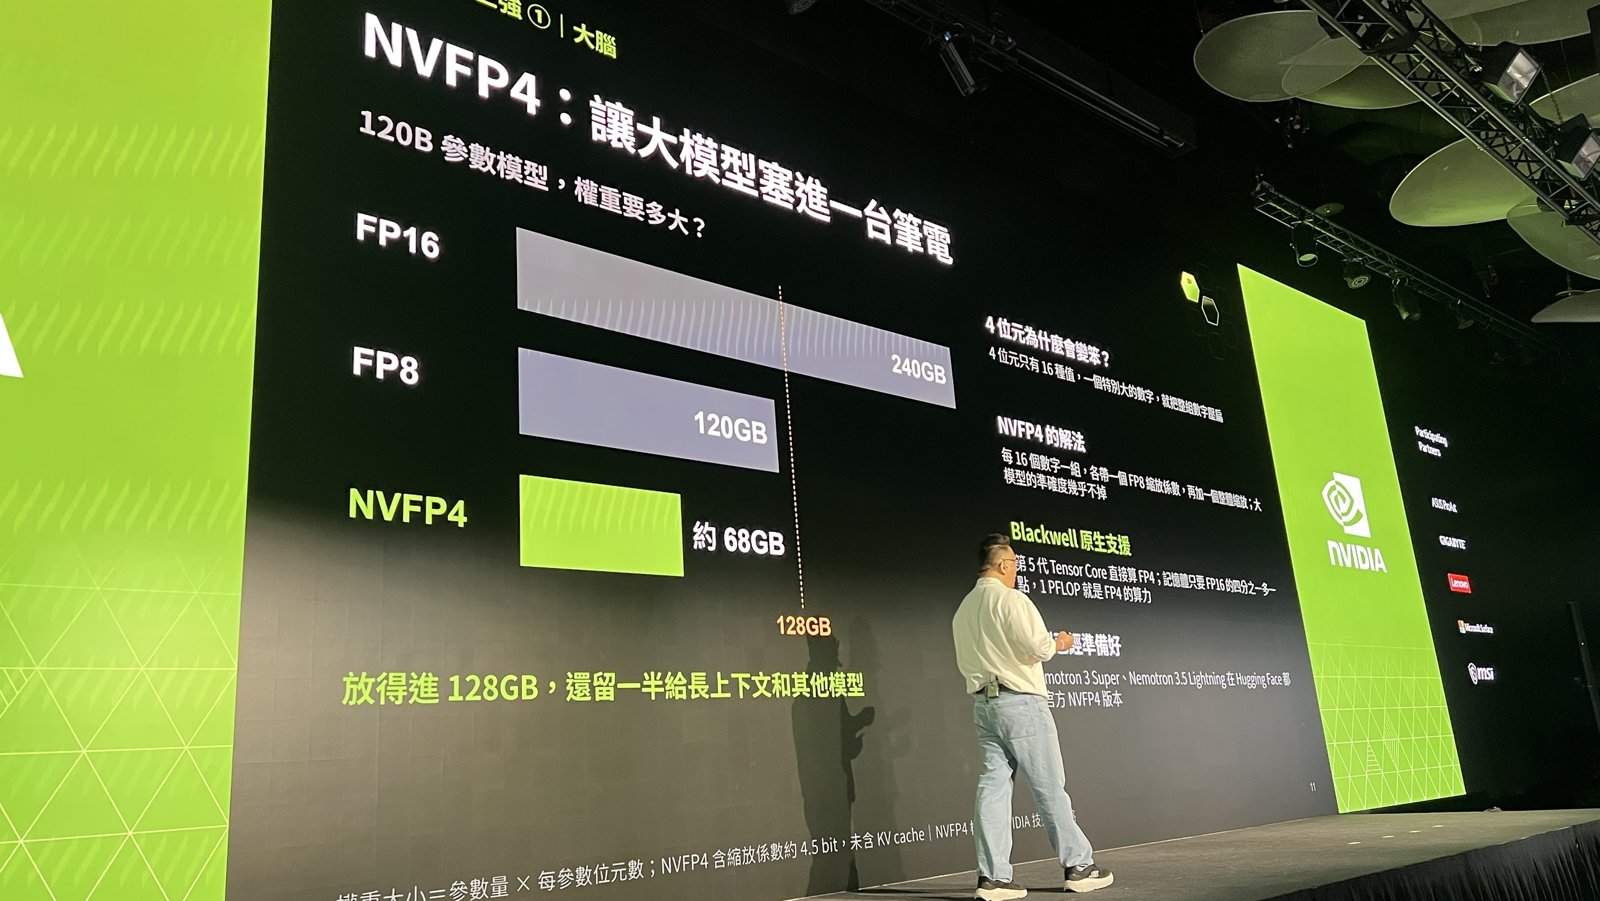
RTX Spark 能把百億級模型塞進筆電,關鍵是 NVFP4 這種 4 位元格式。NVIDIA 在台北場用 120B 參數模型舉例:權重用 FP16 存要 240GB、FP8 要 120GB,NVFP4 約 68GB,放得進 128GB 還留一半給長上下文和其他模型。NVFP4 的做法是每 16 個數字一組、各帶一個 FP8 縮放係數,含縮放係數後約每參數 4.5 bit(不含 KV Cache),Blackwell 的第五代 Tensor Core 可直接以 FP4 運算,1 PFLOP 指的就是 FP4 算力。NVIDIA 自家的 Nemotron 3 Super、Nemotron 3.5 Lightning 已在 Hugging Face 提供官方 NVFP4 版本。
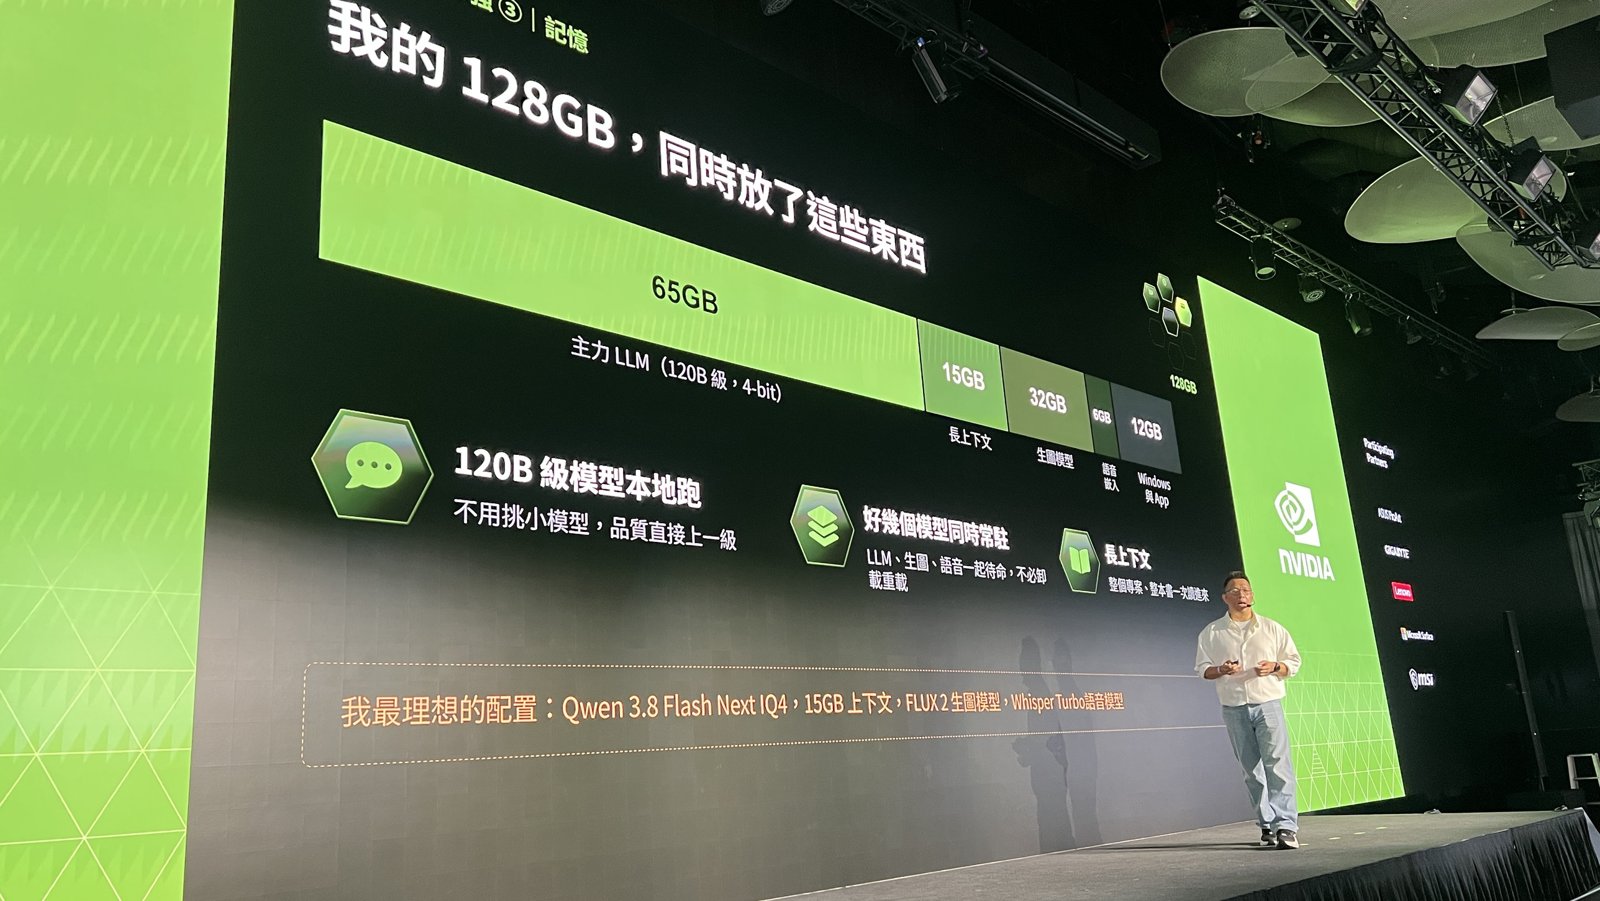
128GB 實際怎麼分配?台北場的講者分享了自己的配置:主力 LLM(120B 級、4-bit)佔 65GB、長上下文 15GB、生圖模型 32GB、語音與嵌入模型 6GB、Windows 與 App 12GB(以上為投影片標示的概略數字);講者心目中最理想的組合是 Qwen 3.8 Flash Next(IQ4)、15GB 上下文、FLUX 2 生圖模型與 Whisper Turbo 語音模型。這正是統一記憶體的價值:LLM、生圖、語音可以同時常駐,Agent 隨叫隨用,不必反覆卸載、重新載入模型。
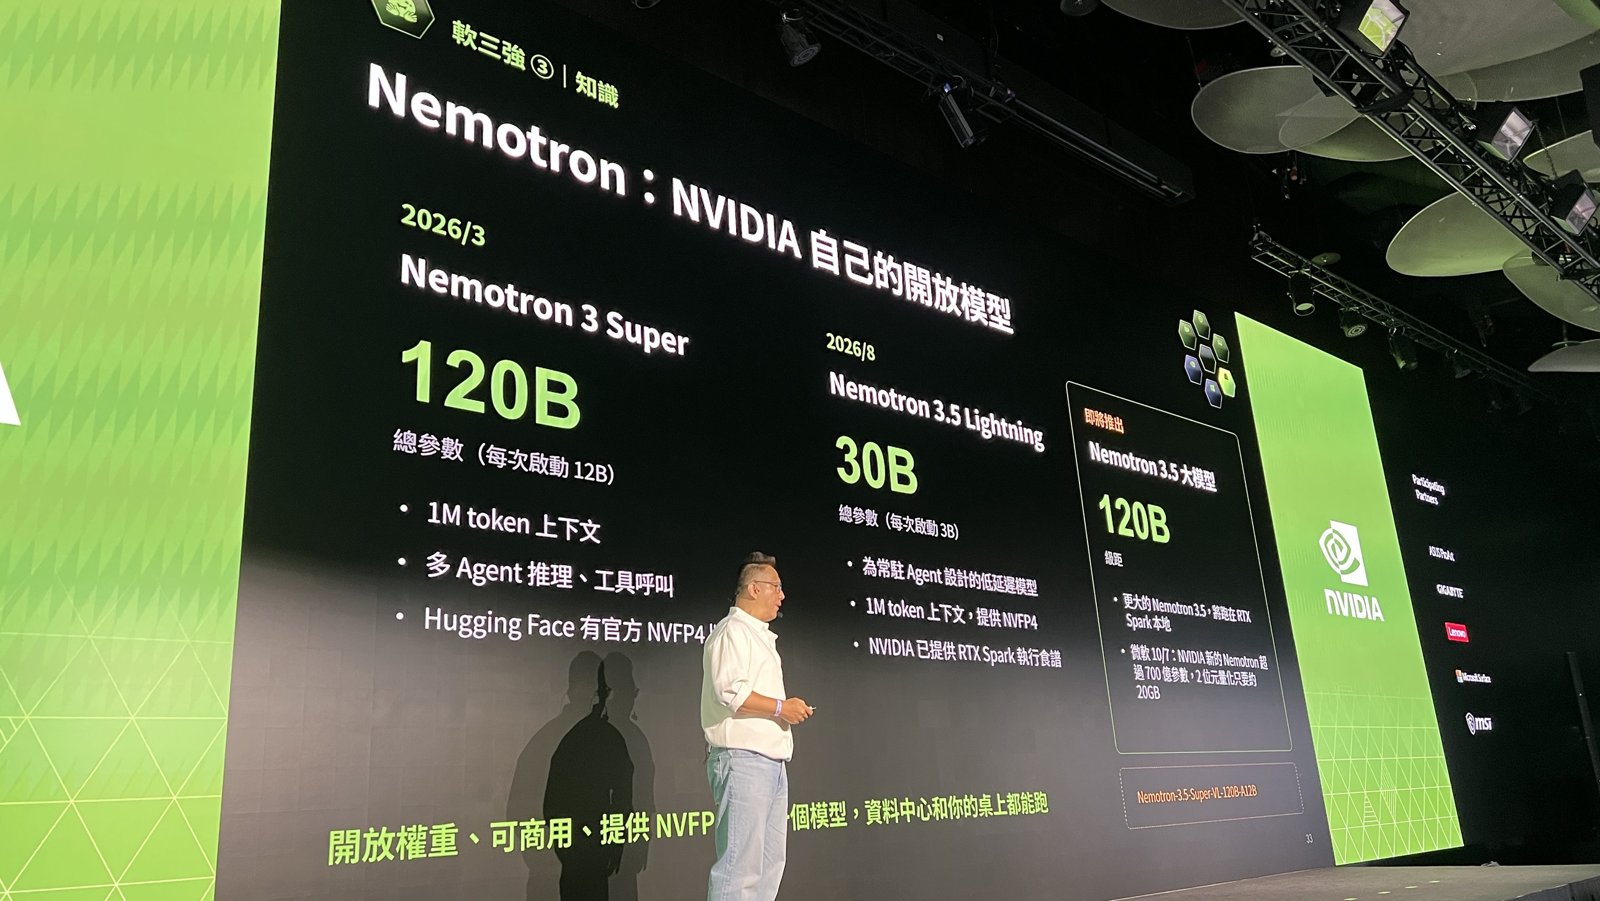
有了大記憶體,還要有適合的模型。NVIDIA 在台北場介紹了自家的開放模型 Nemotron 系列,三款都標榜開放權重、可商用、提供 NVFP4 版本:
| 模型 | 推出時間 | 參數規模 | 特色 | 適用情境 |
|---|---|---|---|---|
| Nemotron 3 Super | 2026 年 3 月 | 總參數 120B,每次啟動 12B | 1M token 上下文;Hugging Face 有官方 NVFP4 版本 | 多 Agent 推理、工具呼叫 |
| Nemotron 3.5 Lightning | 2026 年 8 月 | 總參數 30B,每次啟動 3B | 1M token 上下文、提供 NVFP4;NVIDIA 已提供 RTX Spark 執行食譜 | 常駐 Agent、低延遲回應 |
| Nemotron 3.5 大模型 | 即將推出 | 120B 級距 | NVIDIA 表示將能在 RTX Spark 本地執行 | 更高品質的本地 Agent |
這三款都是 MoE(混合專家)架構:總參數大、每次只啟動一小部分,正好對上 RTX Spark「容量大、頻寬普通」的特性——128GB 裝得下 120B 的總參數,而每個 token 只需讀取約 12B 的啟動參數,300 GB/s 的頻寬也就夠用。這也是前面 Artificial Analysis 測試中,RTX Spark 跑 MoE 模型(Qwen3.6 35B A3B 只要 7.6 分鐘)遠比跑 Dense 模型順的原因。投影片另外引述 Microsoft 10 月 7 日的說法:NVIDIA 新的 Nemotron 超過 700 億參數,2 位元量化後只需約 20GB。對企業來說,挑 RTX Spark 要搭 MoE 模型,才能發揮它的設計優勢;Qwen、DeepSeek、GLM 等開源模型的授權與選型,可參考中國開源大模型全盤點。
目前公開的實測數據還很少。Windows Central 用 UL Procyon 測 Surface Laptop Ultra 頂規機,Llama 3.1 8B 跑出每秒 49.4 個 token、Llama 2 13B 每秒 27.4 個 token;同一篇評測也提到,128GB 機型預設只分配 64GB 給 GPU 使用(Windows Central,2026)。70B 以上模型的實測 token 速度,截至 2026 年 10 月中,蓋斯克還沒有找到可信的公開數據。
中型模型則有一筆很關鍵的實測。中國科技媒體芯東西拿 ASUS ProArt P16(64GB)跑 AA-AgentPerf Local 智能體基準測試,使用 Qwen3.8-27B 本地模型完成整套任務耗時 25 分 09 秒,吐字速度約每秒 23 個 token,表現與 DGX Spark 相近(芯東西,知乎,2026)。這個數字和第二節依頻寬推算的理論上限(約 20 tok/s)落在同一個量級,證實 RTX Spark 跑 Dense 模型的速度確實由 300 GB/s 頻寬決定。
更完整的第三方數據來自 Artificial Analysis。Artificial Analysis 在 2026 年 10 月 15 日公布 AA-AgentPerf-Local 測試結果:把 8 個錄好的 Agent 任務(共 168 輪對話)在各機器的本地模型上重播,所有機器生成相同數量的 token,模型一律 4-bit,只比完成時間(Artificial Analysis,2026)。受測機是 15 吋、128GB 的 Surface Laptop Ultra 原型機。
| 模型 | RTX Spark 筆電 | DGX Spark | Ryzen AI Halo | MacBook Pro M5 Pro 64GB | RTX 5090 桌機 |
|---|---|---|---|---|---|
| Qwen3.8 27B(Dense) | 18.7 分 | 17.3 分 | 34.5 分 | 37.6 分 | 4.9 分 |
| Qwen3.6 35B A3B(MoE) | 7.6 分 | 7.3 分 | 11.7 分 | 11.9 分 | 2.0 分 |
| Ling 3.0 Flash 124B(MoE) | 15.3 分 | 14.9 分 | 25.1 分 | 裝不下 | 裝不下 |
這組數據修正了「頻寬低就一定慢」的直覺。Agent 工作每一輪都要讀進大量上下文(系統提示、工具結果、檔案內容),這個「讀題」階段(prefill)吃的是算力而不是頻寬,正是 RTX Spark 1 PFLOP 的強項,所以 RTX Spark 在 Qwen3.8 27B 上比 MacBook Pro M5 Pro 快 2 倍、在 124B 的 Ling 3.0 Flash 上更是 32GB 顯存的 RTX 5090 根本裝不下的模型。X 上的 @TheAhmadOsman 也測過類似現象:兩台 DGX Spark 跑 DeepSeek V4 Flash,讀題速度比 Mac Studio M5 Ultra 快 2.41 倍,但吐字速度反而慢 6.4%(來源)。結論是:長篇吐字看頻寬,Mac 佔優;Agent 與長上下文看算力,RTX Spark 與 DGX Spark 佔優。只跑 30B 以內的模型、不在乎攜帶,RTX 5090 桌機快將近 4 倍。
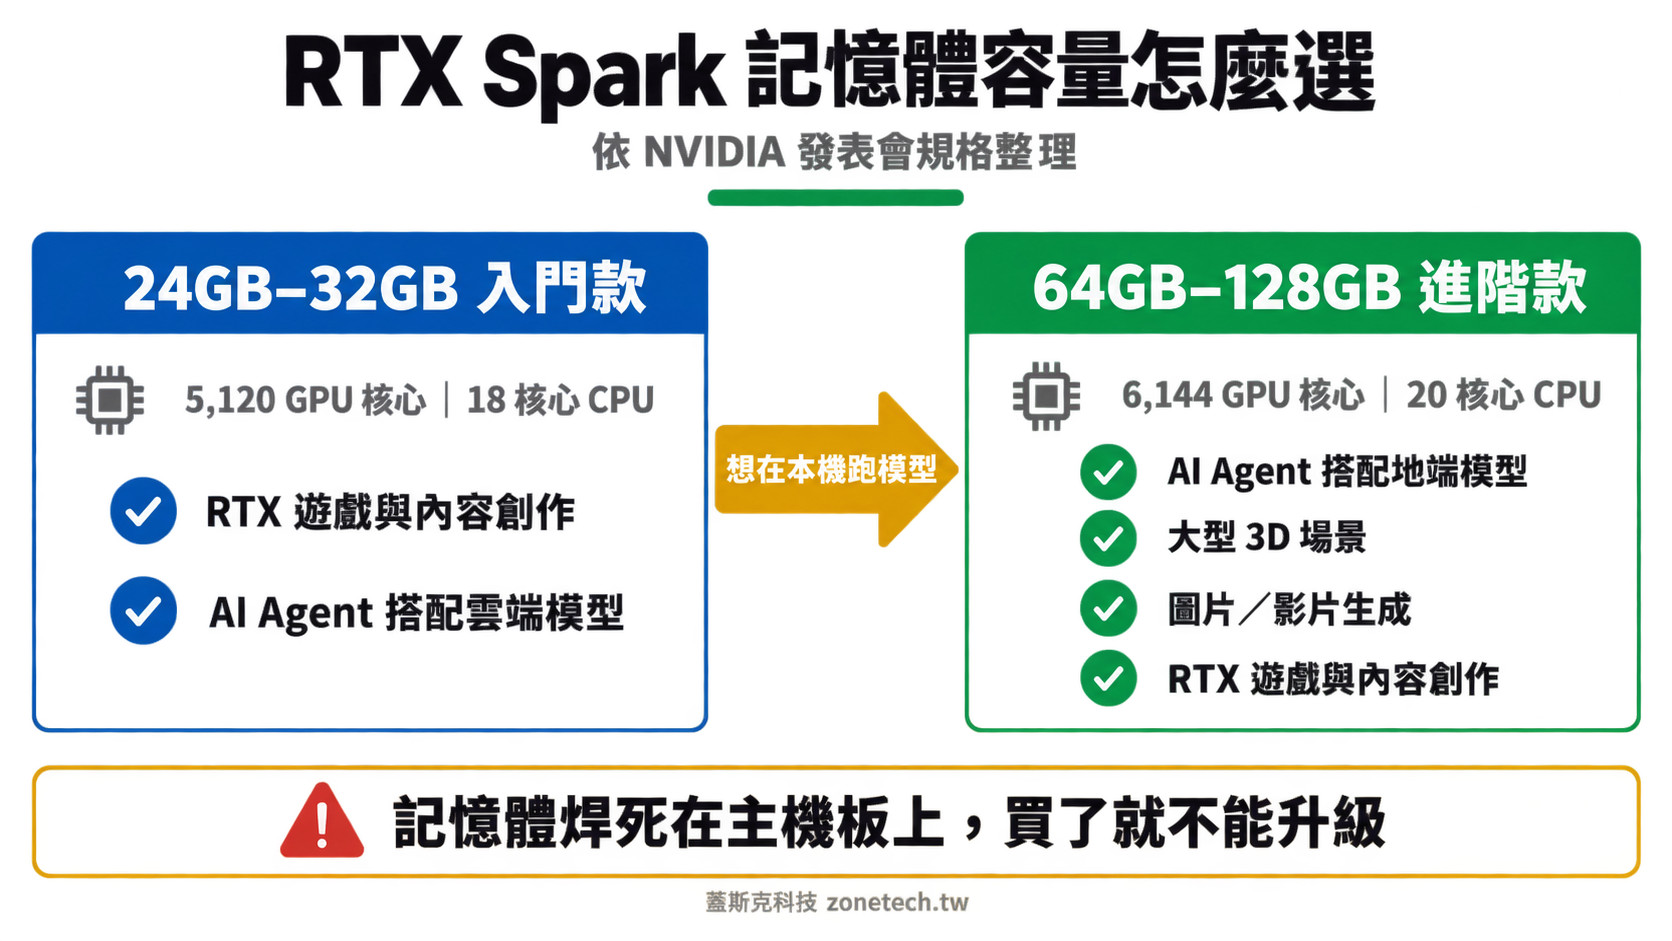
RTX Spark 記憶體容量的選擇,NVIDIA 在「Choose Your Spark」投影片上分得很清楚:24GB~32GB 入門款定位為「遊戲與內容創作、Agent 搭配雲端模型」,64GB~128GB 進階款才是「Agent 搭配地端模型、大型 3D 場景、圖片與影片生成」。換句話說,想在本機跑模型,最少要買 64GB,建議直接上 128GB。
| 模型類型 | RTX Spark 128GB 裝得下嗎 | 速度預期 | 適用情境 |
|---|---|---|---|
| 7B~14B 小模型 | 輕鬆 | 實測 27~49 tok/s(Procyon) | 個人助理、程式補全、離線翻譯 |
| 27B~32B Dense(如 Qwen3.8-27B) | 可以 | 實測約 23 tok/s(芯東西,AA-AgentPerf Local) | Agent、文件分析 |
| 百億級 MoE(如 Ling 3.0 Flash 124B、Qwen3.8-Flash-Next) | 可以(Ling 3.0 Flash 權重約 77GB) | AA Agent 測試 15.3 分完成,與 DGX Spark 相近 | 隨身 Agent、長上下文工作 |
| 70B 以上 Dense | 4-bit 勉強裝得下 | 預期偏慢,尚無可信實測 | 不建議當主力 |
Qwen3.8-27B 的尺寸選擇、量化與商用授權細節,可以參考 Qwen3.8-27B 地端部署完全指南。如果你要評估的是整套企業內部 AI(多人共用、資料不出公司、權限與稽核),單一台筆電只是起點,完整架構請看 地端 LLM 建置完整指南。
六、X、Reddit、PTT、知乎怎麼看 RTX Spark?
社群普遍認為 RTX Spark 是 Windows 陣營第一個像樣的 Apple Silicon 對手,但價格、頻寬與 Windows on Arm 相容性是三大疑慮。蓋斯克整理了上市首週 X、Reddit、PTT 與知乎上的代表性討論(以下為摘要轉述,連結為原討論串)。
正面評價:CUDA+長續航+大記憶體,目前獨一份
- X @shiri_shh(3 萬讚、720 萬次瀏覽):Computex 發表當天最熱門的貼文,稱「筆電 30 年沒變,NVIDIA 改變了它」,AI Agent 可以 24 小時住在本機、不靠雲端(來源)。
- X @TeksEdge:128GB 的 Surface 頂規機開賣後最先售罄,DGX Spark 也一機難求,NVIDIA 把漲價歸因於全球記憶體供應吃緊(來源)。
- X @xiax0603:Microsoft 在發表會現場用 Surface Laptop Ultra 本機跑 DeepSeek V4 Flash(2,840 億參數,1.6-bit 量化後約 60GB)(來源)。
- Reddit r/technology:同規格比較,RTX Spark 筆電比 MacBook 便宜 1,000~2,000 美元(來源)。
- Reddit r/laptops:拔掉電源效能不會掉,統一記憶體可以直接當 VRAM 用(來源)。
- Reddit r/nvidia:反作弊(anti-cheat)支援已經贏過 Linux 和過去的 Windows on Arm(來源)。
- 知乎:CUDA、Arm 架構的續航與 128GB 記憶體三者兼具,目前市場上沒有第二個選擇(來源)。
- 知乎答主「AI 解碼師」(139 贊):別拿 RTX Spark 跟 RTX 5090 比幀數,它要解決的是「筆電能不能在斷網時養一個本地 AI Agent」這件過去做不到的事(來源)。
- 知乎專欄作者「楠爺」:實際把團隊工作搬到 RTX Spark 上用 Agent 處理後認為,地端模型和雲端 API 應該依任務搭配使用,重點是讓習慣 Windows 的同事帶著既有檔案和業務軟體直接上手(來源)。
- 實測續航:HotHardware 測 Surface Laptop Ultra 影片播放 14 小時 35 分、網頁瀏覽 10 小時 15 分,但遊戲只有 1 小時 38 分(HotHardware,2026)。
疑慮一:頻寬不夠,跑大模型不如 Mac
- Reddit r/LocalLLaMA(360 讚):發文〈RTX Spark does not have 600GB/s Bandwidth〉,直指所有報導 600 GB/s 的媒體都寫錯了,那是 NVLink 的速度(來源)。
- X @TeksEdge:最大弱點就是頻寬,DGX Spark 273、Strix Halo 約 256、RTX Spark 約 300,而 M5 Max 是 614 GB/s(來源)。
- Reddit r/ARMWindows:一位 DGX Spark 用戶認為 300 GB/s 只比 GB10 好一點,同價位不如買 M5 Max(來源)。
- PTT PC_Shopping:「64GB 不上不下,MoE 塞不下、Dense 又跑太慢」「DGX 買兩台還能串,這個不行」(來源)。
疑慮二:價格與 Windows on Arm 相容性
- X @lafaiel:實測遊戲效能約 RTX 3060 等級,「US$2,599 的筆電打輸 US$1,200 的筆電,很難說服玩家」;Blender CPU 測試比 M5 Pro 慢,但大幅領先 x86 筆電(來源)。
- Reddit r/laptops(1,006 讚):Microsoft 推出「和 Apple 分手」方案,MacBook Pro 用戶換購 RTX Spark 筆電最高折抵 US$1,000,引發熱烈討論(來源)。
- Reddit r/nvidia:24GB/32GB 入門款不合理,US$2,600 只給 512GB SSD(來源)。
- PTT PC_Shopping:之前用 Windows on Arm 玩《世紀帝國 4》卡在 AVX 指令集不能玩;全機焊死,除了 SSD 都不能升級。
- TechTimes 評測彙整:GPU 同級最強,但 CPU 是 2024 年的核心設計;《決勝時刻》要到 2027 年才支援;token 生成速度比 M4 Max 慢(TechTimes,2026)。
- 知乎答主「牛肉丸夫斯基」(78 贊):把 RTX Spark 稱為「集所有統一記憶體 AI 電腦缺陷於一身」——DGX Spark 有成熟 Linux 與 CUDA 工具鏈、AMD AI Max 395 便宜、Mac 頻寬遙遙領先,而 Arm 架構的 Windows 11 在命令列與開發工具上還有很長的路要走(來源)。
- 知乎答主「雷諾Renault 紫毛」(232 贊):N1X 和 DGX Spark 的 GB10 是同一顆晶片、晚了一年多才上市;300 GB/s 頻寬「能塞大模型但速度太慢」,80W 功耗上限也讓 GPU 吃不飽,AMD Strix Halo 雖然軟體較弱,價格卻只要三分之一(來源)。
- 知乎答主「泡沫藝術家」(480 贊,該題最高讚):如果早一年發布會是神器,現在定位尷尬——記憶體漲價讓大記憶體筆電便宜不了,而 DeepSeek V4 Pro 等雲端 API 已經便宜到每百萬 token 只要幾塊人民幣,單純為了省 API 費用而買地端硬體越來越難回本(來源)。
- 知乎:第一批買家大概率會當白老鼠,統一記憶體的速度也比不上獨立顯存。
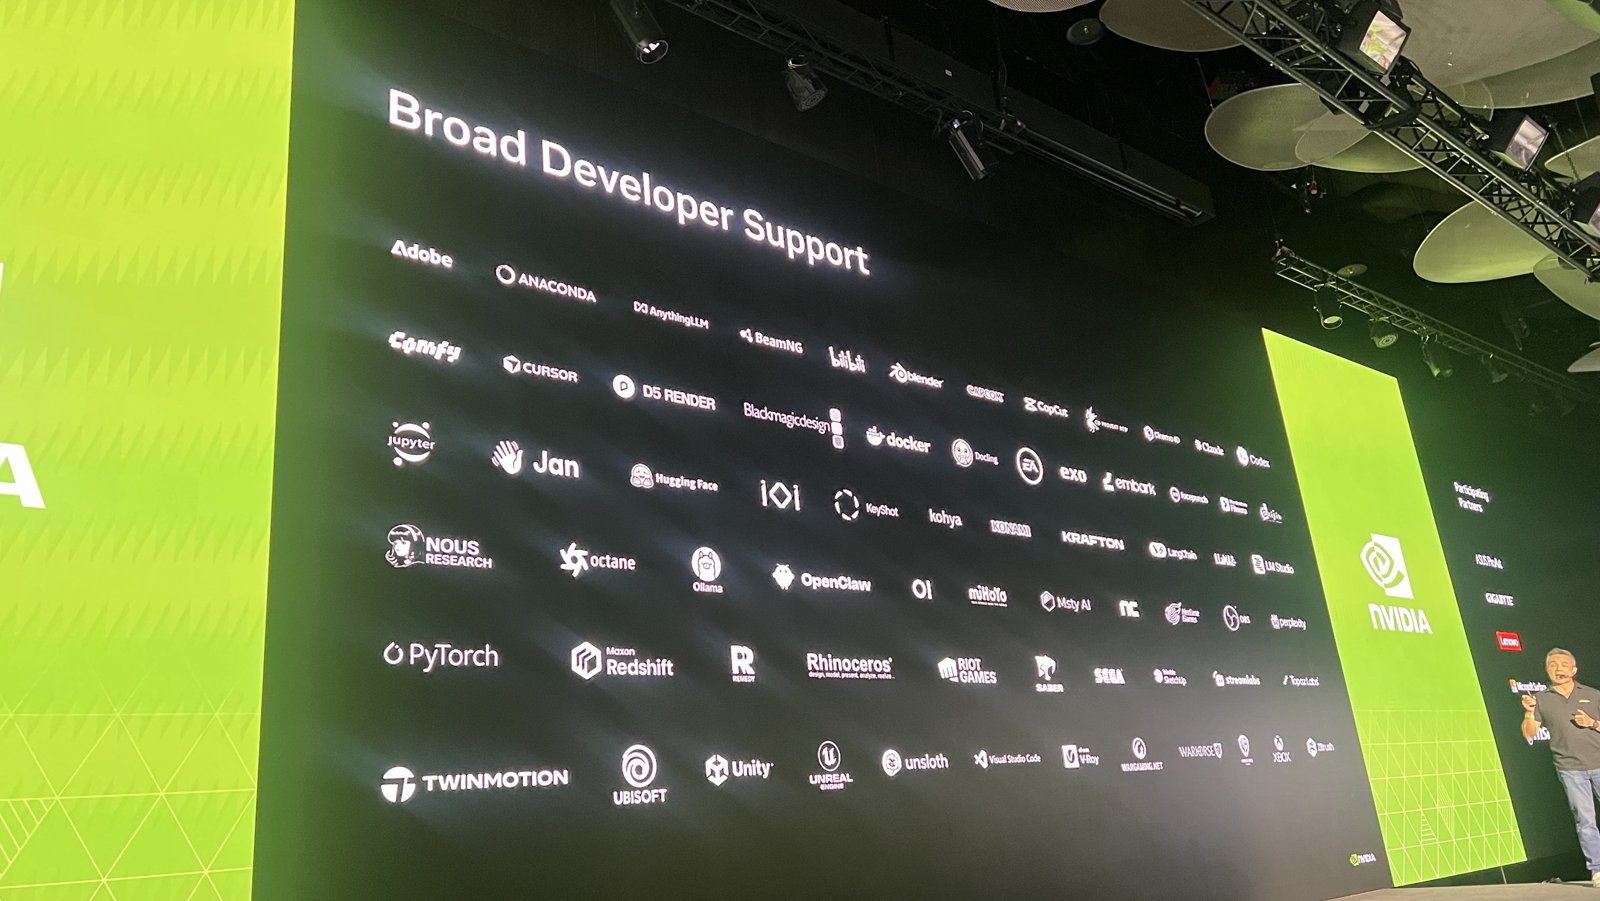
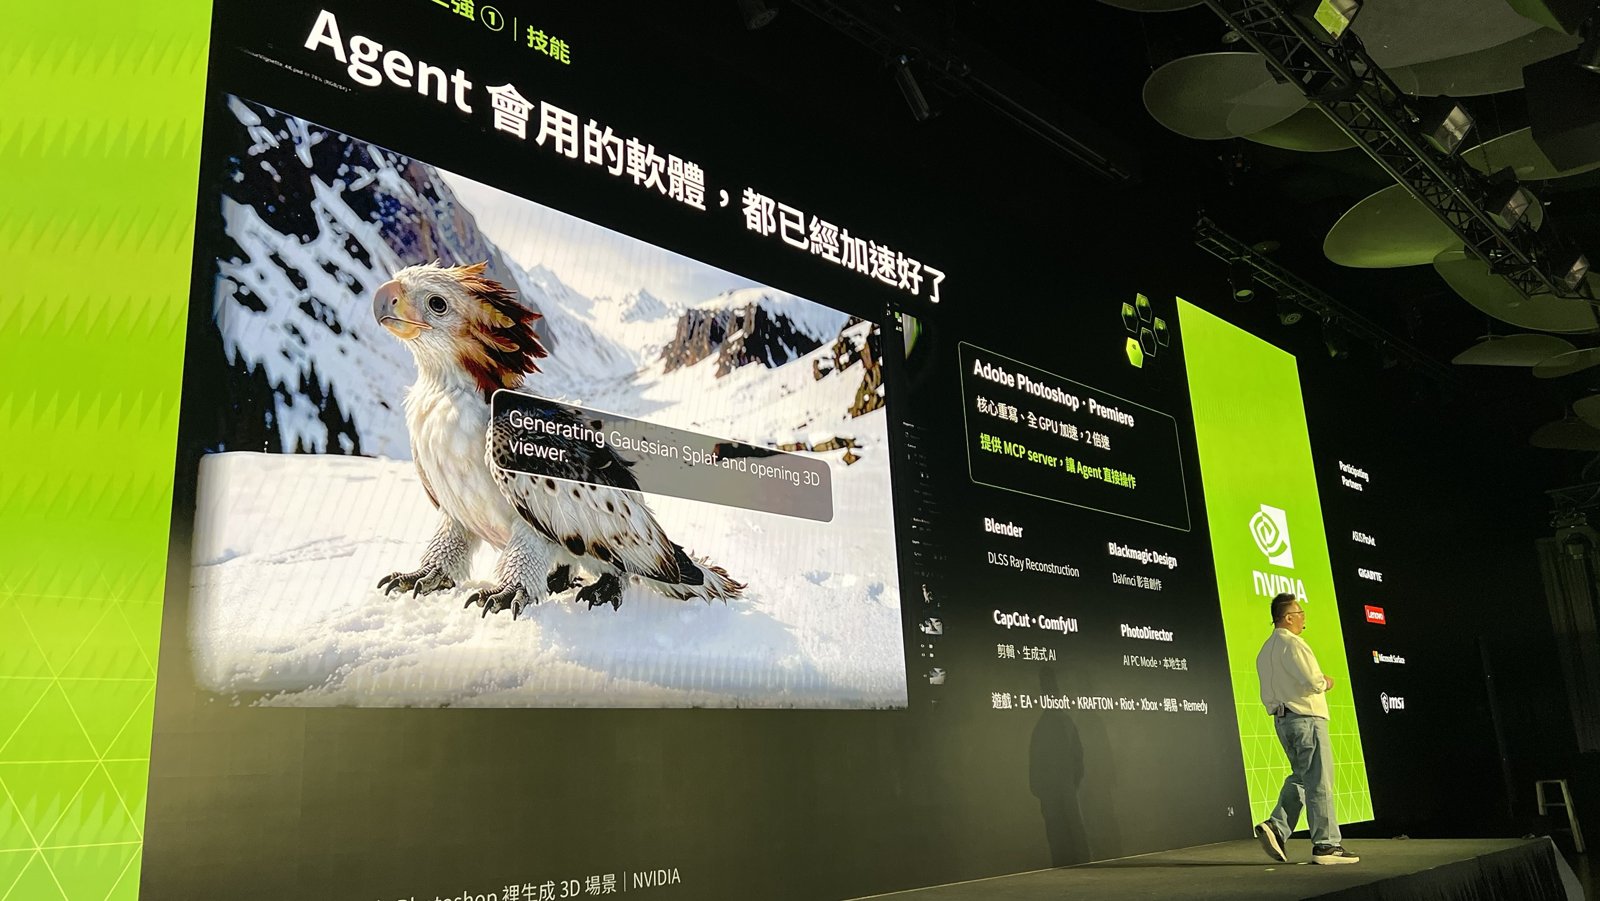
軟體支援方面,NVIDIA 在台北場特別點名 Adobe:Photoshop 與 Premiere 為 RTX Spark 重寫核心、全面 GPU 加速,官方宣稱速度 2 倍,而且提供 MCP server,讓 AI Agent 可以直接操作 Photoshop 與 Premiere。Blender、DaVinci Resolve、CapCut、ComfyUI、PhotoDirector 也已完成加速。
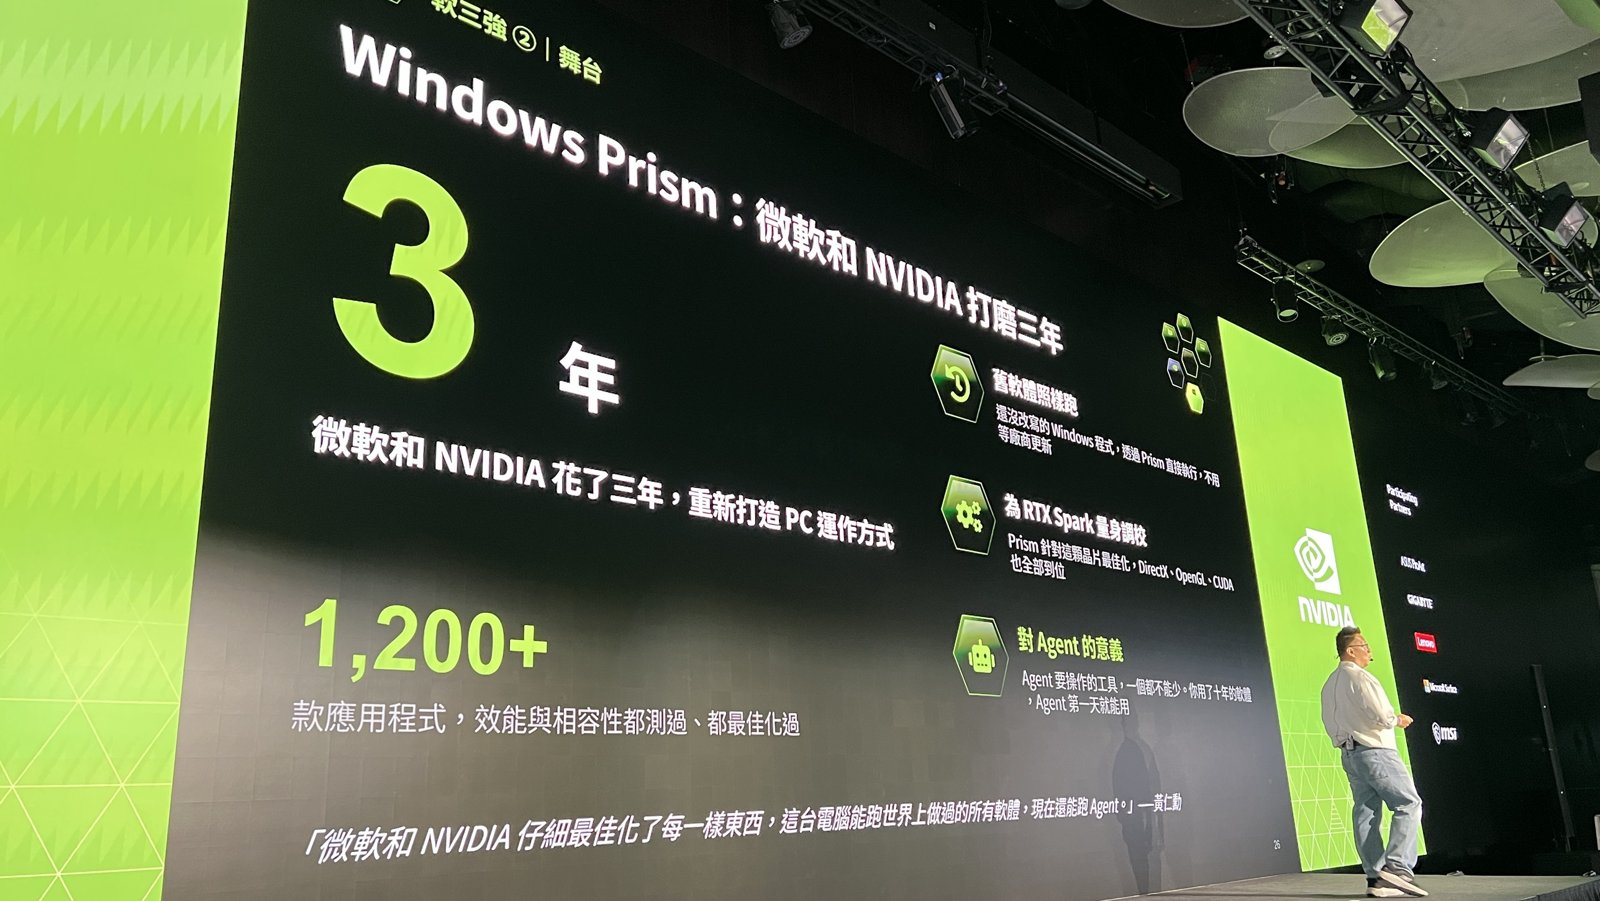
Windows on Arm 最大的疑慮是舊軟體相容性。Microsoft 與 NVIDIA 的答案是 Prism 轉譯層:還沒改寫成 Arm 版的 Windows 程式,透過 Prism 直接執行;Prism 也針對 RTX Spark 調校,DirectX、OpenGL、CUDA 都已到位。台北場投影片寫明,兩家公司花了 3 年重新打造 PC 的運作方式,已有超過 1,200 款應用程式完成效能與相容性測試。NVIDIA 執行長黃仁勳的說法是:
「微軟和 NVIDIA 仔細最佳化了每一樣東西,這台電腦能跑世界上做過的所有軟體,現在還能跑 Agent。」——NVIDIA 執行長 黃仁勳(RTX Spark 台北場活動投影片引述)
不過,原廠宣稱「能跑所有軟體」與社群實測之間仍有落差,下一段的相容性問題就是例子。
Windows Central 實測指出,大多數主流反作弊系統已經支援 RTX Spark;《碧血狂殺 2》預設用 Vulkan 會閃退,改成 DX12 就能正常執行(Windows Central,2026)。企業採購前,務必把內部要用的軟體(ERP 用戶端、VPN、資安代理程式、印表機驅動)列成清單逐一驗證 Arm 版本,這是 Windows on Arm 最容易踩雷的地方。
七、企業採購 RTX Spark 最常犯的 5 個錯誤
企業買 RTX Spark 最大的錯誤,是把它當成「可以多人共用的 AI 伺服器」。RTX Spark 是個人工作站,不是團隊伺服器。下表整理蓋斯克在地端 AI 諮詢中最常被問到的誤解:
| 症狀 | 常見原因 | 解決方向 | 蓋斯克怎麼做 |
|---|---|---|---|
| 買了 128GB,跑 70B 模型還是慢 | 記憶體頻寬只有約 300 GB/s,Dense 大模型受限於頻寬 | 改用 MoE 模型或縮小模型 | 先依實際模型估算 tok/s 再決定機種 |
| 買了 24GB 入門款,本機跑不動模型 | NVIDIA 官方定位入門款是「Agent 搭配雲端模型」 | 要跑地端模型最少 64GB | 採購前依模型大小算記憶體需求 |
| 全公司 10 個人連一台 RTX Spark 很卡 | 單機推論吞吐量有限,筆電也不適合 24 小時開機服務 | 改用 DGX Spark 或 GPU 伺服器 | 依同時使用人數規劃推論主機與網路 |
| 公司內部軟體裝不起來 | Windows on Arm 缺 x86 原生版本或需要 AVX 指令 | 採購前做軟體相容性清單 | 導入前協助盤點與試機 |
| 以為之後可以加記憶體 | 統一記憶體焊死在主機板上 | 一次買足容量 | 依 2~3 年需求估算容量 |
八、企業該不該導入 RTX Spark?蓋斯克的判斷流程
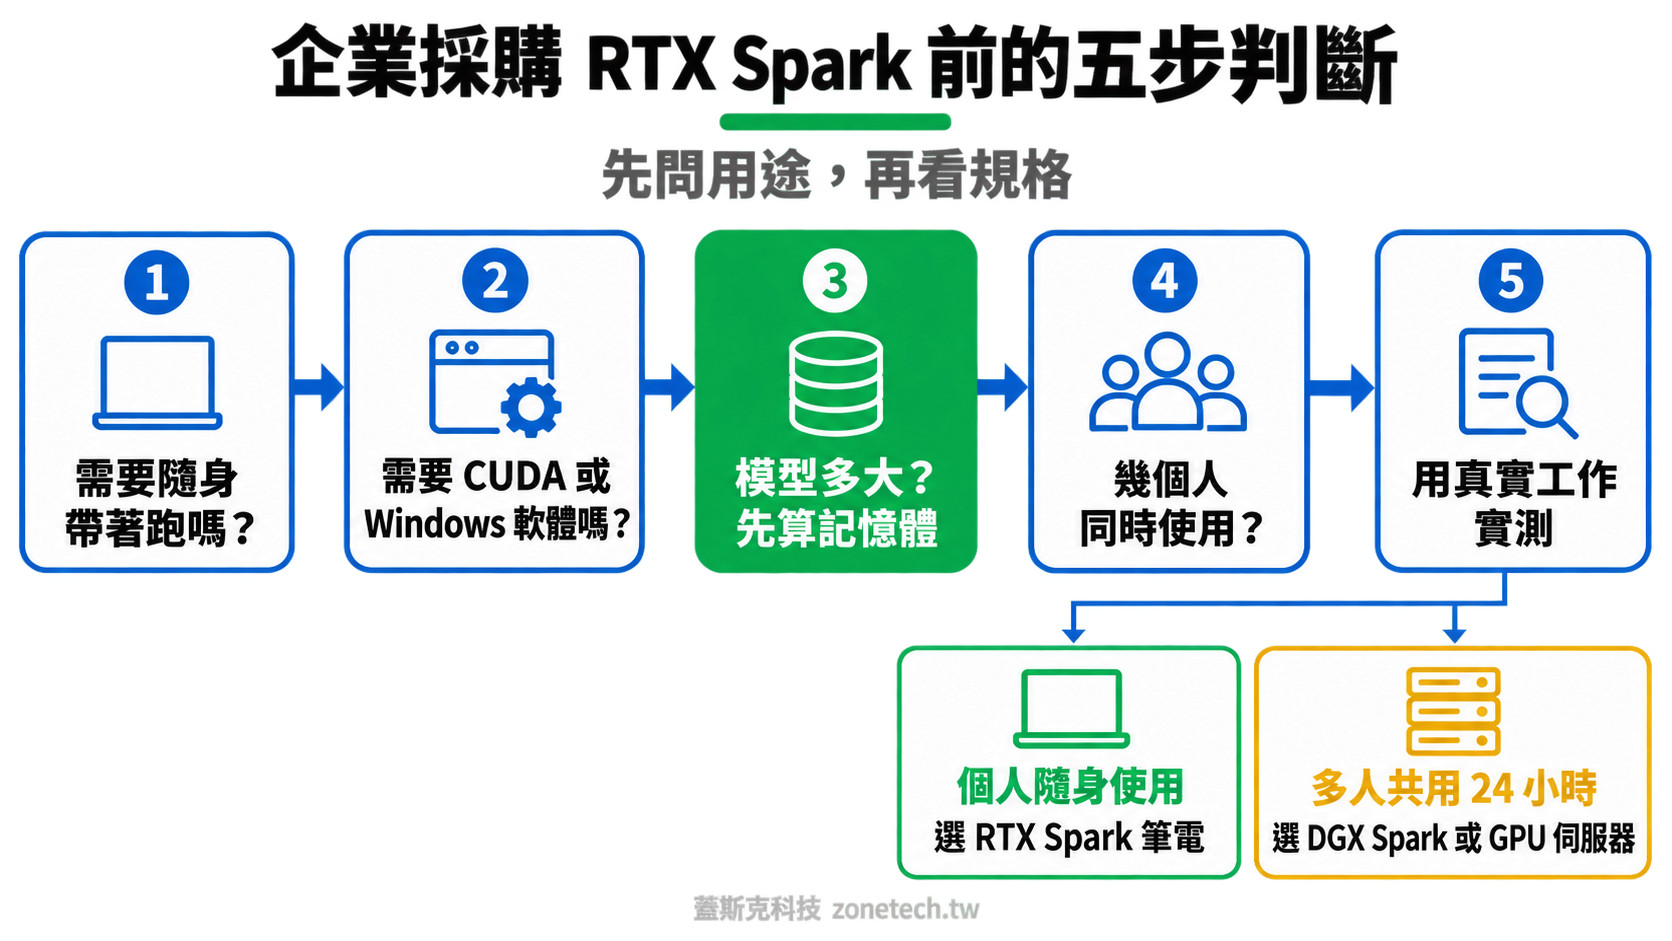
企業評估 RTX Spark 要先問用途,再看規格:個人隨身用選 RTX Spark,多人共用 24 小時服務選 DGX Spark 或 GPU 伺服器。蓋斯克科技協助企業規劃地端 AI 時,會依下面五個步驟判斷:
- 需要隨身帶著跑嗎?要到客戶端 Demo、出差開發,筆電形態才有價值;固定在辦公室用,桌機或伺服器更划算。
- 需要 CUDA 或 Windows 軟體嗎?工作流程綁 CUDA(PyTorch 訓練、TensorRT 部署)或 Windows 專業軟體,RTX Spark 比 Mac 合適。
- 模型多大?先算記憶體。依模型參數與量化方式估算所需容量,再加上長上下文的 KV Cache 空間。
- 幾個人同時使用?超過 3~5 人同時呼叫模型,就該考慮專用推論主機,而不是每人一台筆電。
- 用真實工作實測。拿公司實際文件、實際 Prompt 跑一輪,量測吐字速度與回應時間後再採購。
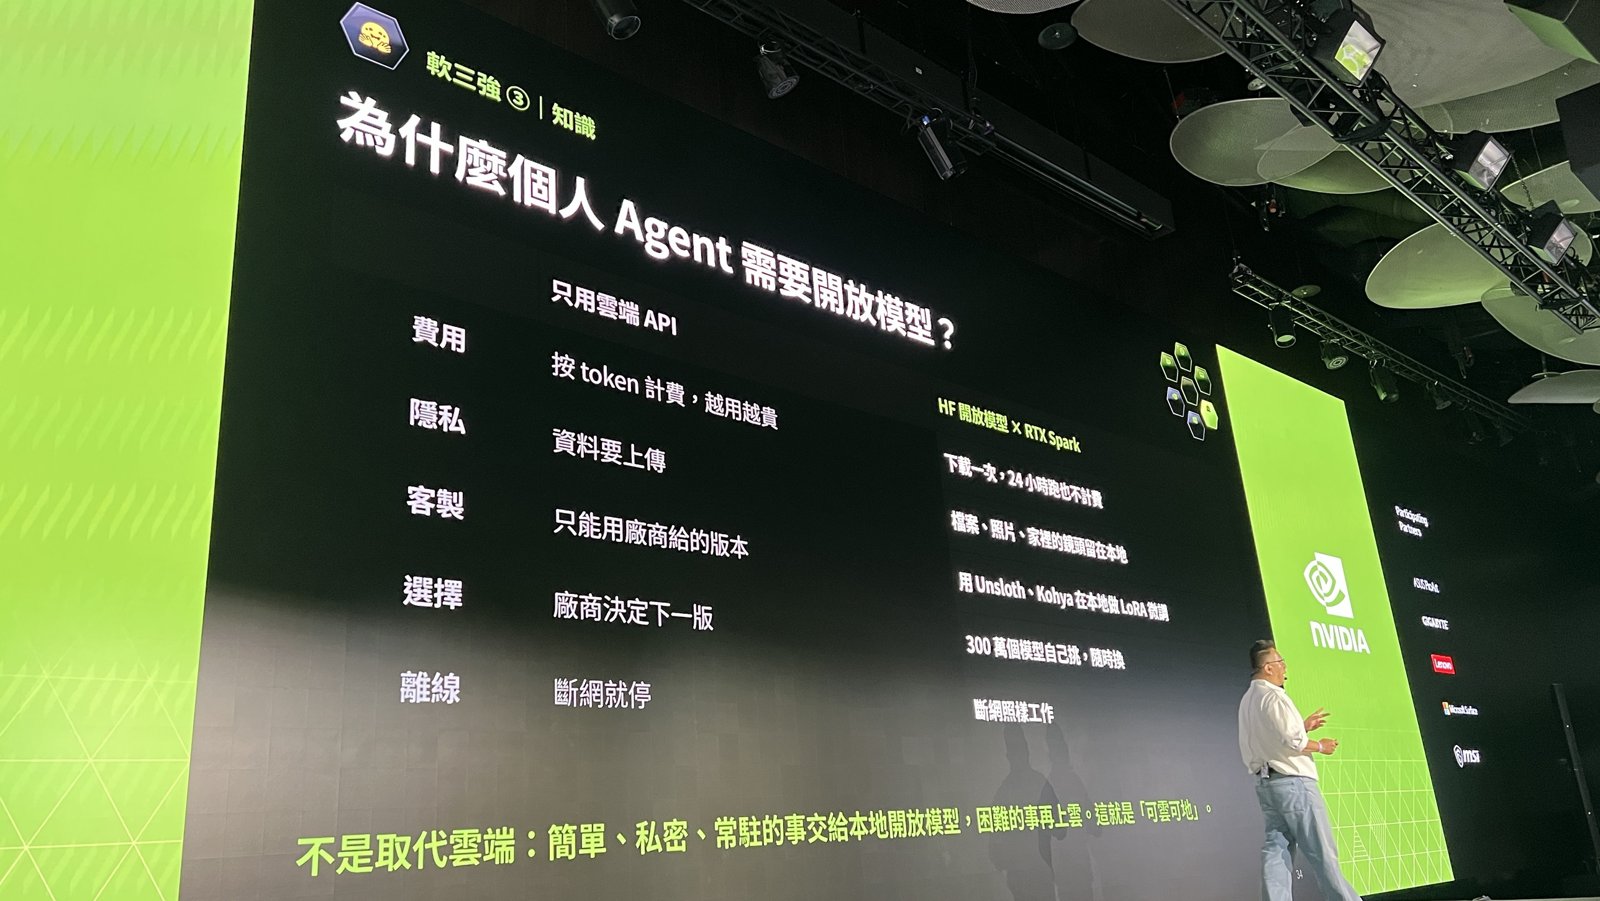
五個步驟之前,還有一個更根本的問題:地端的理由夠不夠充分?NVIDIA 在台北場用一張表比較「只用雲端 API」與「Hugging Face 開放模型+RTX Spark」:
| 比較面向 | 只用雲端 API | 開放模型+RTX Spark 本地執行 |
|---|---|---|
| 費用 | 按 token 計費,越用越貴 | 下載一次,24 小時跑也不計費 |
| 隱私 | 資料要上傳 | 檔案、照片、監控畫面留在本地 |
| 客製 | 只能用廠商給的版本 | 用 Unsloth、Kohya 在本地做 LoRA 微調 |
| 選擇 | 廠商決定下一版 | Hugging Face 上 300 萬個模型自己挑、隨時換 |
| 離線 | 斷網就停 | 斷網照樣工作 |
值得注意的是,NVIDIA 自己的結論並不是「取代雲端」,而是「簡單、私密、常駐的事交給本地開放模型,困難的事再上雲」,NVIDIA 稱為「可雲可地」。這和蓋斯克對企業的建議一致:雲端 API 價格持續下降,知乎上最高讚的評論也指出,單純為了省 API 費用,地端硬體越來越難回本;資料不能出公司、需要離線運作、要符合法規稽核,或是需要 24 小時常駐的 Agent,才是導入地端 AI 的主要理由。地端與雲端的完整取捨,可參考地端 LLM 建置完整指南。
當使用人數變多、需要權限控管與資料不外流時,問題就從「買哪台機器」變成「怎麼建一套企業內部 AI 基礎建設」,包含推論主機、網路隔離、防火牆與帳號權限。這部分可以參考 AI 防火牆怎麼建置;若想直接評估自家環境,歡迎透過蓋斯克地端 AI 導入諮詢,把模型、使用人數與預算告訴我們。
九、結論:RTX Spark 是全能隨身機,不是更便宜的 AI 伺服器
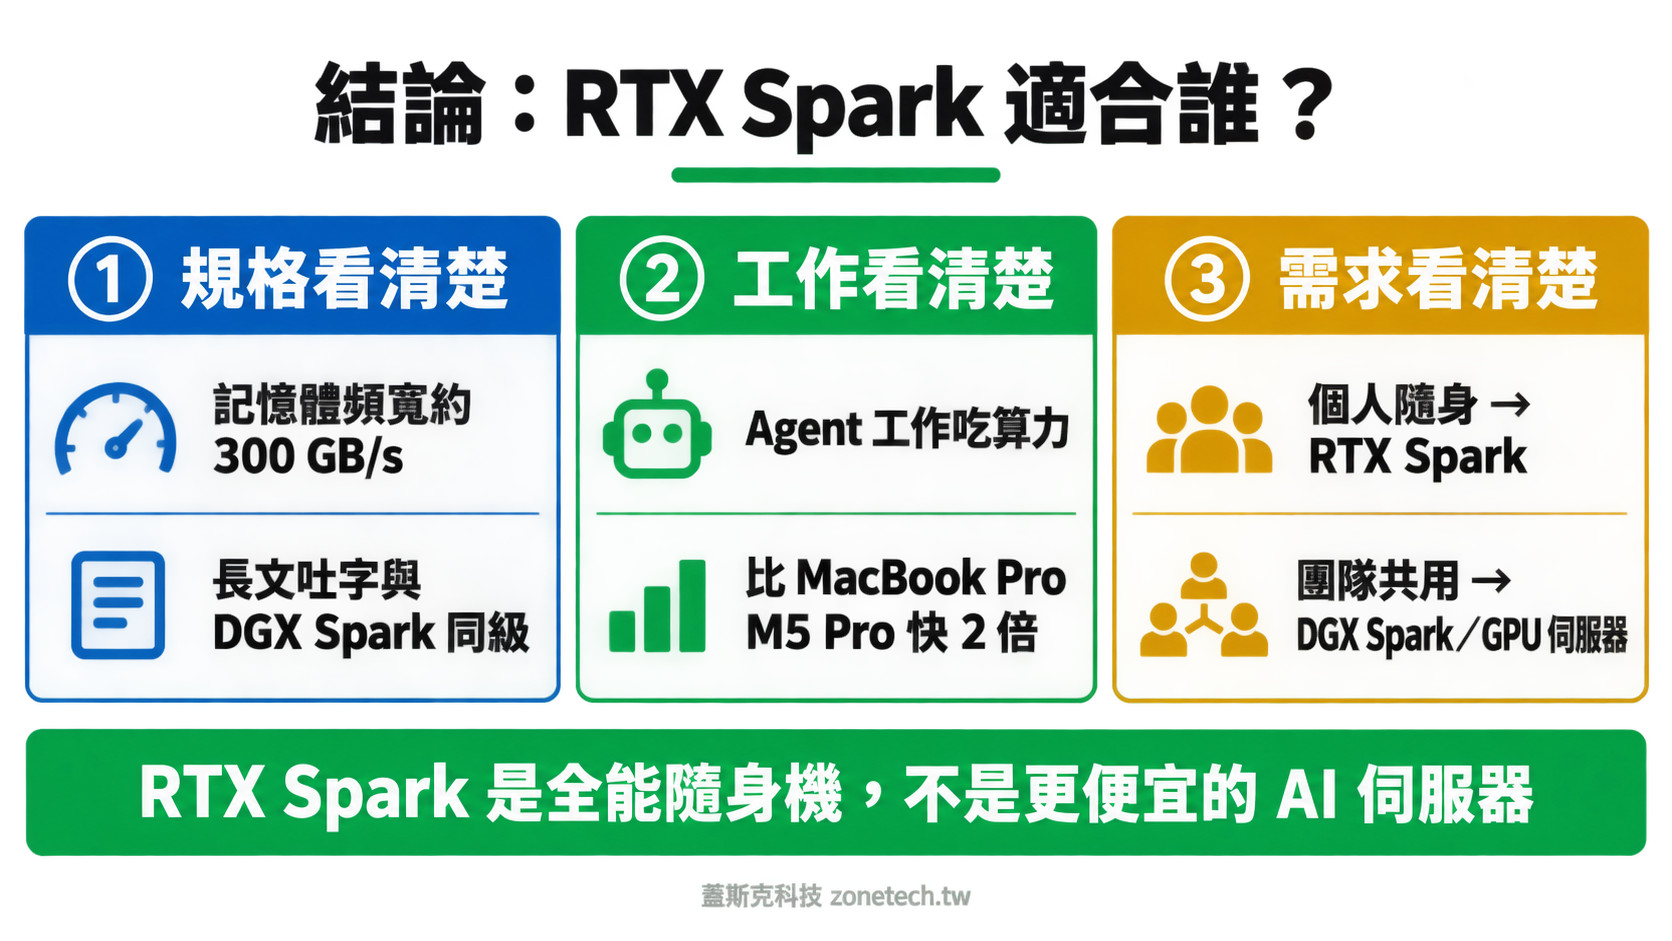
- 規格看清楚:600 GB/s 是 NVLink-C2C 互連,記憶體頻寬最高約 300 GB/s,跑大模型速度與 DGX Spark 同級。
- 定位看清楚:RTX Spark 的獨特價值是「Windows+CUDA+128GB+筆電續航」四者合一,適合個人隨身的 AI 開發、創作與展示。
- 需求看清楚:團隊共用、24 小時服務選 DGX Spark 或 GPU 伺服器;只追求單機最大模型與吐字速度,Mac Studio M5 Ultra 更合適。
立即開始:你的地端 AI 主機選型值得一份專業評估
蓋斯克科技協助企業規劃地端 AI 主機與內部網路架構,從單機 DGX Spark 到多卡 GPU 伺服器,都會先依實際模型與使用人數做評估,再給採購建議。
我們提供:
- 機種選型建議(依你的模型、使用人數與預算量身評估)
- 記憶體、頻寬與吐字速度試算,含 2026 年台灣市場報價或估算假設
- 透明報價,無隱藏費用
- 網路隔離、防火牆與帳號權限一併規劃
RTX Spark、DGX Spark、Mac Studio 還是 GPU 伺服器,哪一台適合你們?
蓋斯克科技專注台灣中小企業 IT 與地端 AI 基礎建設,先聽需求、再給建議,不推銷用不到的硬體。
預約地端 AI 選型諮詢 免費預約諮詢電話:02-2717-1019 LINE:@zonetech
關於作者
Gask Hung|蓋斯克科技創辦人暨執行長,專注台灣中小企業 IT:企業 Wi-Fi、IT 委外、地端 AI 與工業無線網路。完整作者介紹
延伸閱讀:地端 LLM 主機大車拼:DGX Spark vs Mac M5 Max vs Strix Halo vs RTX 5090|Mac Studio M5 Max/M5 Ultra 跑地端 LLM 實測整理|地端 LLM 建置完整指南
參考資料:NVIDIA 新聞稿|NVIDIA RTX Spark 官網|Windows Central 評測|原價屋 RTX Spark 專頁|聯合新聞網|Artificial Analysis AA-AgentPerf-Local|芯東西真機上手(知乎)|Apple Mac Studio 規格|NVIDIA DGX Spark 官網