所有 DGX Spark 的單串效能評測都漏了同一件事:這台機器跑單一對話的速度不算快,但一旦你把並行連線數拉到 256,吞吐量比單串測試高出 120 倍。大多數評測文章給你的數字是用來刷社群媒體的,不是你在生產環境應該在乎的指標。
這篇解釋 DGX Spark 的算力設計邏輯、並發場景的真實效能,以及什麼工作負載才能讓 1 petaFLOP 的算力有意義。
這篇適合誰看
- 企業在評估 DGX Spark 作為內部 AI API 伺服器
- 開發者在設計多 agent 系統,需要了解並發上限
- 看到單串評測數字後覺得「這不快啊」的人
- 想了解 DGX Spark 的 1 petaFLOP 在什麼情境下才會展現
為什麼單串評測無法代表 DGX Spark 真實效能
LLM 推論有兩個不同的效能指標:
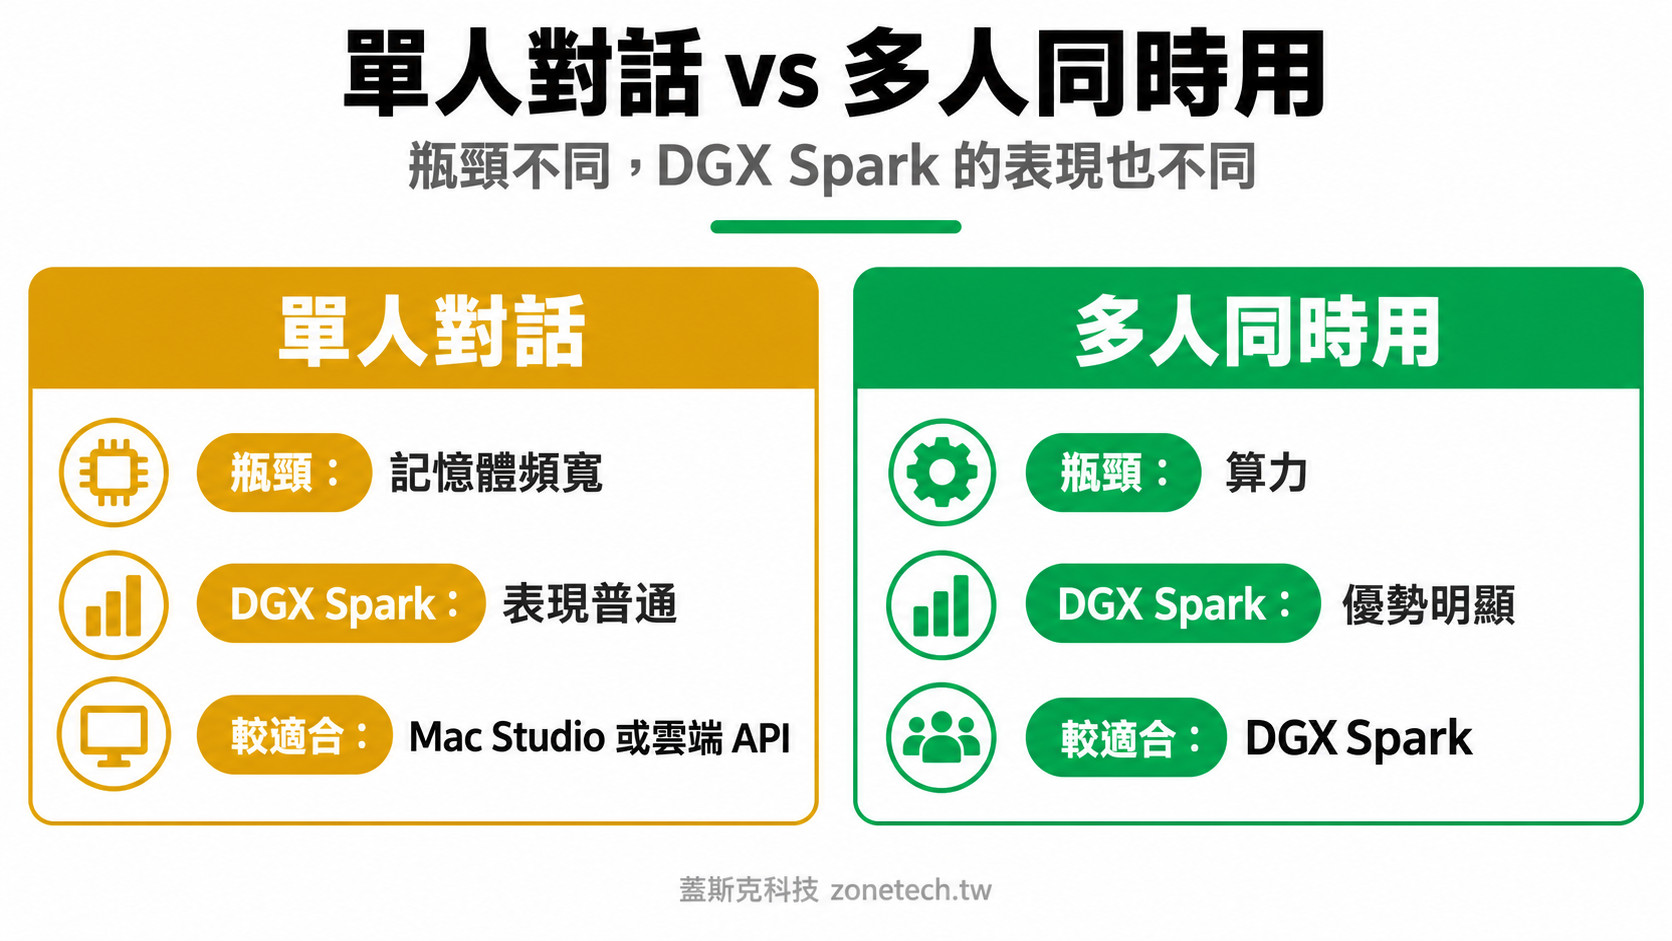
- Token 生成速度(decode):記憶體頻寬決定,DGX Spark 273 GB/s,這裡不是優勢
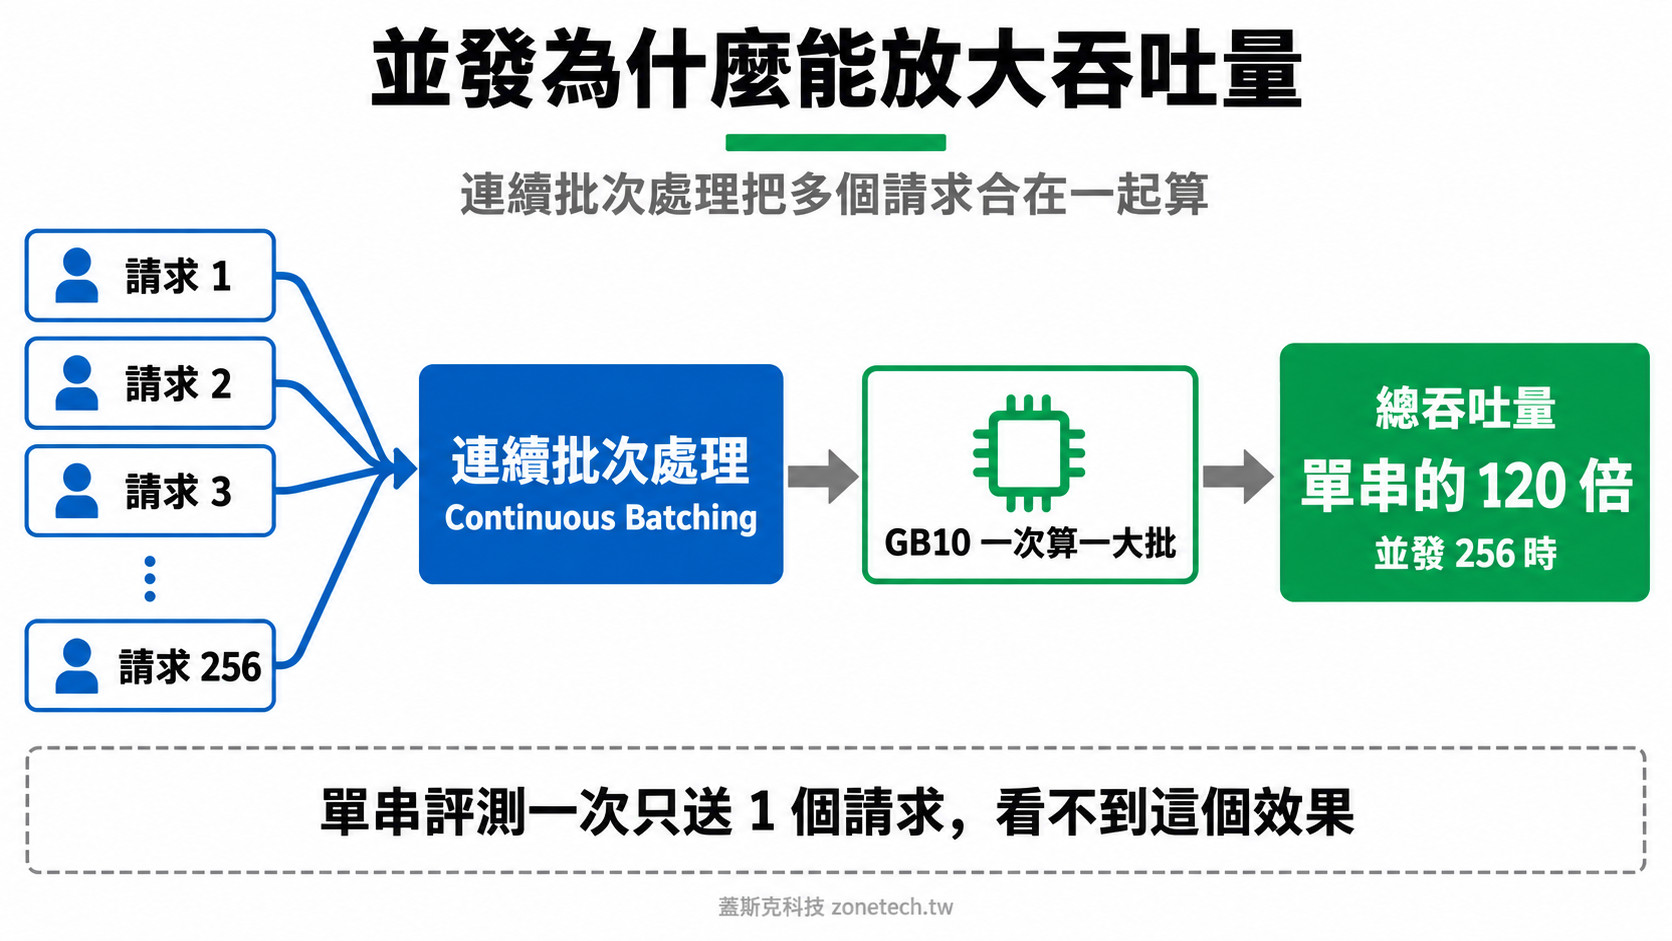
- 吞吐量(throughput):1 petaFLOP FP4 算力展現,多請求並行批次處理,這是 DGX Spark 的設計重點
大多數評測只測第一個,因為這個指標容易測、數字直覺、好寫文章。但第二個才是企業部署時真正關心的。
Dendro Logic 的 DGX Spark 並發 benchmark 顯示:在 concurrency 256(256 個同時進行的推論請求)下,總吞吐量(tokens/second)比單串測試高出 120 倍。原因是推論框架的 continuous batching 可以把 256 個請求的計算合併成一個大批次,讓 1 petaFLOP 的算力完全發揮。資料來源:Dendro Logic NVIDIA DGX Spark Concurrency Benchmark。
算力 vs 頻寬:哪個是你的瓶頸
| 場景 | 決定因素 | DGX Spark 表現 | Mac Studio 表現 |
|---|---|---|---|
| 單個對話(低並發) | 記憶體頻寬 | 中等(273 GB/s) | 優秀(M3 Ultra 為 819 GB/s) |
| 多 agent 並發(10–50 請求) | 算力 + 頻寬混合 | 良好 | 受頻寬限制 |
| 高並發 API 服務(100+ 請求) | 算力(1 petaFLOP) | 優秀 | 中等 |
| 長 prompt prefill | 算力 | 優秀 | 中等 |
Prefill 場景:DGX Spark 的另一個優勢
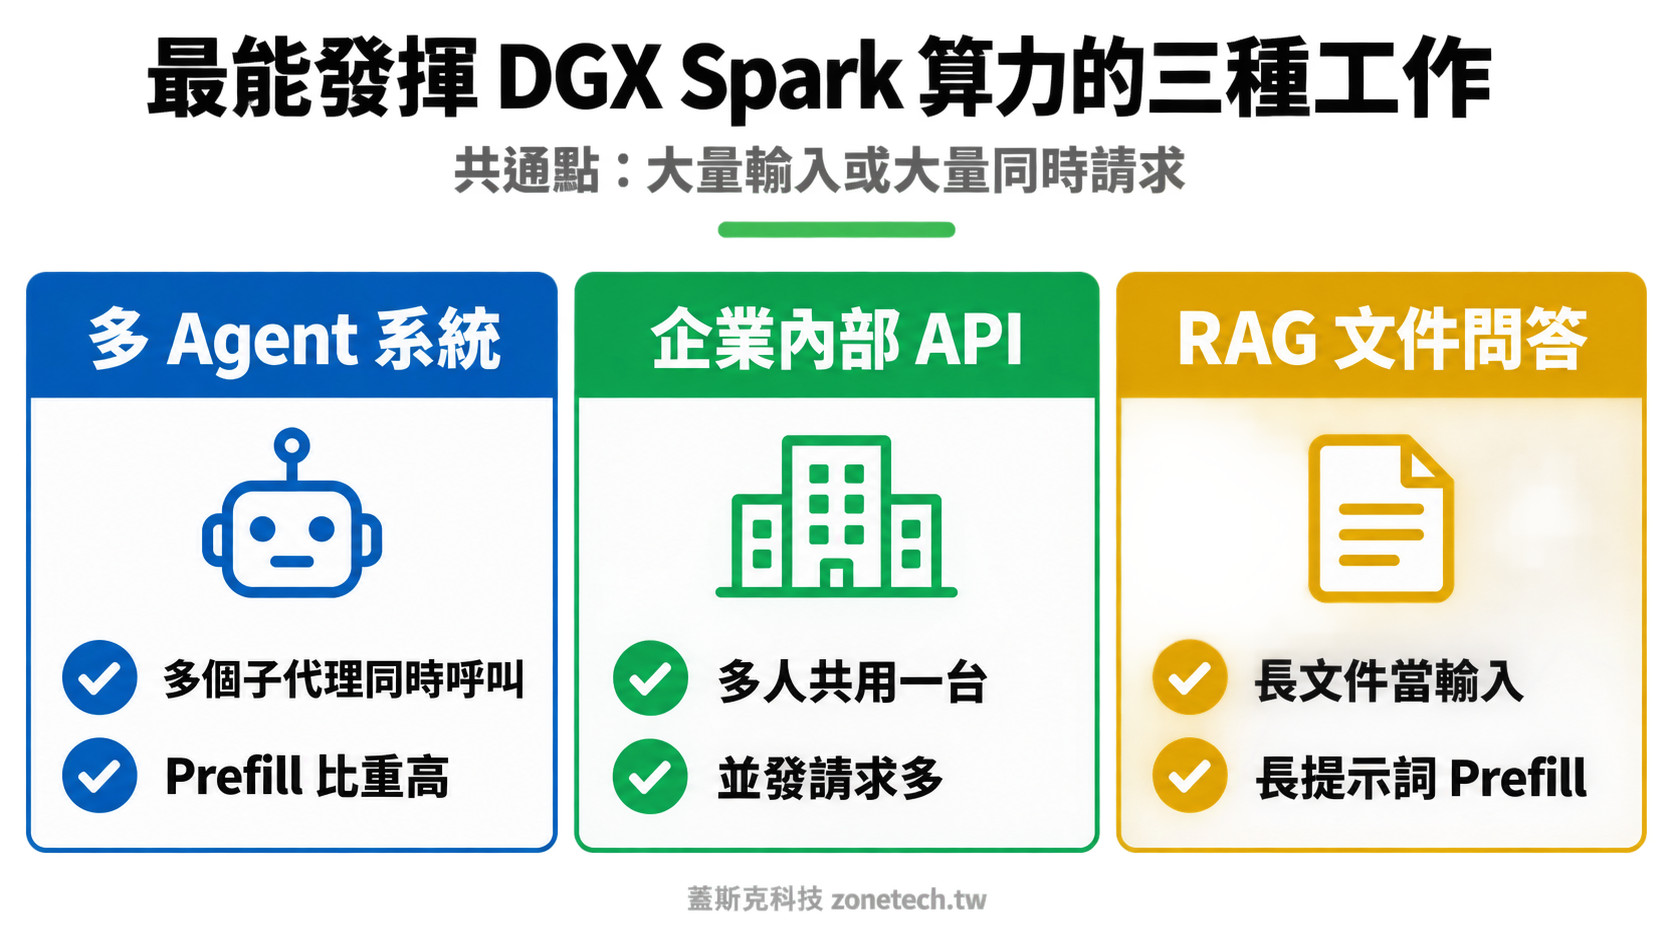
Prefill 是把輸入的 prompt 全部處理成 KV cache 的階段,這是計算密集的,算力決定速度。當你的應用有長 system prompt、大量 context、文件分析時,DGX Spark 的 prefill 速度明顯快過 Mac Studio。
企業部署怎麼評估
如果你要用 DGX Spark 作為企業內部的 AI API 伺服器,公開評測的並發數字只能當參考,實際容量取決於模型大小和 prompt 長度:
- 先用自己的工作負載壓測:用實際的 prompt 長度和同時連線數跑一次,看總吞吐量和單一請求延遲(機型怎麼挑見 地端 LLM 主機大車拼)
- 1 台先給小團隊試用:確認模型品質和延遲可以接受
- 要更大模型或更多人同時用再擴充:2 台、4 台用 tensor parallel 分攤
結論
如果你的應用是單個用戶的私人 AI 助手,Mac Studio 或雲端 API 在速度體驗上更好。如果你在建 multi-agent 系統、企業內部 API 服務、或需要高並發的 RAG 管道,DGX Spark 1 petaFLOP 的算力在這裡才能充分發揮。選擇硬體之前,先確認你的工作負載是「單串」還是「並發」,再做決定。
立即開始:用你自己的工作負載做決定
蓋斯克科技協助企業用實際工作負載評估地端 AI 主機,不用規格表決定採購。
我們提供:
- 依併發人數與 prompt 長度估算需求
- 推論框架選擇與併發參數調校
- 多台擴充的時機與方式
- 企業內部 API 服務的網路與權限設計
關於作者
黃俊凱 Gask Hung|蓋斯克科技創辦人,曾任 D-Link 網路研發工程師、QNAP 雲端儲存應用工程師/專案經理,近期投入地端 LLM 導入評估。完整作者介紹
延伸閱讀:買一台還是兩台?DGX Spark 1x vs 2x 效能對決|DGX Spark 最佳模型推薦:1x / 2x / 4x 配置清單|DGX Spark 雙機怎麼接?ConnectX-7 200G 網路設定|地端 LLM 主機大車拼:DGX Spark vs Mac vs RTX 5090