
DGX Spark 雙機怎麼接?ConnectX-7 200G 網路設定、實測頻寬與叢集接線指南
DGX Spark 的 ConnectX-7 每個 QSFP 埠會拆成兩個網路介面,兩條路徑都設 IP、分不同網段才跑得出接近 200G。整理 NVIDIA 官方設定、麗臺實測頻寬與社群叢集接線經驗。
DGX Spark 台灣完整購買指南(2026 更新):哪裡買、多少錢、採購陷阱
DGX Spark 漲價 17.5% 後的台灣完整購買指南。比較原價屋、iCShop、ASUS 企業通路三大管道,說明台灣實際零售價(約 NT$199,000),以及 ARM64 相容性、散熱節流、DGX OS 只保固 2 年等採購前必知的三大陷阱。
買一台還是兩台?DGX Spark 1x vs 2x 效能對決:速度、模型、成本完整比較
DGX Spark 1 台或 2 台的選擇不是「越多越好」,而是取決於你能不能接受 DeepSeek V4.1 Flash 用 NVMe streaming 跑(15–32 tok/s)還是需要全 expert 常駐(32 tok/s + 600k context)。整理兩種配置的實測速度、可跑模型範圍、成本差距,讓你有具體數字做決定。
2026 年 9 月 DGX Spark 最佳模型推薦:1x / 2x / 4x 配置完整清單
DGX Spark 裝好了要跑什麼模型?2026 年 9 月最新推薦:單台首選 Qwen3.8-Flash-Next NVFP4(35–50 tok/s),兩台上 DeepSeek V4.1 Flash 完整版(32 tok/s + 600k context),四台跑 1M context 服務。按用途分類,包含程式碼、中文、數學、對話各場景的推薦選擇。
DGX Spark 並發效能被嚴重低估:256 並行連線下的真實 120x 吞吐量
所有 DGX Spark 評測都在測單串 token 生成速度,但這台機器的設計重點是並發吞吐量。在 256 並行連線下,DGX Spark 的實際吞吐量比單串評測高 120 倍。解釋算力 vs 記憶體頻寬的差別,以及什麼工作負載才能讓 1 petaFLOP 的算力有意義。
資安研究員的 DGX Spark 使用指南:本機 AI 在滲透測試與漏洞分析的五個實際用途
資安工作的核心矛盾:你需要最強的 AI 輔助,但你的工作內容最不能送上雲端。DGX Spark 解決了這個問題。整理五個資安場景的具體用途(漏洞程式碼分析、惡意軟體逆向、滲透測試報告、CTF 輔助、AI Agent 安全研究),以及每個任務需要的最低配置。
AI Agent 是什麼?從 LLM 到 Agent 的架構、工作模式與 MCP/A2A 協議完整解析
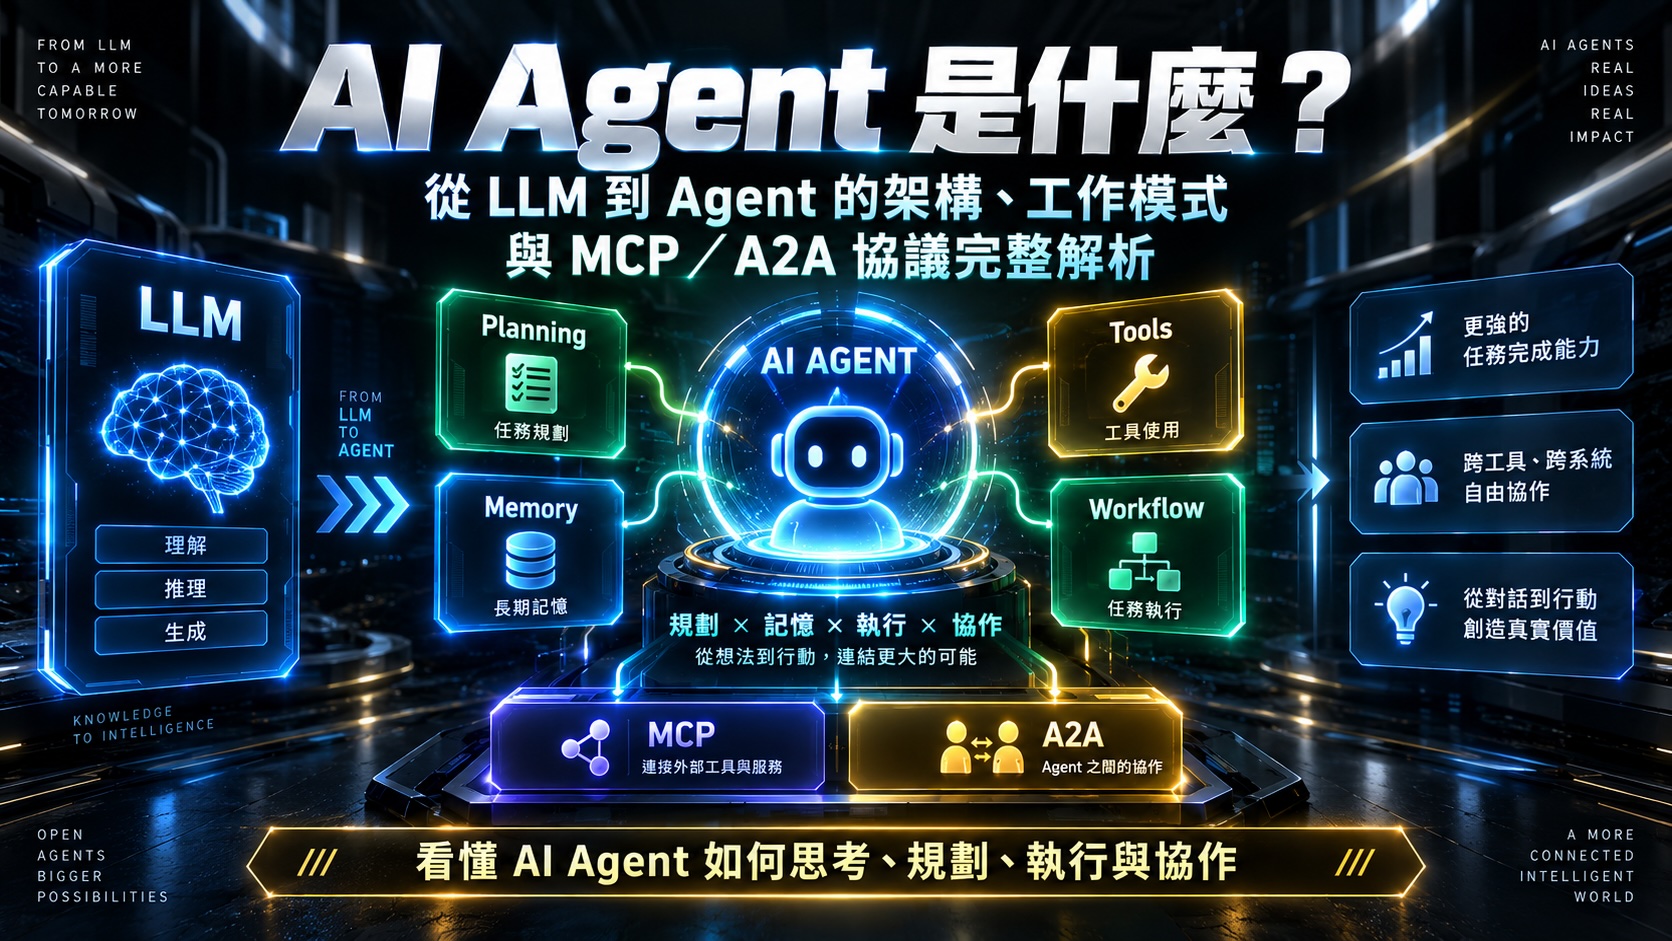
作者:Gask Hung|蓋斯克科技|最後更新:2026-09-04 過去兩年,很多公司買了 ChatGPT […]
一張 RTX PRO 6000 撐得起幾個人?單卡團隊 LLM 伺服器的並發、KV 快取與 PRO 5000 72GB 比較
一張 RTX PRO 6000 能給幾個人共用?整理社群實測:總吞吐與每人速度的差距、96GB 能放哪些模型、FP8 KV 快取與投機解碼設定,以及 RTX PRO 5000 72GB 能不能替代。
Mac Studio M5 Max/M5 Ultra 跑地端 LLM 實測整理:聊天夠快,跑 Agent 為什麼還是慢?
Mac Studio M5 Max 與 M5 Ultra 跑本地大模型到底多快?整理官方規格、台灣售價與社群實測:decode 跟著記憶體頻寬走,prefill 靠 Neural Accelerator 翻倍,並說明跑 Agent 變慢與多人共用的限制。
AI Agent Harness 怎麼選?Hermes、DeepSeek Harness、Codex、OpenCode 架構與社群實測比較(2026)
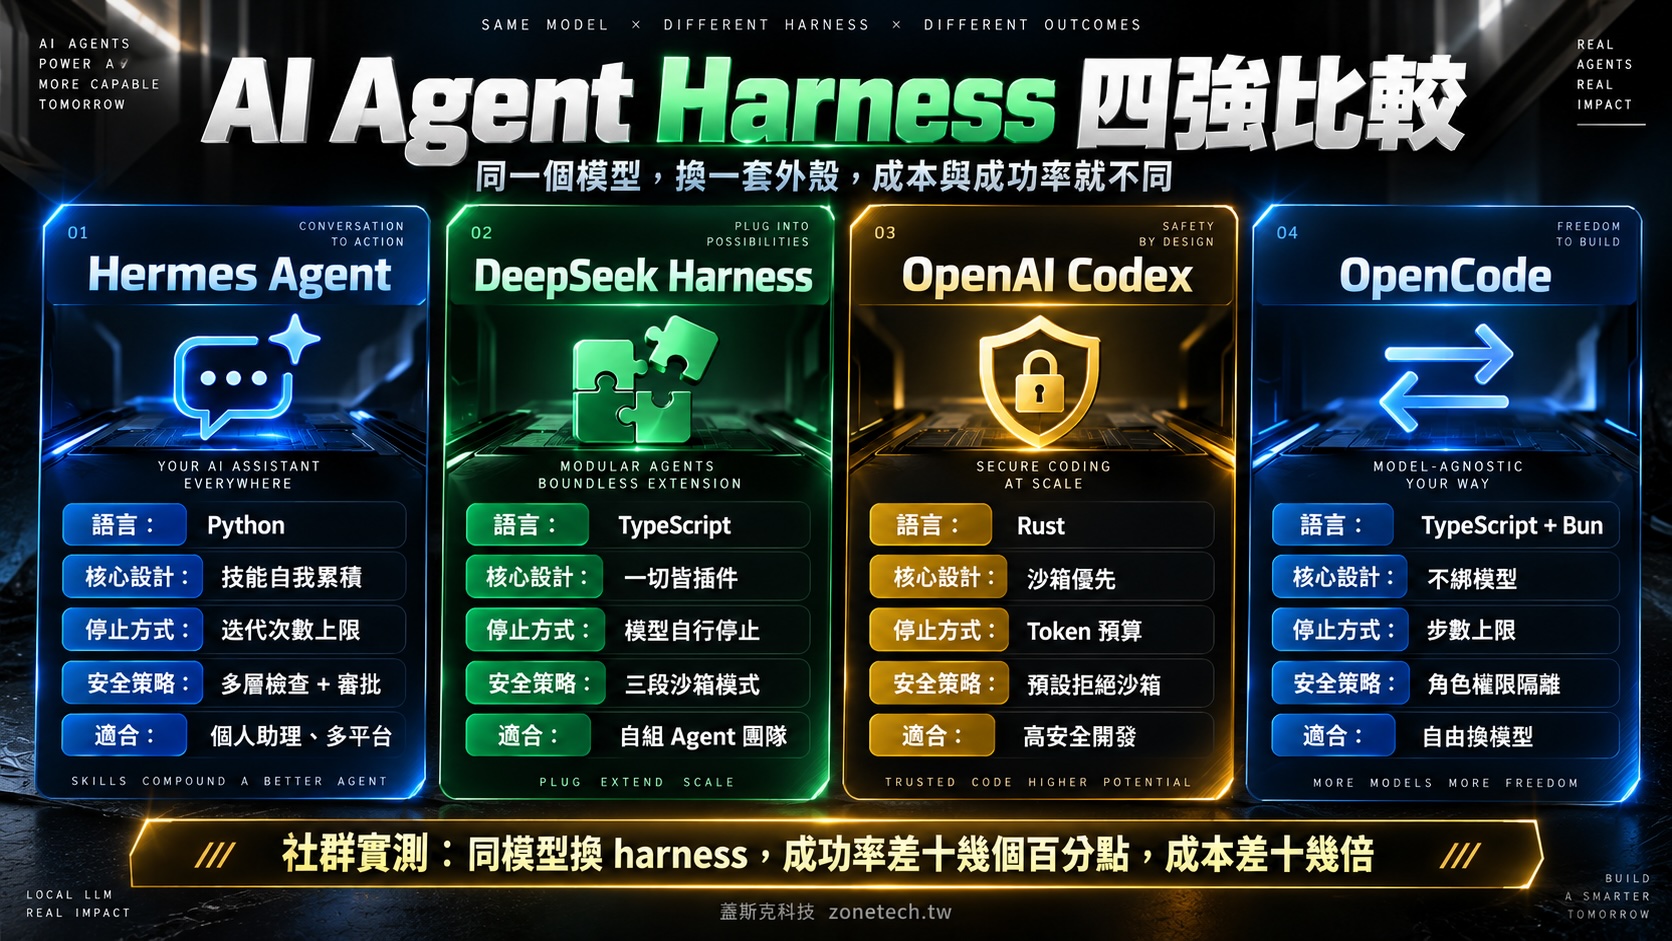
同一個模型換 harness,社群實測成功率差十幾個百分點、成本差十幾倍。比較 Hermes、DeepSeek Harness、Codex、OpenCode 的停止機制、上下文壓縮與資安風險。
單卡 vs 多卡:企業推理選型實戰比較(RTX PRO 6000 vs RTX 5090)
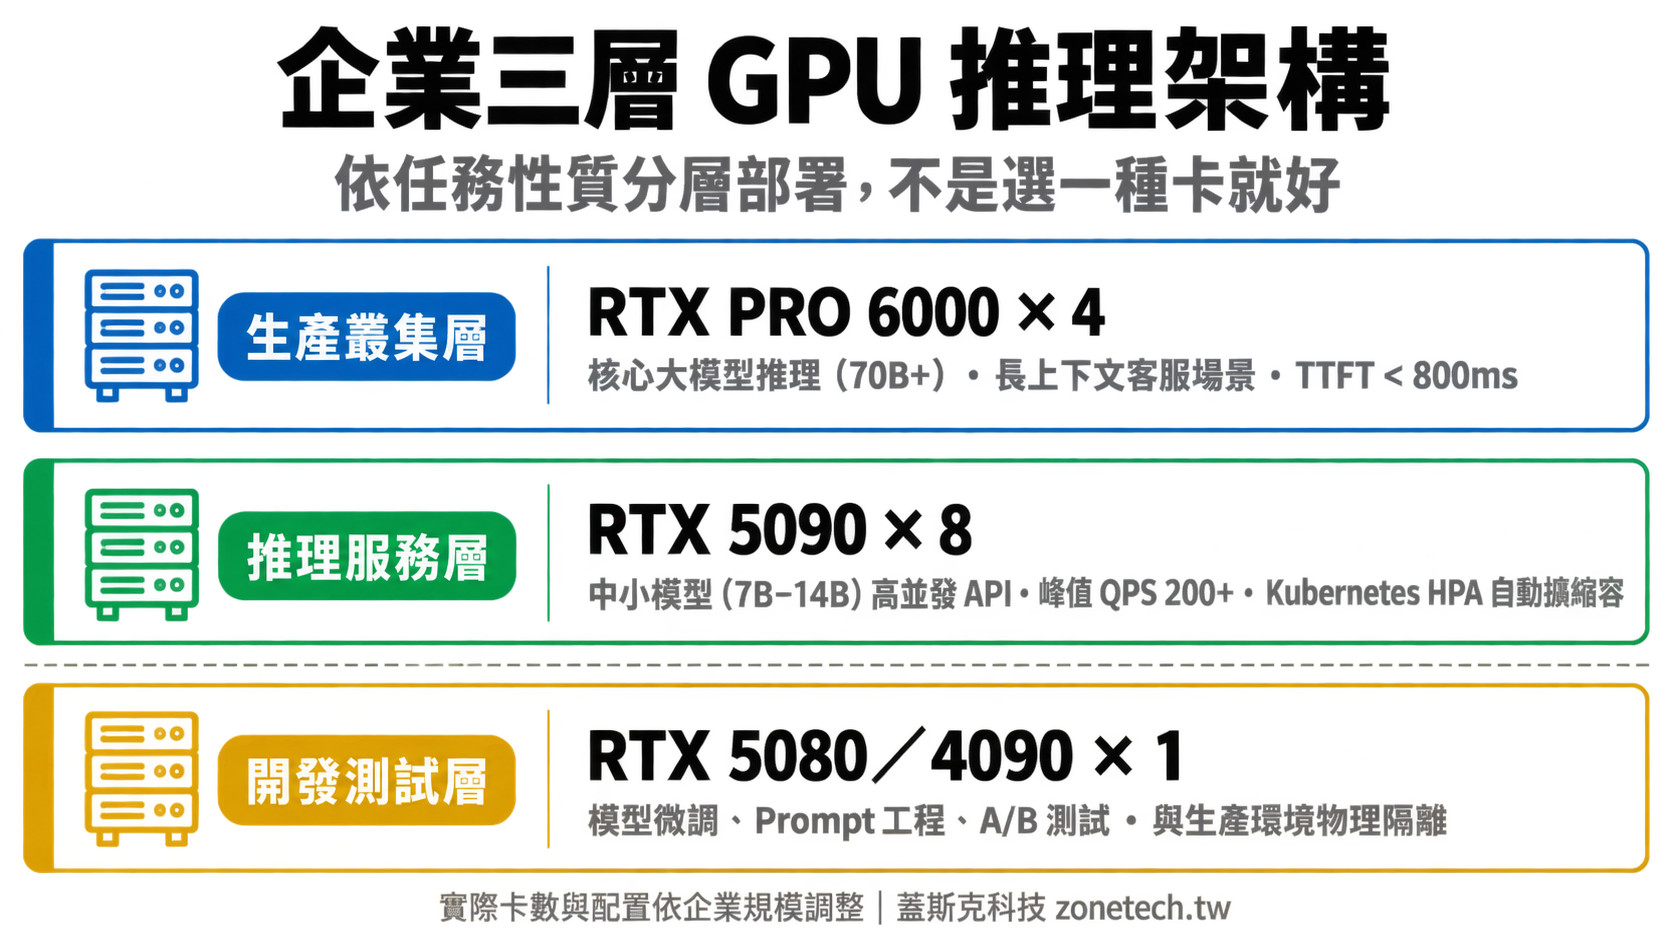
發布:2026-09-14|最後更新:2026-09-14 企業評估地端 LLM 推理架構時,很直覺會想「多幾 […]
地端 LLM 主機大車拼:DGX Spark 實測 vs Mac M5 Max vs AMD Strix Halo vs RTX 5090 自組(2026)
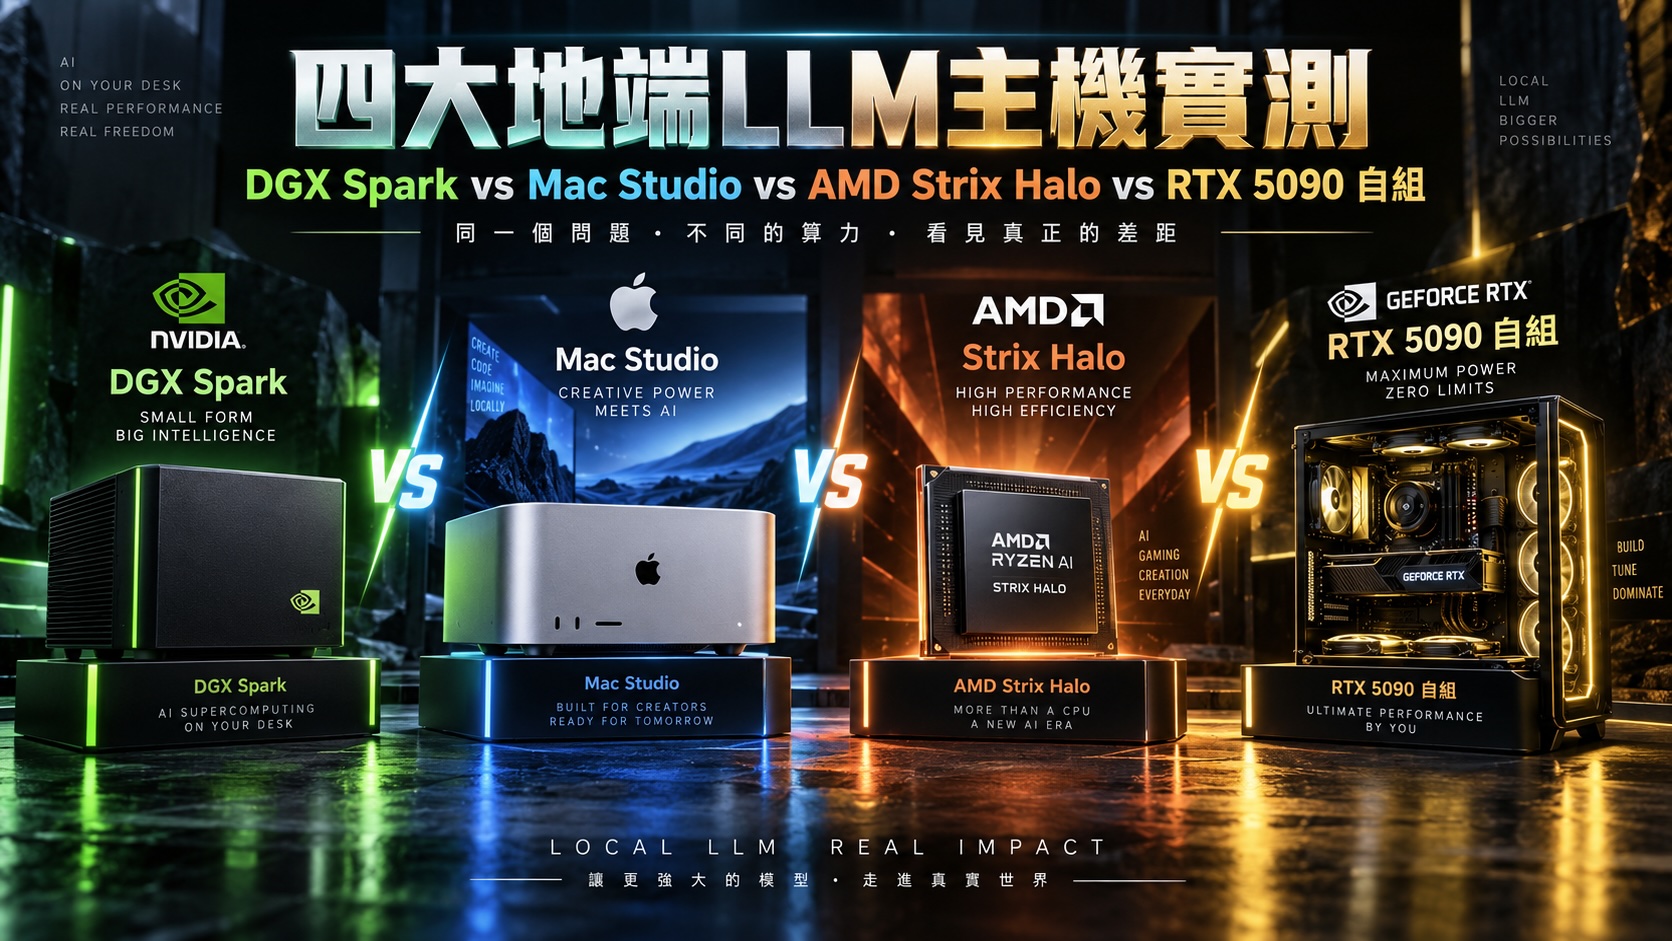
發布:2026-09-14|最後更新:2026-09-14 「128GB 統一記憶體」這幾個字,在 2026 […]